סימולציה של דינמיקת Bose-Hubbard עם בחירת קידוד
המדריך הזה בונה מעגל עבור הדינמיקה בזמן של מודל Bose-Hubbard החד-ממדי, מכתיבת ההמילטוניאן ועד בדיקת צפיפויות האתרים אחרי ההתפתחות מול הפניה מדויקת. מה שמעניין בדרך הזאת הוא רעיון אחד:
אל תבחרו קידוד מבוזונים ל-qubits כשאתם בונים את המעגל. בנו את המעגל על מודים בוזוניים, ותנו ל-transpiler להחליט איך המודים האלה הופכים ל-qubits.
עבור בוזונים, כמעט תמיד צריך לדחות את הקידוד. מוד בוזוני מכיל מספר שרירותי של חלקיקים, ולכן מרחב Fock שלו אינסוף-ממדי ואין קידוד עד שבוחרים תחילה קטימה (מספר רמות התפוסה שנשמרות). בקוד הקטימה ניתנת כתפוסה הגדולה ביותר שמוד יכול להכיל, max_occupation , ולכן מוד ששומר את הרמות הוא בעל max_occupation = 2 ו-.
זה הופך את הקטימה לפרמטר של הקידוד, לא של הפיזיקה, והיא פרמטר שרוצים לשנות: קטן מדי והתשובה שגויה, גדול מדי והמעגל רחב שלא לצורך. אם דוחים את הקידוד לזמן ה-transpile, אפשר לסרוק את הקטימה בלי לשנות את המעגל, את ההמילטוניאן או את הקיבוץ.
מדריך האופרטורים למבנה הנתונים של אופרטור, מדריך ה-mappers לקידודים ולמתכון לכתיבת mapper מותאם אישית, ומדריך ה-transpilation לשלבי ה-transpiler שמוזכרים לאורך כל הדרך.
קטימה, ומה היא עולה
כשקוטמים מוד ל- רמות, שוברים את יחס החילוף הקנוני ברמה הגבוהה ביותר שנשמרה [1], ולכן שום קידוד אינו איזומורפיזם של אלגברות: קידוד בוזוני ממפה מצבים, ואופרטורים שפועלים בתוך תת-המרחב הקטום. שתי השלכות חשובות לכל מה שיבוא אחר כך:
-
חייב לחסום את התפוסה שהדינמיקה יכולה להגיע אליה, ולא רק את זו של המצב ההתחלתי.
-
המיפוי אינו מתחלף עם סדר נורמלי, לכן החליטו פעם אחת אם ההמילטוניאן שלכם מוגדר בצורה מסודרת-נורמלית, והישארו עקביים.
מדריך ה-mappers מפיק את הפגם ומראה את שתי ההשלכות על קוד רץ.
1. ההמילטוניאן
מודל Bose-Hubbard על סריג עם קשרים הוא
עם . האינטראקציה סופרת זוגות של בוזונים באתר, ולכן היא דורשת שאתר יחזיק שני חלקיקים בו-זמנית. בסדר נורמלי, , וזו הצורה שבה נשתמש להלן.
הגיאומטריה נכנסת רק דרך רשימת הקשתות, כך שדבר אינו ספציפי לשרשרת:
>>> from qiskit_bosons.operators import BosonOperator, ann, cre
>>>
>>> def bose_hubbard(edges, num_sites, tunneling, interaction):
...     """Build the normal-ordered Bose-Hubbard Hamiltonian on an arbitrary lattice."""
...     terms = {}
...     for i, j in edges:
...         terms[(cre(i), ann(j))] = -tunneling
...         terms[(cre(j), ann(i))] = -tunneling
...     for i in range(num_sites):
...         # U/2 * n_i (n_i - 1), already normal-ordered
...         terms[(cre(i), cre(i), ann(i), ann(i))] = 0.5 * interaction
...     return BosonOperator.from_dict(terms)
>>>
>>> num_sites = 4
>>> edges = [(i, i + 1) for i in range(num_sites - 1)]
>>> hamiltonian = bose_hubbard(edges, num_sites, tunneling=1.0, interaction=2.0)
>>> print(f"Number of terms: {len(hamiltonian)}")
Number of terms: 10
כדאי לבדוק קודם שתי תכונות. ההמילטוניאן חייב להיות הרמיטי כדי ש- יהיה אוניטרי, והוא משמר את מספר הבוזונים הכולל:
>>> hamiltonian.is_hermitian()
True
>>> hamiltonian.conserves_particle_number()
True
עכשיו השאלה הבוזונית: כמה רמות האופרטור הזה דורש?
>>> hamiltonian.max_occupation()
2
איבר האינטראקציה מפעיל שני אופרטורי יצירה על מוד אחד, ולכן מוד צריך להחזיק שני בוזונים כדי שהאיבר יפעל בכלל. זו תפוסה מרבית של 2, והיא המספר ש-LevelSpec מקבל בתור max_occupation שלו. מוד ששומר את התפוסות הוא בעל רמות, ולכן max_occupation >= 2 היא אותה דרישה כמו .
זה חסם תחתון בלבד: הוא נובע מהפעלה אחת של האופרטור, והפעלה חוזרת לאורך התפתחות בזמן יכולה להגיע רחוק יותר. הוא פוסל קטימות שבוודאות קטנות מדי, ושלב 6 קובע, עבור המודל והמצב הזה, עד כמה הקטימה צריכה להיות גדולה. mode_occupations() מדווח את החסם לכל מוד בנפרד, וזה מה שמשווים אליו קטימה לכל מוד.
2. קיבוץ לפני מיפוי
ההתפתחות מבוצעת בשיטת Trotter, והאופן שבו ההמילטוניאן מחולק קובע מה מועבר לסינתזה. שתי שיקולים מושכים לאותו כיוון.
ראשית, שיקול פיזיקלי: איבר ה-hopping הבודד אינו הרמיטי. רק הזוג הרמיטי. אם מפתחים תחת איבר בודד לא הרמיטי, הפעולה אינה אוניטרית, והאופרטור הממופה היה נושא מקדמים מרוכבים ש-PauliEvolutionGate דוחה. לכן שני איברי ה-hopping של כל קשר חייבים להישאר יחד.
שנית, שיקול של יעילות: כל איברי האינטראקציה באתר אלכסוניים בבסיס התפוסה ומתחלפים זה עם זה, ולכן אפשר שיחלקו קבוצה אחת ויסונתזו יחד. אותו דבר נכון לקשרים שאינם נוגעים באף אתר משותף. בשרשרת, כל קשר שני הוא קבוצה כזאת: קשרים 0 ו-2 פועלים על זוגות מודים זרים, ולכן איברי ה-hopping שלהם מתחלפים ויכולים לחלוק קבוצה, וקשר 1 יוצר קבוצה משלו. אם מקבצים את הקשרים הזוגיים ואת האי-זוגיים, אתם צריכים אפוא שלוש קבוצות, כשקבוצה לכל קשר דורשת ארבע. פחות קבוצות פירושו פחות גורמים, וגם מעגל רדוד יותר: עם קוד Gray ב-max_occupation = 2 העומק של שני qubits הוא 95 לעומת 139. הסריג קובע אילו קשרים יכולים לחלוק קבוצה, ולכן החלוקה נבחרת כאן.
התכונה groups נושאת את ההחלטה הזאת אל תוך המעגל: שער Evolution על אופרטור מקובץ מתפרק להתפתחות-משנה אחת לכל קבוצה. החלוקה נבחרת ברמה הבוזונית, בעוד מבנה הסריג עדיין נראה, והיא שורדת ללא שינוי לאורך המיפוי. מדריך הקיבוץ מכסה את הבדיקות שקיבוץ צריך לעבור.
>>> def group_of(actions, edges):
...     """Assign each term to the even bonds, the odd bonds, or the on-site group."""
...     creations = sorted(mode for action, mode in actions if action)
...     annihilations = sorted(mode for action, mode in actions if not action)
...     if creations == annihilations:
...         return 2  # diagonal: the on-site interaction group
...     bond = tuple(sorted(set(creations) | set(annihilations)))
...     return edges.index(bond) % 2  # bonds 0 and 2 share a group, bond 1 has its own
>>>
>>> hamiltonian.groups = [group_of(actions, edges) for actions, _ in hamiltonian.iter_terms()]
>>> hamiltonian.num_groups()
3
כל קבוצה חייבת להיות הרמיטית בעצמה, וזה מה שהזיווג הקודם קונה. groups_are_hermitian() בודק את כל הקבוצות בקריאה אחת:
>>> from qiskit_bosons.operators.terms import groups_are_hermitian
>>> groups_are_hermitian(hamiltonian)
[True, True, True]
כדי לראות מה כל קבוצה מכילה, הפרידו את הקבוצות:
>>> for index, group in enumerate(hamiltonian.split_out_groups()):
...     print(f"group {index}: {len(group)} terms, hermitian={group.is_hermitian()}")
group 0: 4 terms, hermitian=True
group 1: 2 terms, hermitian=True
group 2: 4 terms, hermitian=True
הקיבוץ לזוגי ואי-זוגי הוא בחירה, ואת החלופה קל למדוד. אם נותנים לכל קשר קבוצה משלו, צריך ארבע קבוצות, ואז אותו מעגל עולה יותר עומק של שני qubits. העומק נספר אחרי שהמעגל מונמך עם קוד Gray ב-max_occupation = 2, כפי ששלב 4 מסביר:
>>> from qiskit.transpiler import PassManager
>>> from qiskit_bosons.circuit import BosonicCircuit
>>> from qiskit_bosons.circuit.library import Evolution
>>> from qiskit_bosons.mappers import LevelSpec
>>> from qiskit_bosons.transpiler.presets import generate_preset_occupation_pass_manager
>>>
>>> def two_qubit_depth(operator):
...     """The two-qubit depth of one evolution under ``operator``, lowered with the Gray code."""
...     probe = BosonicCircuit(num_sites)
...     probe.append(Evolution(num_sites, operator, time=0.4), probe.modes)
...     pass_manager = generate_preset_occupation_pass_manager(LevelSpec(2, "gray"))
...     pass_manager.qubit = PassManager()
...     lowered = pass_manager.run(probe.decompose())
...     return lowered.decompose(reps=6).depth(lambda instruction: len(instruction.qubits) == 2)
>>>
>>> per_bond = bose_hubbard(edges, num_sites, tunneling=1.0, interaction=2.0)
>>> per_bond.groups = [
...     len(edges) if sorted(m for a, m in actions if a) == sorted(m for a, m in actions if not a)
...     else edges.index(tuple(sorted({m for _, m in actions})))
...     for actions, _ in per_bond.iter_terms()
... ]
>>> per_bond.num_groups(), two_qubit_depth(per_bond)
(4, 139)
>>> hamiltonian.num_groups(), two_qubit_depth(hamiltonian)
(3, 95)
3. המעגל הבוזוני
שימו לב למה שחסר במעגל. אין בו קטימה, אין קידוד ואין מספר qubits. הוא פועל על ארבעה מודים בוזוניים:
>>> from qiskit_bosons.circuit import BosonicCircuit
>>> from qiskit_bosons.circuit.library import Evolution, InitializeModes
>>>
>>> total_time = 0.4
>>> occupation = [1, 1, 0, 0]  # one boson on each of the first two sites
>>>
>>> circuit = BosonicCircuit(num_sites)
>>> circuit.append(InitializeModes(occupation), circuit.modes)
>>> circuit.append(Evolution(num_sites, hamiltonian, time=total_time), circuit.modes)
>>> dict(circuit.count_ops())
{'InitializeModes': 1, 'Evolution': 1}

החוטים הם מודים בוזוניים, לא qubits. שימו לב ש-InitializeModes מקבל מספרים שלמים, לא דגלים: מוד יכול להחזיק כל מספר של בוזונים, ולכן מצב Fock הוא רשימה של מספרי תפוסה.
קריאה אחת ל-decompose() הופכת את הקיבוץ משלב 2 לשער אחד לכל קבוצה:
>>> decomposed = circuit.decompose()
>>> dict(decomposed.count_ops())
{'Evolution': 3, 'InitializeModes': 1}
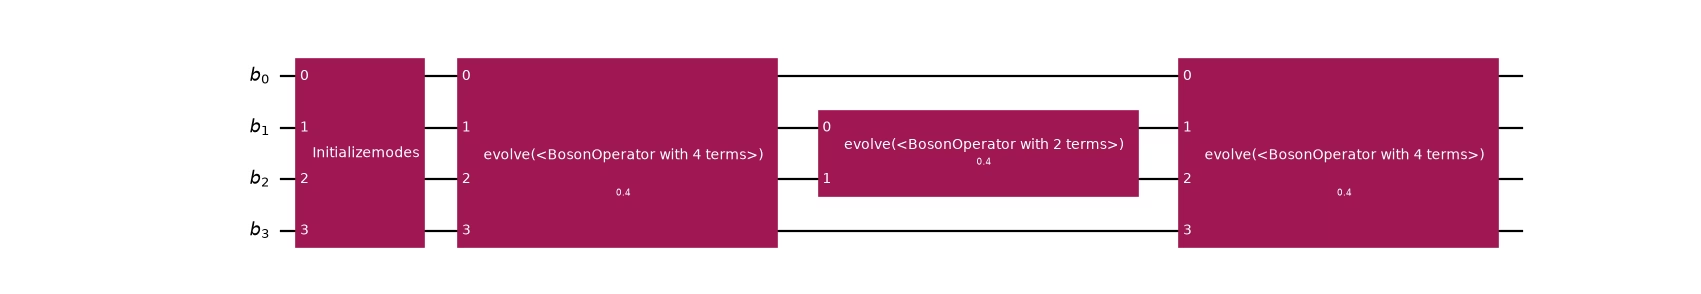
הקבוצה הראשונה מכילה את הקשרים על מודים 0 ו-1 ועל מודים 2 ו-3, ולכן השער שלה פורש את כל ארבעת המודים, וכך גם קבוצת האתר. לקשר האמצעי יש שער משלו על מודים 1 ו-2.
אם מדלגים על הפירוק הזה, הקיבוץ פשוט מתעלמים ממנו. השיטה שמבצעת את הפיצול היא ה-synthesis של השער, כש-BosonicLieTrotter הוא ברירת המחדל; סינתזה של שער Evolution במרחב בוזוני מראה את החלופות.
4. בחירת הקידוד בזמן ה-transpile
הנה התמורה. אותו מעגל מונמך ארבע פעמים, תחת ארבעה ערכי LevelEncoding שונים, על ידי שינוי ארגומנט אחד. LevelSpec מזווג את הקידוד עם הקטימה של כל מוד, וה-preset הבא גוזר את הפריסה, את הכנת המצב ואת מיפוי האופרטור מאותה מפרט אחד (ראו תיאור הקטימה עם LevelSpec). מחרוזת כמו "gray" מתקבלת בכל מקום שבו מתקבל LevelEncoding.
>>> from qiskit.transpiler import PassManager
>>> from qiskit_bosons.mappers import LevelEncoding, LevelSpec
>>> from qiskit_bosons.transpiler.presets import generate_preset_occupation_pass_manager
>>>
>>> max_occupation = 2  # the largest occupation per mode, so d = max_occupation + 1 = 3 levels
>>>
>>> encodings = (
...     LevelEncoding.UNARY_PROJECTED,
...     LevelEncoding.UNARY_UNPROJECTED,
...     LevelEncoding.STANDARD_BINARY,
...     LevelEncoding.GRAY,
... )
>>> for encoding in encodings:
...     pass_manager = generate_preset_occupation_pass_manager(
...         LevelSpec(max_occupation, encoding)
...     )
...     pass_manager.qubit = PassManager()  # keep the circuit as the pipeline synthesized it
...     qubit_circuit = pass_manager.run(decomposed)
...     basis = qubit_circuit.decompose(reps=6)
...     two_qubit = basis.depth(lambda instruction: len(instruction.qubits) == 2)
...     print(f"{encoding!s:18s} qubits={qubit_circuit.num_qubits:2d}  2q-depth={two_qubit:4d}")
unary_projected    qubits=12  2q-depth= 645
unary_unprojected  qubits=12  2q-depth= 383
standard_binary    qubits= 8  2q-depth= 218
gray               qubits= 8  2q-depth=  95
המספרים האלה סותרים ניחוש טבעי. הקידודים האונריים משתמשים ב- qubits לכל מוד לעומת לקודים הקומפקטיים, וב- הקודים הקומפקטיים מנצחים בשני הצירים בו-זמנית: פחות qubits והרבה פחות שערי הסתבכות. שני הווריאנטים האונריים נבדלים באופרטור שהם פולטים, לא בפריסה שלהם: LevelEncoding.UNARY_PROJECTED נושא היטל על כל qubit שני של מוד, מה שהופך אותו ליקר ביותר להתפתחות מבין הארבעה, ו-LevelEncoding.UNARY_UNPROJECTED משאיר את ההיטלים בחוץ ומסכים איתו על תת-המרחב של one-hot. מדריך ה-mappers מראה את שני האופרטורים זה לצד זה, ומסביר למה קוד Gray מנצח את הבינארי הסטנדרטי (SB) באיברי ה-hopping.
Sawaya ואחרים מדווחים על אותו סדר [2]:
אף שקוד אונרי נוטה לדרוש יותר qubits אך פחות פעולות, לעיתים קרובות קוד SB או קוד Gray יעילים יותר, הן במספר ה-qubits והן במספר הפעולות
המסקנה שלהם היא שהקוד הטוב ביותר תלוי בהמילטוניאן וב-, וזה הטיעון החזק ביותר נגד קיבוע הבחירה במעגל.
תחת קידוד רמות מוד פורש כמה qubits, ולכן אוגר ה-qubits רחב יותר מאוגר המודים. ה-preset משתמש ב-OccupationB2QLayout, שגוזר את רוחב האוגר מ-LevelSpec. מדריך ה-transpilation עובר על השלבים שה-preset מריץ.
5. אימות מול דינמיקה מדויקת
אף אחד מהשלבים הקודמים אינו מבסס שהמעגל נכון. בשביל זה, משווים את צפיפויות האתרים אחרי ההתפתחות מול הפניה מדויקת שחושבה על ההמילטוניאן המקודד.
ההפניה חייבת להיות מחושבת באותו מרחב קטום שבו המעגל עובד, כי השוואה מול חישוב לא קטום תבלבל בין שגיאת Trotter לשגיאת קטימה, שהן דברים שונים ושווה להפריד ביניהם (ראו קטימת מרחב Fock).
>>> import numpy as np
>>> from qiskit.quantum_info import SparsePauliOp, Statevector
>>> from scipy.sparse.linalg import expm_multiply
>>> from qiskit_bosons.mappers.library import occupation_encoding
>>>
>>> def sparse_matrix(operator, encoding):
...     """Map a bosonic operator and hand back a sparse qubit matrix."""
...     spec = LevelSpec(max_occupation, encoding).resolve(num_sites)
...     observable = occupation_encoding(operator, spec)
...     return SparsePauliOp.from_sparse_observable(observable).to_matrix(sparse=True)
>>>
>>> def fock_index(occupation, encoding):
...     """The computational basis index encoding a product Fock state."""
...     spec = LevelSpec(max_occupation, encoding).resolve(num_sites)
...     return sum(
...         encoding.level_to_bits(n) << offset for n, offset in zip(occupation, spec.offsets)
...     )
>>>
>>> def densities(state, encoding):
...     """The per-site boson number <n_m> of an encoded state vector."""
...     out = []
...     for mode in range(num_sites):
...         number = BosonOperator.from_dict({(cre(mode), ann(mode)): 1.0})
...         matrix = sparse_matrix(number, encoding)
...         out.append(float((state.conj() @ (matrix @ state)).real))
...     return out
עם אלה ביד, ההתפתחות המדויקת במרחב הקטום:
>>> encoding = LevelEncoding.GRAY
>>> num_qubits = LevelSpec(max_occupation, encoding).resolve(num_sites).total_width
>>>
>>> initial = np.zeros(2**num_qubits, dtype=complex)
>>> initial[fock_index(occupation, encoding)] = 1.0
>>>
>>> evolved_exact = expm_multiply(
...     -1j * total_time * sparse_matrix(hamiltonian, encoding), initial
... )
>>> reference = densities(evolved_exact, encoding)
>>> for site, value in enumerate(reference):
...     print(f"site {site}: {value:.6f}")
site 0: 0.993834
site 1: 0.858853
site 2: 0.141309
site 3: 0.006004
הבוזונים מתפשטים מהקצה התפוס של השרשרת לעבר הריק, ושני הבוזונים נשמרים:
>>> bool(np.isclose(sum(reference), 2.0))
True
עכשיו המעגל. שימו לב שההפניה הקודמת נבנתה מ-initial ישירות, ולכן המעגל שמושווה אליה חייב להכיל רק את ההתפתחות, כי השער InitializeModes היה מכין מחדש מצב שכבר הוכן.
>>> from qiskit_bosons.circuit.library.synthesis import BosonicLieTrotter
>>>
>>> def trotter_densities(steps, encoding):
...     """Site densities after `steps` first-order Trotter steps of the grouped evolution."""
...     circuit = BosonicCircuit(num_sites)
...     circuit.append(
...         Evolution(
...             num_sites, hamiltonian, time=total_time, synthesis=BosonicLieTrotter(reps=steps)
...         ),
...         circuit.modes,
...     )
...     pass_manager = generate_preset_occupation_pass_manager(
...         LevelSpec(max_occupation, encoding)
...     )
...     qubit_circuit = pass_manager.run(circuit.decompose())
...     # decompose BEFORE evolving: see the warning that follows
...     basis = qubit_circuit.decompose(reps=6)
...     state = np.asarray(Statevector(initial).evolve(basis).data)
...     return densities(state, encoding)
>>>
>>> for steps in (1, 2, 4, 8, 16):
...     error = max(
...         abs(a - b) for a, b in zip(trotter_densities(steps, encoding), reference)
...     )
...     print(f"steps={steps:2d}  max density error = {error:.4f}")
steps= 1  max density error = 0.0843
steps= 2  max density error = 0.0389
steps= 4  max density error = 0.0183
steps= 8  max density error = 0.0088
steps=16  max density error = 0.0043
השגיאה מצטמצמת בחצי כשמספר הצעדים מוכפל, וזו החתימה של נוסחת מכפלה מסדר ראשון. זו הראיה לכך שהפער הוא שגיאת Trotter והקידוד נאמן.
החזרות מגיעות מה-synthesis של השער, שמבצע Trotterization במרחב הבוזוני שבו הקיבוץ עדיין קיים: כל צעד מפעיל כל קבוצה פעם אחת, והצעדים באים בזה אחר זה. זה שונה מהעברת LieTrotter עם reps > 1 לתוסף הסינתזה ברמת ה-qubits. שם, כל קבוצה היא כבר PauliEvolutionGate משלה, ולכן הנוסחה רק מחלקת את האיברים בתוך קבוצה ולעולם לא משלבת את הקבוצות. הקבוצות אינן מתחלפות זו עם זו, ולכן נשאר צעד Trotter חיצוני יחיד ששגיאתו אינה קטנה לא משנה כמה גדול reps. סינתזה של שער Evolution במרחב בוזוני משווה בין השניים ומכסה סדרים גבוהים יותר.
הקריאה הקודמת ל-decompose() חיונית. evolve() משתמש בהגדרה המדויקת של PauliEvolutionGate ועוקף את נוסחת המכפלה לגמרי. אם מאמתים מול מעגל שלא פורק, רואים התאמה כמעט מושלמת גם עבור סינתזה שגויה בכוונה. המעגל שלא פורק גם גורם לבניית אופרטור צפוף של , ואילו מעגל מפורק מפעיל שערים אחד אחד. סימולטורים אחרים יכולים להתייחס לשער אחרת, ולכן הבדיקה הזאת תלויה בסימולטור, ואילו חומרה תמיד צריכה את הצורה המפורקת.
לבסוף, הבדיקה המרכזית: הפיזיקה לא יכולה להיות תלויה באיזה קידוד נבחר.
>>> def exact_densities(encoding):
...     """Exact truncated-space densities, computed under a given encoding."""
...     width = LevelSpec(max_occupation, encoding).resolve(num_sites).total_width
...     start = np.zeros(2**width, dtype=complex)
...     start[fock_index(occupation, encoding)] = 1.0
...     evolved = expm_multiply(
...         -1j * total_time * sparse_matrix(hamiltonian, encoding), start
...     )
...     return densities(evolved, encoding)
>>>
>>> all(
...     bool(np.allclose(exact_densities(name), reference, atol=1e-10))
...     for name in encodings
... )
True
מספרי ה-qubits, מבני Pauli ועומקי המעגלים כולם שונים, והפיזיקה מסכימה עד עשר ספרות אחרי הנקודה. הקידוד הוא בחירת מימוש, וזו הסיבה שהוא שייך ל-transpiler. שני הווריאנטים האונריים מסכימים כאן כי המצב המסומלץ נשאר על תת-המרחב של one-hot; מחוץ לו הם היו נבדלים.
6. קטימה היא פרמטר התכנסות
השלב האחרון ספציפי לבוזונים. עד כה כל מה שנעשה קבע max_occupation = 2, כלומר . עם זאת, הקטימה אינה בחירה חופשית: היא פרמטר התכנסות, ותשובה אמינה רק אחרי שהיא מפסיקה לזוז (ראו קטימת מרחב Fock).
המעגל לא נושא קטימה, ולכן המעגל עצמו אינו משתנה כשהחיתוך משתנה: רק ה-transpilation חוזר. מה שמשתנה הוא גודל מה שיוצא, וסריקה זולה כל כך רק בגלל שהמערכת זעירה. ההפניה הבאה היא סימולציה קלאסית מדויקת של הדינמיקה הקטומה, דבר אפשרי לארבעה אתרים ושגדל אקספוננציאלית עם מספר ה-qubits. בבעיה שמעבר להישג יד זה אין הפניה מדויקת להשוות אליה, וההתכנסות צריכה להישפט באמצעים אחרים.
>>> def densities_at_cutoff(max_occ, encoding=LevelEncoding.GRAY):
...     """Exact truncated-space densities at a given cutoff."""
...     spec = LevelSpec(max_occ, encoding).resolve(num_sites)
...
...     start = np.zeros(2**spec.total_width, dtype=complex)
...     start[
...         sum(encoding.level_to_bits(n) << offset for n, offset in zip(occupation, spec.offsets))
...     ] = 1.0
...
...     def matrix(operator):
...         observable = occupation_encoding(operator, spec)
...         return SparsePauliOp.from_sparse_observable(observable).to_matrix(sparse=True)
...
...     evolved = expm_multiply(-1j * total_time * matrix(hamiltonian), start)
...     out = []
...     for mode in range(num_sites):
...         number = BosonOperator.from_dict({(cre(mode), ann(mode)): 1.0})
...         out.append(float((evolved.conj() @ (matrix(number) @ evolved)).real))
...     return out
>>>
>>> previous = None
>>> for max_occ in (1, 2, 3, 4):
...     current = densities_at_cutoff(max_occ)
...     # Report the drift bucketed rather than to full precision: after it reaches machine
...     # epsilon, the exact digits are arithmetic noise and vary between BLAS builds.
...     if previous is None:
...         drift = "--"
...     else:
...         gap = max(abs(a - b) for a, b in zip(current, previous))
...         drift = f"{gap:.0e}" if gap > 1e-12 else "< 1e-12"
...     print(f"d={max_occ + 1}  "
...           + " ".join(f"{x:.6f}" for x in current)
...           + f"   drift={drift}")
...     previous = current
d=2  0.993986 0.858173 0.141827 0.006014   drift=--
d=3  0.993834 0.858853 0.141309 0.006004   drift=7e-04
d=4  0.993834 0.858853 0.141309 0.006004   drift=< 1e-12
d=5  0.993834 0.858853 0.141309 0.006004   drift=< 1e-12
ב-max_occupation = 1 () כל אתר מחזיק לכל היותר בוזון אחד, ולכן איבר האינטראקציה, שצריך שניים באתר, לא יכול לפעול בכלל, והצפיפויות סוטות בכ-. כשמוסיפים את הרמה השלישית, התוצאה לוכדת את האינטראקציה, ומ-max_occupation = 3 והלאה התוצאה נייחת עד דיוק מכונה: התכנסה.
הסיבה שזה נעצר ב-max_occupation = 2 היא מספר החלקיקים. ההמילטוניאן משמר את מספר הבוזונים, והמצב הזה מחזיק שניים, ולכן אף אתר לא יכול להחזיק אי פעם יותר משניים, לא משנה זמן ההתפתחות ולא אם האינטראקציה דוחה או מושכת. אם מפתחים עד במקום , או הופכים את סימן , הצפיפויות ב-max_occupation = 2 ומעלה נשארות ללא שינוי עד .
מה שכן מעלה את הדרישה הוא מספר הבוזונים. שלושה בוזונים על אותה שרשרת משתנים בכ- בין max_occupation = 2 ל-3 אחרי אותה התפתחות קצרה, ובכ- אחרי . זו אמירה על המודל הזה ועל גודל משומר, והיא חסם רק לאופרטורים ששומרים על מספר החלקיקים; זה לא כלל כללי, ולכן צריך לסרוק את החיתוך ולא לנחש אותו.
לסריקה יש מחיר גם בצד המעגל, וזה מה שההפניה המדויקת לא מראה. אותו מעגל בוזוני, מונמך עם קוד Gray בכל חיתוך:
>>> for max_occ in (1, 2, 3, 4):
...     pass_manager = generate_preset_occupation_pass_manager(
...         LevelSpec(max_occ, LevelEncoding.GRAY)
...     )
...     pass_manager.qubit = PassManager()
...     lowered = pass_manager.run(decomposed)
...     depth = lowered.decompose(reps=6).depth(lambda instruction: len(instruction.qubits) == 2)
...     print(f"d={max_occ + 1}  qubits={lowered.num_qubits:2d}  2q-depth={depth:4d}")
d=2  qubits= 4  2q-depth=   8
d=3  qubits= 8  2q-depth=  95
d=4  qubits= 8  2q-depth= 217
d=5  qubits=12  2q-depth=1176
כל רמה נוספת עולה בעומק, ומספר ה-qubits קופץ בכל פעם ש- עובר חזקה של שתיים. כשמתכנסים ב-, אתם סוחרים אפוא דיוק בגודל מעגל, ולכן הסריקה היא יותר מבדיקה נומרית.
שימו לב גם ש- שכמעט נכון הוא צירוף מקרים של הגודל הנצפה: הצפיפויות באתרים כמעט לא זזות, בעוד שהמצב עצמו שגוי איכותית (אין בו רכיב של תפוסה כפולה). אם גודל נצפה אחד מתכנס, זה לא מראה שגודל אחר התכנס.
מה כדאי לקחת מזה
-
הקידוד הוא עניין של ה-Transpiler. המעגל הבוזוני בשלב 3 לא מזכיר קטימה, קידוד או מספר קיוביטים. ארבעה קידודים הורידו אותו לארבעה מעגלים שונים, וכולם משחזרים את אותה פיזיקה. שום דבר שלפני ה-Transpiler לא היה צריך להשתנות.
-
אצל בוזונים זו לא רק נוחות. הקטימה היא פרמטר התכנסות שצריך לסרוק, והיא חיה בתוך הקידוד. מעגל שנבנה מול קידוד קבוע היה צריך להיבנות מחדש עבור כל ערך של .
-
מקבצים לפני המיפוי, ומקבצים לפי הרמיטיות. איבר דילוג בודד אינו הרמיטי ואי אפשר להעלות אותו בחזקה; זוג הקשר ביד הוא הרמיטי, ולכן אפשר להעלות אותו בחזקה. החליטו על החלוקה ברמה הבוזונית, שבה הסריג עדיין נראה. זה הכרחי מבחינה פיזיקלית, והתכונה
groupsקיימת כדי להעביר את ההחלטה הלאה. -
אל תניחו שהקידוד בעל המשקל הנמוך הוא הזול. ב- הקודים הקומפקטיים עדיפים על שני הווריאנטים האונאריים גם בקיוביטים וגם בשערים בו-זמנית, והווריאנט המוטל הוא היקר מכולם. מדדו; נקודת ההצטלבות תלויה ב-.
-
הקטימה שוברת את האלגברה, בצורה שאפשר לכמת. רק ברמה העליונה שנשמרה, ב-. זו גם הסיבה שמיפוי אינו מתחלף עם סידור נורמלי.
הצעדים הבאים
שני כיוונים מרחיבים את הדוגמה הזו. אם מחליפים את רשימת הקשתות של השרשרת בקשרים של סריג ריבועי, אין צורך בשום שינוי אחר, כי הפונקציה bose_hubbard שהוגדרה קודם כבר אינה תלויה בגיאומטריה. גם קידוד מותאם משלכם (למשל קוד אונארי-בלוקים, שמשלב בין אונארי לקומפקטי) מתחבר דרך אותו מפרק MapperFnEvolutionSynthesis שבו משתמשת ההגדרה המוכנה.
-
עקרונות התכנון של ייצוגי אופרטורים מסביר את מבנה הנתונים של האופרטור שמאחורי ההמילטוניאן.
-
מיפוי ייצוגי אופרטורים מכסה את הקידודים ואת כתיבת מפה משלכם.
-
Transpile של מעגלים בוזוניים עובר על השלבים שההגדרה המוכנה מריצה.
-
סינתזה של שער Evolution במרחב בוזוני מראה איך מצמצמים את שגיאת טרוטר במרחב בוזוני.
כל עומק שדווח הוא על אוגר מופשט וקשיר במלואו. מיפוי לקישוריות החומרה האמיתית הוא שלב נפרד, והבלוקים של קיוביטים לכל אופן בקידוד תפוסה נותנים לנתב מבנה שונה למדי מקיוביט אחד לכל אופן.
[1]
R. Somma, G. Ortiz, E. Knill, and J. Gubernatis, Quantum Simulations of Physics Problems (2003), arXiv:quant-ph/0304063, Sec. 4, Eq. 22.
[2]
N. P. D. Sawaya, T. Menke, T. H. Kyaw, S. Johri, A. Aspuru-Guzik, and G. G. Guerreschi, Resource-efficient digital quantum simulation of d-level systems for photonic, vibrational, and spin-s Hamiltonians, npj Quantum Information 6, 49 (2020), arXiv:1909.12847.