הדמיית דינמיקת Fermi-Hubbard חד-ממדית עם flow sets
הפונקציות המתוארות במדריך הזה זמינות כרגע רק ב-API של Python. פונקציונליות מקבילה תהיה זמינה ב-API של C במהדורה עתידית.
המדריך הזה בונה מעגל לדינמיקה בזמן של מודל Fermi-Hubbard החד-ממדי, מכתיבת ההמילטוניאן ועד בדיקת צפיפויות האתרים לאחר האבולוציה. מה שמעניין בדרך הזו הוא רעיון אחד, שנלקח ממסגרת ה-flow set של Gandon ואחרים [1], העבודה שהניעה גם את TransferVertexOperator בחבילה הזו:
במקום לקבץ איברים של ההמילטוניאן אחרי המיפוי מפרמיונים ל-Qubit, מקבצים אותם לפניו, ל-flow sets: תת-קבוצות חד-ממדיות של גרף האינטראקציה הפרמיוני המכוון, שאופרטורי ההעברה שלהן מתחלפים זה עם זה.
הבחירה הזו מניעה את כל מה שבא אחר כך. היא דורשת את הדברים הבאים:
-
קידוד מותאם אישית מפרמיונים ל-Qubit שמותאם ל-flow sets, ואשר כאן מוציא Qubit עזר אחד כך שמספר ה-Qubit הקשור למימוש איבר המילטוניאן נתון כבר אינו גדל עם מספר המודים הפרמיוניים (כפי שקורה ב-Jordan-Wigner (JW)).
-
סינתזה מותאמת אישית שמנצלת את החילופיות בתוך כל קבוצה. התוצאה היא מעגל שעומק שני ה-Qubit שלו קבוע ביחס לגודל המערכת, לעומת הגידול הליניארי של טרוטריזציה איבר-איבר מבוססת JW.
המנגנון שמכניס קידוד משלכם ל-Transpiler (CustomF2QLayout ו-MapperFnEvolutionSynthesis) מתאים לכל מודל.
מדריך הטרנספילציה לשלבי ה-Transpiler שמוזכרים לאורך המדריך, ומדריך ה-mappers למתכון הכללי לכתיבת mapper מותאם אישית.
אופרטורי העברה ו-flow sets
TransferVertexOperator בנוי מאופרטורי קודקוד ומאופרטורי העברה . במונחים של אופרטורי יצירה והכחדה פרמיוניים,
כך ש- מודד את התפוסה של מוד (הוא כשהמוד ריק ו- כשהוא מלא), ואילו מעביר פרמיון לאורך הצלע המכוונת . שימו לב ששני האינדקסים של אינם ניתנים להחלפה. האינדקס הראשון נושא את הצירוף עם המינוס והשני נושא את הפלוס, וזה מה שמבדיל בין ל- ונותן לצלע את הכיוון שלה.
אלה מקיימים יחסי חילוף מעורבים. שני אופרטורי העברה הפועלים על אתרים זרים מתחלפים באופן טריוויאלי, כי כל אחד מהם הוא מכפלה זוגית של אופרטורים פרמיוניים. המקרה המעניין הוא אתר משותף. שם, השניים מתחלפים אם החצים זורמים דרך האתר (אחד מגיע, אחד יוצא) ואנטי-מתחלפים אם הם מתנגשים (שניהם מגיעים, או שניהם יוצאים).
הכלל הכי קל להבנה בעזרת תמונה. אם מציירים את הקודקודים כצמתים ואת כל כחץ מ- אל , מקבלים את גרף האינטראקציה המכוון, כאן עבור שרשרת ארבעת האתרים שבה משתמשים לאורך המדריך, שנושאת את שני הכיוונים של כל קשר:

עקבו אחרי הכלל על האיור. הסתכלו למשל על ו-. חץ אחד מגיע לאתר 2 והשני יוצא ממנו, כך שהפרמיון זורם ישר דרכו ושני האופרטורים מתחלפים. לעומת זאת, הסתכלו על ו-. שני החצים מצביעים אל תוך אתר 2. הם מתנגשים, ושני אלה אנטי-מתחלפים.
זה מה שמאפשר את ה-flow sets. בוחרים קבוצת חצים היוצרת מסלול מכוון, וכל זוג או נפגש ראש-בזנב או לא נפגש בכלל, ולכן כל הקבוצה מתחלפת, אף על פי שהאופרטורים הבודדים חופפים באתרים משותפים. לכן אבולוציה תחת flow set יחיד אינה גוררת שגיאת Trotter, וכפי ששלב 7 מראה, אפשר גם לבצע אותה בעומק מעגל קבוע.
1. ההמילטוניאן של Fermi-Hubbard
מודל Fermi-Hubbard החד-ממדי על אתרים (חסר ספין, תנאי שפה פתוחים) הוא
בהתאם למשוואה (9) בהפניה [1], איבר הניתור (hopping) הוא . האינטראקציה אלכסונית, ולכן היא מבוטאת דרך אופרטורי קודקוד באמצעות :
שני החלקים נבנים ישירות כ-TransferVertexOperator. שימו לב ש- נשמר כאיבר האלכסוני (j, j):
>>> from collections import defaultdict
>>> from qiskit_fermions.operators import TransferVertexOperator
>>>
>>> def fermi_hubbard_1d(num_sites, tunneling, interaction):
...     data: defaultdict[tuple[tuple[int, int], ...], complex] = defaultdict(complex)
...     for j in range(num_sites - 1):
...         k = j + 1
...         # hopping: -t (a^dag_j a_k + a^dag_k a_j) = t (T_jk + T_kj)
...         data[((j, k),)] += tunneling
...         data[((k, j),)] += tunneling
...         # interaction: U n_j n_k with n_j = (1 - V_j) / 2
...         data[()] += interaction / 4
...         data[((j, j),)] -= interaction / 4
...         data[((k, k),)] -= interaction / 4
...         data[((j, j), (k, k))] += interaction / 4
...     return TransferVertexOperator.from_dict(data)
>>>
>>> num_sites = 4
>>> hamiltonian = fermi_hubbard_1d(num_sites, tunneling=1.0, interaction=2.0)
>>> print(format(hamiltonian))
  1.500000e0 +0.000000e0j * ()
-5.000000e-1 +0.000000e0j * (V(0))
 5.000000e-1 +0.000000e0j * (V(0) V(1))
  1.000000e0 +0.000000e0j * (T(0,1))
  1.000000e0 +0.000000e0j * (T(1,0))
 -1.000000e0 +0.000000e0j * (V(1))
 5.000000e-1 +0.000000e0j * (V(1) V(2))
  1.000000e0 +0.000000e0j * (T(1,2))
  1.000000e0 +0.000000e0j * (T(2,1))
 -1.000000e0 +0.000000e0j * (V(2))
 5.000000e-1 +0.000000e0j * (V(2) V(3))
  1.000000e0 +0.000000e0j * (T(2,3))
  1.000000e0 +0.000000e0j * (T(3,2))
-5.000000e-1 +0.000000e0j * (V(3))
האתרים הפנימיים מקבלים מקדם על כי הם מופיעים בשני קשרים, ואילו אתרי השפה מופיעים רק באחד. כל איבר שמופיע כאן מופיע בגרף שצויר למעלה. איברי T(j,k) הם החצים שלו, ואיברי V(j) הם הצמתים שלו.
2. חלוקה ל-flow sets
בשלב הבא, תייגו כל איבר ב-flow set שהוא שייך אליו. התכונה groups קיימת למטרה הזו. שער Evolution על אופרטור מקובץ מתפרק ל-Evolution אחד לכל קבוצה (שלב 6 מנצל זאת), כך שהקיבוץ שנקבע כאן ברמה הפרמיונית שורד אל תוך המעגל.
עבור השרשרת החד-ממדית, שני ה-flow sets של הניתור הם החצים המכוונים מזרחה () והחצים המכוונים מערבה (). איברי האינטראקציה האלכסוניים מתחלפים עם כל דבר אלכסוני ויוצרים קבוצה שלישית:
>>> def flow_set_groups(operator):
...     groups = []
...     for terms, _ in operator.iter_terms():
...         match terms:
...             case [(left, right)] if right == left + 1:
...                 groups.append(0)  # east-oriented: T_{j,j+1}
...             case [(left, right)] if right == left - 1:
...                 groups.append(1)  # west-oriented: T_{j+1,j}
...             case _:
...                 groups.append(2)  # diagonal interaction terms
...     return groups
>>>
>>> hamiltonian.groups = flow_set_groups(hamiltonian)
>>> hamiltonian.num_groups()
3
>>> for index, group in enumerate(hamiltonian.split_out_groups()):
...     print(index, sorted(terms for terms, _ in group.iter_terms()))
0 [[(0, 1)], [(1, 2)], [(2, 3)]]
1 [[(1, 0)], [(2, 1)], [(3, 2)]]
2 [[], [(0, 0)], [(0, 0), (1, 1)], [(1, 1)], [(1, 1), (2, 2)], [(2, 2)], [(2, 2), (3, 3)], [(3, 3)]]
קבוצות 0 ו-1 הן שני ה-flow sets. כל קבוצה היא מסלול מכוון לאורך השרשרת, ולכן לפי תכונת הזרימה כל האיברים בתוך קבוצה מתחלפים.
כל קבוצה צריכה גם להיות הרמיטית בפני עצמה, כי נוסחת מכפלה מעלה בחזקה את הקבוצות בנפרד, ורק גורם הרמיטי מקבל אבולוציה אונרית. groups_are_hermitian() מאשרת זאת:
>>> from qiskit_fermions.operators.terms.grouping import groups_are_hermitian
>>>
>>> groups_are_hermitian(hamiltonian)
[True, True, True]
כדאי לעצור על זה, כי קבוצות הניתור הן חד-כיווניות: קבוצה 0 מכילה רק איברים מכוונים מזרחה וקבוצה 1 רק איברים מכוונים מערבה. פיצול של המילטוניאן בצורה כזו בדרך כלל היה שובר את ההרמיטיות, כי זקוק לשותף הצמוד שלו לצדו. TransferVertexOperator נמנע מהבעיה כי הוא כבר הרמיטי בפני עצמו. הוא מכפלה של שני אופרטורי Majorana (ראו את ההגדרה שלו בשלב 1), ולא חשוף, ולכן התמונה שלו ב-Jordan-Wigner נושאת מקדם ממשי ולא מדומה. בחירת ייצוג האופרטור הזה היא אפוא מה שהופך flow set חד-כיווני לגורם Trotter לגיטימי מלכתחילה.
תוויות מזרח/מערב בכל המדריך הזה הן גאומטריות, כשהשרשרת מצוירת משמאל לימין ואינדקסי המודים עולים בכיוון הזה; מצביע מזרחה ו- מצביע מערבה. הפניה [1] אינה עקבית בעצמה בשמות האלה (הטקסט שלה והאיורים שלה סותרים זה את זה), ולכן המדריך הזה במכוון לא עוקב אחרי הטקסט, ובמקום זאת שומר על התוויות מהתמונה. כשקוראים במקביל לעבודה המקורית, התאימו את ה-flow sets לפי משקלי ה-Pauli שלהם (1 ו-3 להלן), ולא לפי מילות המצפן.
3. כתיבת הקידוד המותאם אישית
סעיף IV B בהפניה [1] מסווג את הצורות שקידוד פרמיון-ל-Qubit מקומי יכול לקבל כשהוא מוגבל ל-flow set. Jordan-Wigner הרגיל משתמש ב- Qubit וממפה כל איבר ניתור ל-Pauli ממשקל 2. הסיווג מראה שהוצאת Qubit נוספים קונה מבנה באופרטורים המקודדים.
הקידוד שמומש כאן הוא בניית ה-parity-delocalized של נספח B 2 (משוואות B4 ו-B5), שמשתמשת ב-Qubit עזר אחד, כך ש-. הזוגיות הפרמיונית מפוזרת על פני זוג Qubit:
האינדקס בביטוי האחרון כופה את ה-Qubit הנוסף. לקשר האחרון בשרשרת יש , ולכן ה- שלו נוחת על Qubit , אחד אחרי המוד הפרמיוני האחרון . ה-Qubit הנגרר הזה הוא Qubit העזר, ובגללו ולא . אותה הגעה מופיעה גם ב-, ש- שלו נמצא על Qubit העזר עבור .
התועלת נראית מיד; flow set שלם ממופה לסכום של Pauli ממשקל 1.
המקדמים נקבעים על ידי הנרמול , והסימן המינוס היחסי בין שני הכיוונים נקבע על ידי זהות המכפלה , שמקיימים אותה ה-Pauli שלמעלה. טעות באחד מהם מניבה אופרטור שמצייתי ליחסי החילוף אבל כבר אינו מייצג את אותו המילטוניאן, ולכן כדאי לאמת את הקידוד מספרית, כפי שמוצג בשלב 4.
כתיבת הקידוד פירושה כתיבת פונקציה שממפה אופרטור העברה מוכלל יחיד למחרוזת Pauli; map_transfer_vertex_generators() מטפלת במעבר על האיברים ובהרכבתם:
>>> from qiskit.quantum_info import SparseObservable
>>> from qiskit_fermions.mappers import map_transfer_vertex_generators
>>>
>>> def flow_set_action(action, num_qubits):
...     match action:
...         case (j, k) if j == k:
...             # vertex operator: V_j = Z_j Z_{j+1}
...             return SparseObservable.from_sparse_list(
...                 [("ZZ", [j, j + 1], 1.0)], num_qubits=num_qubits
...             )
...         case (j, k) if k == j + 1:
...             # east-oriented transfer operator: weight 1
...             return SparseObservable.from_sparse_list(
...                 [("X", [k], -0.5)], num_qubits=num_qubits
...             )
...         case (j, k) if k == j - 1:
...             # west-oriented transfer operator: weight 3
...             return SparseObservable.from_sparse_list(
...                 [("ZXZ", [k, k + 1, k + 2], 0.5)], num_qubits=num_qubits
...             )
...         case _:
...             raise ValueError(f"not a nearest-neighbor transfer operator: {action}")
>>>
>>> def flow_set_encoding(operator, num_qubits):
...     return map_transfer_vertex_generators(
...         operator,
...         lambda action: flow_set_action(action, num_qubits),
...         identity=lambda: SparseObservable.identity(num_qubits),
...         compose=SparseObservable.compose,
...     ).simplify()
MapperFnEvolutionSynthesis.mapper_fn מצפה לחתימה (operator, num_qubits), וסוג ההחזרה חייב להיות SparseObservable, מה שהופך את הפונקציה לשמישה ישירות כתוסף Transpiler. ראו שלב 6.
החלת הקידוד על ההמילטוניאן משלב 1 נותנת את האופרטור המקודד על Qubit:
>>> num_qubits = num_sites + 1
>>> encoded = flow_set_encoding(hamiltonian, num_qubits)
>>> for label, indices, coeff in sorted(encoded.to_sparse_list()):
...     print(f"{label:3s} {str(indices):12s} {coeff.real:+.2f}")
    []           +1.50
X   [1]          -0.50
X   [2]          -0.50
X   [3]          -0.50
ZXZ [0, 1, 2]    +0.50
ZXZ [1, 2, 3]    +0.50
ZXZ [2, 3, 4]    +0.50
ZZ  [0, 1]       -0.50
ZZ  [0, 2]       +0.50
ZZ  [1, 2]       -1.00
ZZ  [1, 3]       +0.50
ZZ  [2, 3]       -1.00
ZZ  [2, 4]       +0.50
ZZ  [3, 4]       -0.50
יש 14 איברים, בשלוש צורות: הניתור הפך ל-X ו-ZXZ, האינטראקציה ל-ZZ, וה-[] המוביל הוא הזהות, שתורמת רק פאזה גלובלית. שימו לב שאיברי ה-ZZ מגיעים לשכנים הקרובים וגם לשכנים הבאים אחריהם; פורש את Qubit עד , וזה המחיר של פיזור הזוגיות.
קיבוץ לפי flow set חושף את האסימטריה שהבנייה קונה. רשמו את משקלי ה-Pauli הקיימים בכל קבוצה:
>>> for index, group in enumerate(hamiltonian.split_out_groups()):
...     weights = {len(indices) for _, indices, _ in flow_set_encoding(group, num_qubits).to_sparse_list()}
...     print(index, sorted(weights))
0 [1]
1 [3]
2 [0, 2]
ה-flow set המכוון מזרחה (קבוצה 0) מורכב כולו מ-Pauli ממשקל 1. לכן האבולוציה בזמן שלו היא שכבה של סיבובי Qubit בודד ואינה זקוקה לשערי הסתבכות, ואילו תחת Jordan-Wigner כל איבר ניתור הוא ממשקל 2 ודורש אותם. זו ההחלפה בין מרחב לזמן של הפניה [1] בצורתה הפשוטה ביותר: Qubit נוסף אחד ממיר חצי מהמילטוניאן הניתור לסיבובי Qubit בודד.
ה-flow set המכוון מערבה (קבוצה 1) משלם על כך במשקל שלוש, והאינטראקציה (קבוצה 2) נמצאת במשקל שניים, כשהאיבר ממשקל אפס הוא הזהות. שום דבר מזה עדיין אינו טענה על מעגל; מה שסינתזה עושה עם המשקלים האלה הוא נושא שלבים 6 ו-7.
4. אימות הקידוד
קידוד מותאם אישית שימושי רק אם הוא נאמן, וקידוד שנכתב ביד כדאי לבדוק. מכיוון שהקידוד הזה משתמש ב- Qubit, מרחב הילברט של ה-Qubit גדול פי שניים מהפרמיוני, ולכן ההמילטוניאן המקודד אינו יכול להיות שווה לזה של Jordan-Wigner איבר-איבר. השניים קשורים זה לזה דרך איזומטריה.
מאיפה האיזומטריה באה: ב-Jordan-Wigner מצב בסיס הוא מחרוזת התפוסה; Qubit מחזיק את . הקידוד הזה במקום זאת שומר זוגיות מצטברת. נגדיר
כך שהביט מתעד את הזוגיות של כל התפוסות עד האתר ועד בכלל. יש ביטים כאלה עבור תפוסות, ומכאן בא Qubit העזר. את התפוסה משחזרים כהפרש בין ביטים שכנים, . לכן אתר תפוס מופיע כדופן תחום (domain wall) בין שני ביטים סמוכים, ולכן זה נקרא קידוד domain-wall (או Kramers-Wannier). זו גם הסיבה ש-: מכפלה של שני שכנים קוראת את ההפרש הזה.
כתיבת ההתאמה הזו עבור כמה מצבים מבהירה את המבנה (שימו לב ש- קבוע, ולכן רק מחצית ממצבי ה-Qubit מתוך נמצאים בתמונה, ומכאן שמדובר באיזומטריה ולא באופרטור יוניטרי):
>>> def domain_wall_bits(occupations):
...     parity = 0
...     bits = [0]
...     for occupation in occupations:
...         parity ^= occupation
...         bits.append(parity)
...     return bits
>>>
>>> for occupations in ([0, 0, 0, 0], [1, 0, 0, 0], [1, 1, 0, 0], [1, 0, 1, 0]):
...     bits = domain_wall_bits(occupations)
...     # little-endian: reversed() prints qubit 0 on the right, as Qiskit labels do
...     print("".join(map(str, occupations)), "->", "".join(str(b) for b in reversed(bits)))
0000 -> 00000
1000 -> 11110
1100 -> 00010
1010 -> 00110
פרמיון בודד באתר 0 הופך כל זוגיות מצטברת שמעליו, וזה בדיוק הדה-לוקליזציה בפעולה. אם נאסוף את העמודות האלה למטריצה, נקבל את האיזומטריה , והקידוד נאמן כאשר הוא משזר את שני ההמילטוניאנים:
כלומר, מיפוי של מצב פרמיוני למרחב ה-Qubit ואז התפתחות שלו שם חייבים לתת את אותה תוצאה כמו התפתחות במרחב הפרמיוני קודם ומיפוי אחר כך.
>>> import numpy as np
>>> from qiskit.quantum_info import SparsePauliOp
>>> from qiskit_fermions.mappers.library import transfer_vertex_jordan_wigner
>>>
>>> def to_matrix(observable):
...     # SparseObservable carries no dense-matrix method, so route through
...     # SparsePauliOp. This is only ever needed for the checks below --
...     # the encoding itself never leaves SparseObservable.
...     return SparsePauliOp.from_sparse_observable(observable).to_matrix()
>>>
>>> def domain_wall_isometry(num_sites):
...     isometry = np.zeros((2 ** (num_sites + 1), 2**num_sites), dtype=complex)
...     for index in range(2**num_sites):
...         occupations = [(index >> j) & 1 for j in range(num_sites)]
...         bits = domain_wall_bits(occupations)
...         isometry[sum(b << j for j, b in enumerate(bits)), index] = 1.0
...     return isometry
>>>
>>> isometry = domain_wall_isometry(num_sites)
>>> np.allclose(isometry.conj().T @ isometry, np.eye(2**num_sites))
True
>>>
>>> def intertwines(operator):
...     """Whether both mappings of `operator` agree through the isometry."""
...     flow = to_matrix(flow_set_encoding(operator, num_qubits))
...     reference = to_matrix(transfer_vertex_jordan_wigner(operator, num_sites).simplify())
...     return np.allclose(flow @ isometry, isometry @ reference)
>>>
>>> intertwines(hamiltonian)
True
>>> # and, more strongly, once per flow set: a product formula evolves the groups
>>> # separately, so each one has to be intertwined on its own
>>> all(intertwines(group) for group in hamiltonian.split_out_groups())
True
יחס השזירה מתקיים במדויק, ובנפרד לכל קבוצת זרימה. הטענה השנייה, החזקה יותר, היא זו שהשלבים הבאים נשענים עליה: נוסחת מכפלה מפתחת את הקבוצות אחת אחרי השנייה, ומכפלה של גורמים משוזרים היא עצמה משוזרת, ולכן כל קירוב שנבנה מהקבוצות האלה מתאים בין שני הקידודים, אף על פי שהקידודים שונים. כמסקנה, הספקטרום חייב להתאים, כאשר כל ערך עצמי של Jordan-Wigner מופיע פעמיים במרחב הגדול, פעם אחת לכל ערך של הזוגיות הגלובלית הבלתי מוגבלת:
>>> jw_matrix = to_matrix(transfer_vertex_jordan_wigner(hamiltonian, num_sites).simplify())
>>> flow_matrix = to_matrix(flow_set_encoding(hamiltonian, num_qubits))
>>>
>>> jw_spectrum = np.linalg.eigvalsh(jw_matrix)
>>> flow_spectrum = np.linalg.eigvalsh(flow_matrix)
>>> np.allclose(
...     np.sort(flow_spectrum),
...     np.sort(np.concatenate([jw_spectrum, jw_spectrum])),
... )
True
>>> print(f"{jw_spectrum[0]:.10f}  {flow_spectrum[0]:.10f}")
-1.8557725066  -1.8557725066
5. בניית המעגל הפרמיוני
לפני שמערבים Qubits כלשהם, הדינמיקה מבוטאת ברמה הפרמיונית. FermionicCircuit פועל על מודים פרמיוניים ולא על Qubits, ושער Evolution מעל ההמילטוניאן הוא המעגל כולו:
>>> from qiskit_fermions.circuit import FermionicCircuit
>>> from qiskit_fermions.circuit.library import Evolution
>>> from qiskit_fermions.circuit.library.synthesis import FermionicLieTrotter
>>>
>>> total_time = 1.0
>>> circuit = FermionicCircuit(num_sites)
>>> circuit.append(
...     Evolution(
...         num_sites, hamiltonian, time=total_time, synthesis=FermionicLieTrotter()
...     ),
...     circuit.modes,
... )
>>> circuit.draw("mpl")
<Figure size ... with 1 Axes>

יש כאן קופסה אטומה אחת מעל כל ארבעת המודים, והחלק המעניין הוא למה היא מתפרקת. הארגומנט synthesis קובע איך: FermionicLieTrotter היא נוסחת המכפלה מהסדר הראשון, שמפצלת את האופרטור לפי ה-groups שלו ומפתחת כל קבוצה בתורה. כלומר, חלוקת קבוצות הזרימה משלב 2 היא הטרוטריזציה, ו-decompose() אחד מבצע אותה, ומניב שער Evolution אחד לכל קבוצת זרימה לפי סדר הקבוצות: מזרח, מערב ואז האינטראקציה האלכסונית, עם 3, 3 ו-8 איברים בהתאמה.
>>> flow_set_circuit = circuit.decompose()
>>> flow_set_circuit.draw("mpl")
<Figure size ... with 1 Axes>
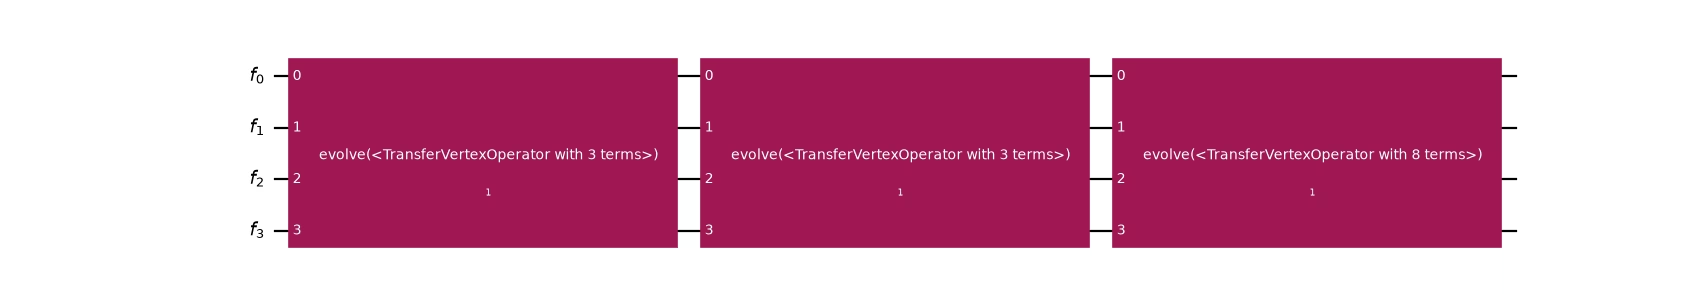
שימו לב שכל זה קורה כולו במרחב הפרמיוני: עדיין לא הוזכר אף Qubit, והקירוב כבר נעשה. לכן גם מספר צעדי טרוטר שייך לכאן, בתור reps, שמחלק את הזמן וחוזר על הסריקה כולה:
>>> def trotter_steps(reps):
...     step = FermionicCircuit(num_sites)
...     step.append(
...         Evolution(
...             num_sites,
...             hamiltonian,
...             time=total_time,
...             synthesis=FermionicLieTrotter(reps=reps),
...         ),
...         step.modes,
...     )
...     return step.decompose()
>>>
>>> trotter_steps(3).count_ops()["Evolution"]
9
תשעה שערים: שלוש קבוצות הזרימה, שעוברים עליהן שלוש פעמים, בשליש מהזמן בכל פעם. המחזוריות הזו היא מה שהופך את זה לטרוטריזציה ולא לחיתוך מחדש של קבוצה אחת. חזרה על קבוצה אחת לא תשיג כלום, כי אקספוננטים עוקבים של אותו אופרטור מתחלפים, ולכן A(t/3) A(t/3) A(t/3) הוא פשוט A(t). נוסחה שקוראת את הקבוצות יכולה לשלב ביניהן; נוסחה שמופעלת אחרי המיפוי לא יכולה, כי הקיבוץ כבר אבד בשלב הזה.
זה השלב שבו הקיבוץ הופך לחשוב. כל שער שנפלט ממופה ומסונתז באופן בלתי תלוי, ולכן כל מה שבהמשך פועל על החלוקה שנקבעה ברמה הפרמיונית. דילוג על הפירוק מעביר את האופרטור כולו לשלב הבא, והקיבוץ מתעלמים ממנו.
6. קומפילציה עם הקידוד המותאם אישית
הקידוד מוכן עכשיו לשימוש על ידי ה-Transpiler. דרושים עוד שני רכיבים:
-
פריסה (layout). ברירת המחדל
TrivialF2QLayoutמניחה Qubit אחד לכל מוד, וזה לא נכון במקרה הזה.CustomF2QLayoutמשייכת את הרגיסטר הפרמיוני ל-QuantumRegisterבגודל שונה, וכך Qubits עזר נכנסים לצנרת. -
תוסף סינתזה.
MapperFnEvolutionSynthesisמקבל ישירות את פונקציית המיפוי, ממפה איתה את ההמילטוניאן של שערEvolution, ופולטPauliEvolutionGate, תוך שמירה על הקונבנציה . ה-product_formulaשלו קובע איך השער הזה הופך לסיבובים. שימו לב שזו נוסחת מכפלה שנייה ועצמאית, שפועלת על Qubits אחרי המיפוי: כאן מועברLieTrotterשל Qiskit, ושלב 7 מחליף אותו באחד שמכיר קבוצות זרימה.
מכיוון שכל השוואה בהמשך מריצה מחדש את הצנרת הזו, כדאי לעטוף אותה פעם אחת:
>>> from qiskit.circuit import QuantumRegister
>>> from qiskit.passmanager import MultiStagePassManager
>>> from qiskit_fermions.transpiler import FermionicCircuitToDAG, QuantumDAGToCircuit
>>> from qiskit_fermions.transpiler.passes import (
...     CustomF2QLayout,
...     F2QSynthesis,
...     MapperFnEvolutionSynthesis,
... )
>>>
>>> def flow_set_pass_manager(mode_register, product_formula=None):
...     '''Build the pipeline mapping `mode_register` with the flow-set encoding.'''
...     synthesis = F2QSynthesis()
...     synthesis.methods["Evolution"] = MapperFnEvolutionSynthesis(
...         flow_set_encoding, product_formula=product_formula
...     )
...     # this encoding spends one ancilla on top of the fermionic modes
...     qubit_register = QuantumRegister(mode_register.size + 1, "q")
...     return MultiStagePassManager(
...         input=FermionicCircuitToDAG(),
...         layout=CustomF2QLayout({mode_register: qubit_register}),
...         synthesis=synthesis,
...         output=QuantumDAGToCircuit(),
...     )
>>>
>>> from qiskit.synthesis import LieTrotter
>>>
>>> pass_manager = flow_set_pass_manager(flow_set_circuit.register, LieTrotter())
>>> qubit_circuit = pass_manager.run(flow_set_circuit)
>>> qubit_circuit.num_qubits
5
ארבעה מודים פרמיוניים הפכו למעגל של חמישה Qubits, כשה-Qubit העזר מגיע מהפריסה המותאמת אישית.
עכשיו נסתכל על מה שהמעגל המתקבל באמת מכיל. פירוק חוזר מצמצם את שערי ההתפתחות עד ל-U ו-CX, כך שעלות הדו-Qubit של שתי אסטרטגיות הסינתזה שמושוות בהמשך נמדדת באותו מטבע: count_ops() מדווח אז את מספר ה-CX, ו-depth() מקבל פונקציית סינון כדי למדוד את עומק הדו-Qubit. שימו לב ש-reps הזה הוא עומק פירוק, ואינו קשור למספר צעדי הטרוטר שנוסחת מכפלה מבצעת, שנקרא גם הוא reps בהמשך המדריך:
>>> decomposed = qubit_circuit.decompose(reps=6)
>>> decomposed.count_ops()["cx"]
26
>>> decomposed.depth(lambda instruction: len(instruction.qubits) == 2)
23
עשרים ושישה שערי CX בעשרים ושלוש שכבות, כך שכמעט שום דבר לא רץ במקביל. ציור המעגל מראה למה:
>>> decomposed.draw("mpl", fold=-1)
<Figure size ... with 1 Axes>
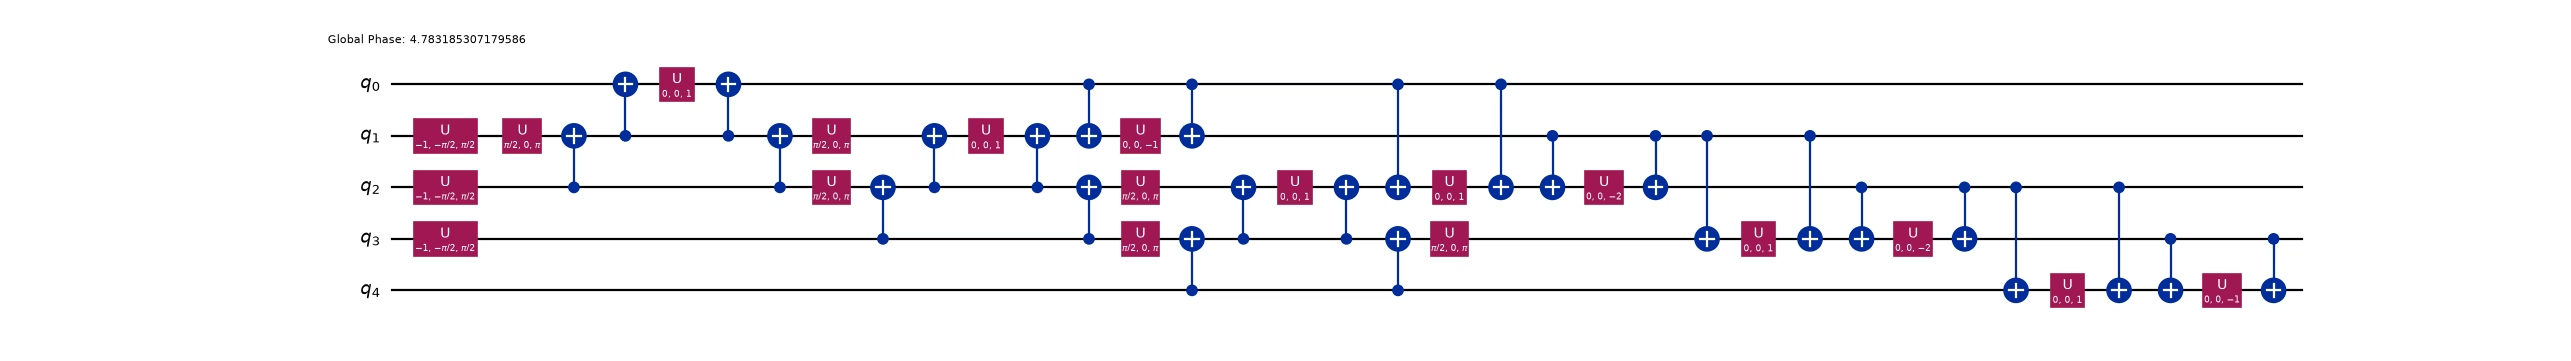
כל איבר עבר קומפילציה בבידוד: החלפת בסיס, סולם CX עד לסיבוב בודד, ואז הסולם מבוטל. קבוצת הזרימה ממשקל 1 חינמית; האיברים שלה הם סיבובים בודדים בלי סולם סביבם, אבל כל איבר ממשקל 3 עולה ארבעה שערי CX, ומכיוון שהסולמות נפלטים ברצף, שום דבר לא חופף.
כלומר, הקיבוץ שורד את כל הצנרת (שלוש קבוצות זרימה, שלושה PauliEvolutionGate ממופים) ועדיין כמעט לא משיג כלום. הטרוטריזציה הפרמיונית משלב 5 עשתה את שלה; מה שמבזבז אותה היא הנוסחה בצד ה-Qubit. LieTrotter מקבל קבוצת איברים שלא נאמר לו עליה דבר, ומקמפל כל אחד בבידוד. הוא לא יכול לדעת שהם מתחלפים זה עם זה, ולכן הוא מסדר ברצף מה שיכול היה לחלוק החלפת בסיס.
זה הפער שהקידוד הזה קיים כדי לסגור: שתי נוסחאות מכפלה פועלות, ורק הפרמיונית קיבלה עד כה את המבנה. השלב הבא מספק סינתזה בצד ה-Qubit שמנצלת אותו גם כן.
7. סינתזה שמודעת לקבוצות זרימה
שחזור היתרון דורש לספר לסינתזה בצד ה-Qubit על המבנה. זה סעיף IV C במאמר [1]: מכיוון שכל האיברים של קבוצת זרימה מתחלפים, אפשר להפוך אותם לאלכסוניים בו-זמנית באמצעות מעגל Clifford יחיד, לסובב אותם בבסיס משותף אחד ולסובב חזרה, במקום פעם אחת לכל איבר.
עבור הקידוד הזה, ה-Clifford פשוט. צמצום על ידי שרשרת של שערי CZ בין שכנים קרובים ממפה
בו-זמנית לכל . שרשרת CZ אחת הופכת את כל קבוצת הזרימה ממשקל 3 (מערב) לשכבה של סיבובי עצמאיים על Qubit בודד. הממשק EvolutionSynthesis דורש רק מתודת synthesize(), וזו כל מה שהמחלקה הזו מממשת. היא לא נושאת מספר צעדי טרוטר, כי היא מקבלת קבוצת זרימה אחת בכל פעם ולכן לא יכולה לחלק את ההתפתחות בין הקבוצות. החלוקה הזו שייכת רמה אחת למעלה, במרחב הפרמיוני, שם F2FSynthesisPlugin רואה את כולן בבת אחת (ראו שלב 9):
>>> from qiskit.circuit import QuantumCircuit
>>> from qiskit.synthesis.evolution import EvolutionSynthesis
>>>
>>> def cz_brickwork(circuit):
...     # emit even and odd bonds as two layers, so the CZs are scheduled in
...     # parallel: a chain of overlapping CZs has depth 2, not num_qubits - 1
...     #
...     # NOTE: CZ gates are diagonal, so they all commute and each is its own inverse.
...     # This whole layer is therefore self-inverse, which is why the conjugation below
...     # calls it twice rather than calling it and then its inverse.
...     for offset in (0, 1):
...         for j in range(offset, circuit.num_qubits - 1, 2):
...             circuit.cz(j, j + 1)
>>>
>>> # The interaction reaches nearest (distance 1) and next-nearest (distance 2)
>>> # neighbors, so every interior qubit carries four Rzz gates and can only do one at
>>> # a time: four layers is the best any schedule can do. These offsets achieve it.
>>> def rzz_layers(circuit, angles):
...     """Emit the diagonal Rzz gates in four layers of disjoint qubit pairs."""
...     near = [(j, k) for j, k in angles if k - j == 1]
...     far = [(j, k) for j, k in angles if k - j == 2]
...     schedule = [
...         [(j, k) for j, k in near if j % 2 == 0],
...         [(j, k) for j, k in far if j % 4 in (0, 1)],
...         [(j, k) for j, k in near if j % 2 == 1],
...         [(j, k) for j, k in far if j % 4 in (2, 3)],
...     ]
...     # emit layer by layer, since Qiskit's depth follows the order gates were added
...     for layer in schedule:
...         for j, k in layer:
...             circuit.rzz(angles[j, k], j, k)
>>>
>>> class FlowSetSynthesis(EvolutionSynthesis):
...     '''Synthesize one flow set of the encoded Hamiltonian at a time.'''
...
...     preserve_order = True
...
...     def synthesize(self, evolution):
...         circuit = QuantumCircuit(evolution.operator.num_qubits)
...         east, west, diagonal = [], [], {}
...
...         for label, indices, coeff in evolution.operator.to_sparse_list():
...             angle = 2 * evolution.time * coeff.real
...             match label, indices:
...                 case "", _:  # the identity contributes only a global phase
...                     circuit.global_phase -= angle / 2
...                 case "X", [qubit]:  # east flow set: already weight-1
...                     east.append((qubit, angle))
...                 case "ZXZ", [j, k, l] if (k, l) == (j + 1, j + 2):
...                     west.append((k, angle))  # needs the CZ conjugation below
...                 case "ZZ", [j, k]:  # interaction: diagonal, see rzz_layers above
...                     diagonal[min(j, k), max(j, k)] = angle
...                 case _:
...                     raise ValueError(f"unexpected Pauli term: {label} on {indices}")
...
...         # east flow set: bare rotations, no entangling gates at all
...         for qubit, angle in east:
...             circuit.rx(angle, qubit)
...
...         # west flow set: one CZ chain diagonalizes the WHOLE set at once
...         if west:
...             cz_brickwork(circuit)
...             for qubit, angle in west:
...                 circuit.rx(angle, qubit)
...             cz_brickwork(circuit)
...
...         if diagonal:
...             rzz_layers(circuit, diagonal)
...
...         return circuit
שני פרטים קל לפספס. EvolutionSynthesis מותאם אישית חייב לחשוף תכונה preserve_order, שהמעבר של הסינתזה ברמה גבוהה קורא.
שני העוזרים פולטים את השערים שלהם בשכבות מפורשות ולא לפי סדר האיברים, כי depth() מתזמן שערים מוקדם ככל האפשר, לפי הסדר שבו נוספו. מכיוון שכל השערים בתוך אחת מהקבוצות האלה מתחלפים, אפשר לבחור את הסדר בחופשיות. סינתזה איבר-איבר בוחרת את הסדר רע. פליטת שרשרת CZ חופפת ברצף מדווחת על עומק שגדל עם מספר ה-Qubits, במקום 2 הקבוע שהחומרה יכולה להשיג.
לכן הסינתזה למעלה לא נושאת מספר צעדי טרוטר. היא מקבלת קבוצת זרימה אחת לכל שער, ולכן חזרה בתוכה תחזור בתוך קבוצה ולא תעבור בין הקבוצות:
repeating within one set:      A(t/2) A(t/2) B(t/2) B(t/2)
what a Trotterization needs:   A(t/2) B(t/2) A(t/2) B(t/2)
הצורה הראשונה לא משיגה כלום: אקספוננטים עוקבים של אותו אופרטור מתחלפים, ולכן A(t/2) A(t/2) הוא פשוט A(t) והשגיאה נשארת בערך של צעד אחד, לא משנה כמה צעדים מבקשים.
לכן מספר הצעדים שייך ל-FermionicLieTrotter הפרמיוני של שלב 5, שקורא את ה-groups ויכול לשלב ביניהן. חלוקת העבודה הזו היא העיקר: הנוסחה הפרמיונית מחליטה כמה צעדים ובאיזה סדר, והמחלקה הזו מחליטה כמה בזול כל קבוצה שמתקבלת ממומשת.
כדי לבחור את הסדר, מעבירים אותו ל-MapperFnEvolutionSynthesis.product_formula, שהוא הארגומנט ש-flow_set_pass_manager מקבל. שום דבר אחר בצנרת (או במעגל הפרמיוני שהיא רצה עליו) לא משתנה:
>>> pass_manager = flow_set_pass_manager(flow_set_circuit.register, FlowSetSynthesis())
>>>
>>> flow_circuit = pass_manager.run(flow_set_circuit).decompose(reps=6)
>>> flow_circuit.count_ops()["cx"]
22
>>> flow_circuit.depth(lambda instruction: len(instruction.qubits) == 2)
12
>>> flow_circuit.draw("mpl", fold=-1)
<Figure size ... with 1 Axes>
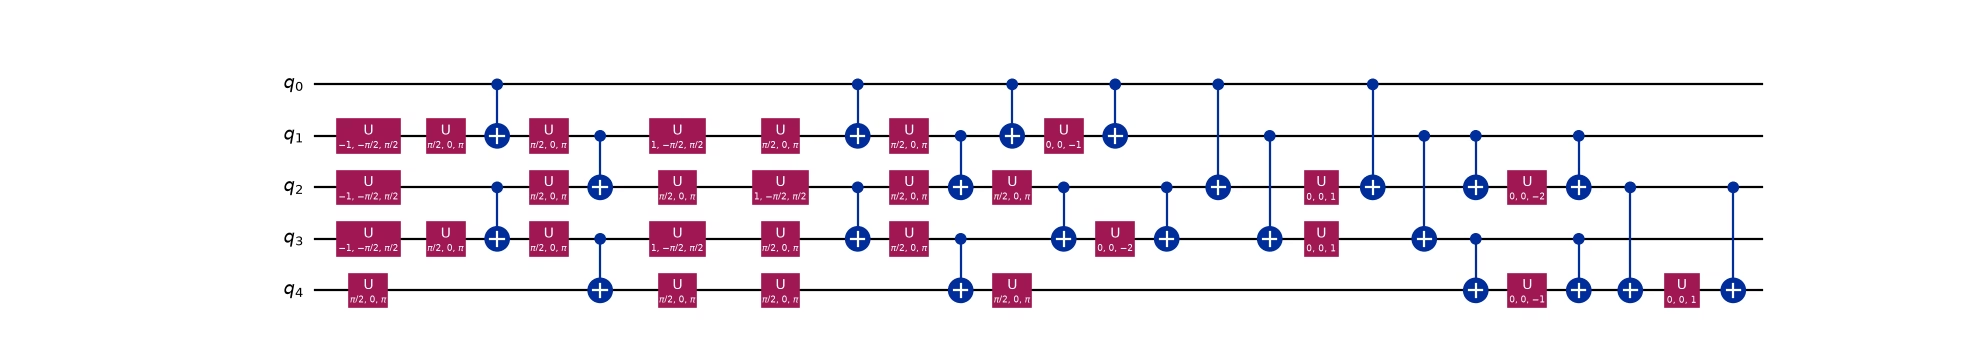
מעומק 23 עם 26 שערי CX לעומק 12 עם 22 שערי CX. שימו לב שזה פחות שערי הסתבכות וכמעט חצי מהעומק. בהשוואה בין שני האיורים, ההבדל הוא לא שהשערים זולים יותר אלא שהם נערמים. הסולמות הטוריים נעלמו; שערי הסתבכות יושבים עכשיו זה מעל זה בשכבות משותפות, כי כל קבוצת הזרימה המערבית מסובבת בבסיס משותף יחיד והאינטראקציה נפלטת בשכבות של זוגות זרים.
FlowSetSynthesis מתאים תבניות לאינדקסים מוחלטים של Qubits, וזה בטוח כאן רק מפני שכל קבוצת זרימה של ההמילטוניאן הזה פורשת את הרגיסטר כולו. נוסחת מכפלה פרמיונית מצמצמת כל גורם למודים שהוא באמת נוגע בהם, ולכן קיבוץ שקבוצותיו מכסות רק חלק מהשרשרת היה מגיע עם שמות שונים והתבניות למעלה לא היו מתאימות.
שני האיורים מציגים את המעגל אחרי decompose(reps=6), שכותב מחדש הכול בבסיס U ו-CX, ולכן שערי CZ, Rx ו-Rzz שנפלטים על ידי FlowSetSynthesis לא נראים ככאלה. זה מכוון: כך שני המעגלים באותו בסיס, וזו הדרך היחידה שבה ספירות ועומקי הדו-Qubit למעלה ניתנים להשוואה. מה שראוי לתשומת לב באיורים האלה הוא מבנה השכבות, לא תוויות השערים.
8. עומק קבוע בקנה מידה גדול
השאלה המעניינת היא לא הספירה בארבעה מודים אלא איך היא גדלה. שתי שכבות ה-CZ בסגנון לבנים לא גדלות עם אורך השרשרת, ולכן עומק הדו-Qubit של צעד טרוטר אחד אמור להיות קבוע. מדידה ישירה על ההמילטוניאן המלא של Fermi-Hubbard, הרחק מעבר למה שאפשר לדמות בכוח גס:
>>> def evolution_stats(num_sites, product_formula):
...     operator = fermi_hubbard_1d(num_sites, tunneling=1.0, interaction=2.0)
...     operator.groups = flow_set_groups(operator)
...
...     circuit = FermionicCircuit(num_sites)
...     circuit.append(
...         Evolution(
...             num_sites, operator, time=total_time, synthesis=FermionicLieTrotter()
...         ),
...         circuit.modes,
...     )
...     circuit = circuit.decompose()  # one Evolution per flow set, as in step 5
...
...     pass_manager = flow_set_pass_manager(circuit.register, product_formula)
...     decomposed = pass_manager.run(circuit).decompose(reps=6)
...     two_qubit = lambda instruction: len(instruction.qubits) == 2
...     return decomposed.count_ops()["cx"], decomposed.depth(two_qubit)
>>>
>>> sites = [4, 10, 20, 50, 100]
>>> flow = [evolution_stats(n, FlowSetSynthesis()) for n in sites]
>>> lie_trotter = [evolution_stats(n, LieTrotter()) for n in sites]
>>>
>>> [depth for _, depth in flow]
[12, 12, 12, 12, 12]
>>> [depth for _, depth in lie_trotter]
[23, 47, 87, 207, 407]
עומק הדו-Qubit נשאר 12 מארבעה מודים ועד 100, בעוד LieTrotter גדל ליניארית עד 407. קבוצות הזרימה מאפשרות מעט מקביליות בתוך הצנרת, אבל כל קבוצה עדיין עוברת טרוטריזציה איבר-איבר, ולכן הגידול רק מואט ולא מוסר:
>>> import matplotlib.pyplot as plt
>>>
>>> figure, axes = plt.subplots(1, 2, figsize=(9, 3.5), layout="constrained")
>>> for panel, index, title in zip(axes, (1, 0), ("two-qubit depth", "CX count")):
...     _ = panel.plot(sites, [stat[index] for stat in lie_trotter], "o-", label="qubit-level")
...     _ = panel.plot(sites, [stat[index] for stat in flow], "s-", label="flow set")
...     _ = panel.set(xlabel="modes", title=title)
...     _ = panel.legend()
>>> figure
<Figure size ... with 2 Axes>

מספר השערים גדל ליניארית בשתי הגישות (יש איברים להפעיל, ואי אפשר להימנע מכך), אבל הסינתזה לפי קבוצות זרימה מפעילה אותם במספר קבוע של שכבות מקבילות. זו תוצאת העומק הקבוע של המאמר [1].
העומק 12 מתחלק בין שלוש קבוצות הזרימה כ-0 + 4 + 8, בכל אורך שרשרת. קבוצת הזרימה המזרחית תורמת אפס; אלה סיבובי Rx חשופים. קבוצת הזרימה המערבית עולה 4, משתי שכבות ה-CZ בסגנון לבנים שנכנסות ושתיים שיוצאות; הסרת האינטראקציה משאירה עומק דו-Qubit של ארבע בכל אורך שרשרת. שמונה הנותרים הם האינטראקציה, שאיברי ה-Rzz שלה פועלים גם על שכנים קרובים וגם על שכנים שאחריהם, ולכן צריכים ארבע שכבות זרות, שכל אחת עולה שני שערי CX. ארבע זה האופטימום כאן: כל Qubit פנימי נושא ארבעה שערי Rzz (שניים לכל שכן ושניים לכל שכן שאחריו) ויכול להשתתף רק באחד בכל פעם, ולכן שום תזמון לא יכול להשיג יותר.
שני שלישים מהעומק הם האינטראקציה, מה שמראה שהקידוד הזה מצטיין בקפיצה (hopping), ולכן גם בדינמיקה של שרשרת פרמיונים חופשיים. עם זאת, שימו לב שהאינטראקציה לא מתחלפת עם הקפיצה. השמטה שלה היא לא קירוב של Fermi-Hubbard אלא מודל אחר. כדאי לבדוק איפה האיזון נופל בבעיה נתונה.
9. בדיקת הדינמיקה
תחת מיפוי קיר-התחום (domain-wall), תבנית אכלוס הופכת למחרוזת של זוגיות מצטברת, ולכן המצב ההתחלתי מוכן אחרת מאשר תחת Jordan-Wigner. זו השלכה מעשית שקל להתעלם ממנה של דה-לוקליזציית הזוגיות. העוזר משלב 4 נותן את התווית הנכונה:
>>> occupations = [1, 0, 1, 0]
>>> initial_label = "".join(str(b) for b in reversed(domain_wall_bits(occupations)))
>>> initial_label
'00110'
כשהמצב מוכן, נותרו שתי שאלות, וכדאי לשאול אותן בנפרד: האם הסינתזה לפי קבוצות זרימה מחשבת את הדבר הנכון, והאם היא מחשבת אותו בזול יותר?
נתחיל בנכונות. FlowSetSynthesis ו-LieTrotter של Qiskit מקבלים את אותן קבוצות זרימה מקודדות מאותה טרוטריזציה פרמיונית, ולכן הם חייבים לממש את אותו אופרטור יוניטרי עד כדי פאזה גלובלית. שערי ה-Clifford המותאמים אישית מארגנים מחדש את העבודה; הם לא משנים את התוצאה. וקטורי מצב אקראיים מגלים כל אי-התאמה בזול הרבה יותר מבניית האופרטור היוניטרי המלא:
>>> from qiskit.quantum_info import Statevector
>>>
>>> rng = np.random.default_rng(1234)
>>>
>>> def agrees_up_to_one_phase(reps, samples=3):
...     """Compare both qubit-side syntheses of the same fermionic Trotterization."""
...     step = trotter_steps(reps)
...     trotter = flow_set_pass_manager(step.register, LieTrotter()).run(step)
...     flow = flow_set_pass_manager(step.register, FlowSetSynthesis()).run(step)
...     trotter, flow = trotter.decompose(reps=6), flow.decompose(reps=6)
...     dimension = 2**trotter.num_qubits
...     residuals, phases = [], []
...     for _ in range(samples):
...         vector = rng.normal(size=dimension) + 1j * rng.normal(size=dimension)
...         state = Statevector(vector / np.linalg.norm(vector))
...         a = state.evolve(trotter).data
...         b = state.evolve(flow).data
...         overlap = np.vdot(a, b)
...         phases.append(overlap / abs(overlap))
...         residuals.append(np.linalg.norm(b - a * overlap / abs(overlap)))
...     # the SAME global phase must work for every input state
...     spread = max(abs(phase - phases[0]) for phase in phases)
...     return bool(max(residuals) < 1e-9), bool(spread < 1e-9)
>>>
>>> [agrees_up_to_one_phase(reps) for reps in (1, 3)]
[(True, True), (True, True)]
שני חצאי הבדיקה הזו חשובים. חפיפה בגודל 1 על מצב בודד היא תנאי הכרחי אך לא מספיק: סינתזה שטעתה בפאזה התלויה במצב עדיין הייתה מראה זאת. הדרישה לאותה פאזה על פני כמה מצבים אקראיים היא מה שסוגר את הפער. גם בדיקה של יותר מ-reps אחד חשובה, כי היא מאשרת שההתאמה שורדת את שילוב קבוצות הזרימה ולא מתקיימת רק עבור סריקה אחת.
לכן הבחירה בסינתזה בצד ה-Qubit לא משפיעה על הדיוק, וזה מה שהופך השוואת עלויות למשמעותית. השאלה שנותרה היא מה הקידוד כולו משיג מול החלופה המובנת מאליה: Jordan-Wigner פשוט על num_sites Qubits, בלי Qubit עזר ובלי Cliffords מותאמים אישית. גם הקידוד וגם הסינתזה בצד ה-Qubit שונים בין שתי העמודות, אבל הבדיקה למעלה הראתה שהאחרונה לא יכולה להשפיע על התוצאה, ולכן מה שהנאמנויות בודקות הוא הקידוד. שתי הצנרות גם מתחילות מאותה טרוטריזציה פרמיונית, ולכן כל הבדל בנאמנות יעיד על באג ולא על פשרה. שתי העמודות הן הקידודים, קבוצות זרימה מול Jordan-Wigner:
>>> def jordan_wigner_pass_manager(mode_register, product_formula):
...     """The same pipeline under plain Jordan-Wigner: one qubit per mode."""
...     synthesis = F2QSynthesis()
...     synthesis.methods["Evolution"] = MapperFnEvolutionSynthesis(
...         transfer_vertex_jordan_wigner, product_formula=product_formula
...     )
...     qubit_register = QuantumRegister(mode_register.size, "q")
...     return MultiStagePassManager(
...         input=FermionicCircuitToDAG(),
...         layout=CustomF2QLayout({mode_register: qubit_register}),
...         synthesis=synthesis,
...         output=QuantumDAGToCircuit(),
...     )
>>>
>>> from scipy.linalg import expm
>>>
>>> jw_state = np.zeros(2**num_sites, dtype=complex)
>>> jw_state[sum(o << j for j, o in enumerate(occupations))] = 1.0
>>> reference_jw = expm(-1j * total_time * jw_matrix) @ jw_state
>>> reference_flow = expm(-1j * total_time * flow_matrix) @ (isometry @ jw_state)
>>>
>>> def cost_and_fidelity(reps):
...     step = trotter_steps(reps)
...     flow = flow_set_pass_manager(step.register, FlowSetSynthesis()).run(step)
...     jw = jordan_wigner_pass_manager(step.register, LieTrotter()).run(step)
...     flow, jw = flow.decompose(reps=6), jw.decompose(reps=6)
...     two_qubit = lambda instruction: len(instruction.qubits) == 2
...     evolved_flow = Statevector.from_label(initial_label).evolve(flow).data
...     evolved_jw = Statevector(jw_state).evolve(jw).data
...     return (
...         abs(np.vdot(evolved_flow, reference_flow)) ** 2,
...         flow.count_ops()["cx"],
...         flow.depth(two_qubit),
...         abs(np.vdot(evolved_jw, reference_jw)) ** 2,
...         jw.count_ops()["cx"],
...         jw.depth(two_qubit),
...     )
>>>
>>> for reps in (1, 2, 4, 8):
...     flow_f, flow_cx, flow_d, jw_f, jw_cx, jw_d = cost_and_fidelity(reps)
...     print(
...         f"{reps} step(s):  flow set {flow_f:.6f}"
...         f" ({flow_cx:3d} CX, depth {flow_d:3d})"
...         f"   JW {jw_f:.6f} ({jw_cx:3d} CX, depth {jw_d:3d})"
...     )
1 step(s):  flow set 0.590661 ( 22 CX, depth  12)   JW 0.590661 ( 18 CX, depth  14)
2 step(s):  flow set 0.926656 ( 44 CX, depth  24)   JW 0.926656 ( 36 CX, depth  26)
4 step(s):  flow set 0.982053 ( 88 CX, depth  48)   JW 0.982053 ( 72 CX, depth  50)
8 step(s):  flow set 0.995395 (176 CX, depth  96)   JW 0.995395 (144 CX, depth  98)
קראו קודם את עמודת הנאמנות: זהה, בכל ספרה מודפסת, בשני מרחבי הילברט שונים תחת שני קידודים שונים. זו הטרוטריזציה הפרמיונית שמשתקפת. הקירוב נקבע בשלב 5, לפני שנבחר אחד הקידודים, ולכן שני המעגלים נושאים בדיוק את השגיאה של נוסחה מסדר ראשון על פני שלוש קבוצות זרימה, והיא יורדת בערך פי ארבעה עם כל הכפלה של מספר הצעדים.
מה שהקידודים כן נבדלים בו הוא העלות, ושווה לומר את הפשרה בפשטות. קבוצת הזרימה מוציאה יותר שערי הסתבכות: 22 מול 18 בצעד אחד. Qubit העזר אינו הסיבה, כי הוא לא נושא שער דו-Qubit משלו. הסיבה היא האינטראקציה, בדיוק כפי ששלב 3 הזהיר: דה-לוקליזציה של הזוגיות הופכת שלושה איברי ZZ בין שכנים קרובים לשבעה שפורשים שכנים קרובים וגם שכנים שאחריהם, וכל אחד עולה שני שערי CX. זה המחיר שמשלמים כדי להפוך את הקפיצה לזולה.
היא גם מנצחת רק בהפרש קטן בעומק בגודל הזה (12 מול 14), כי ארבעה מודים קטן מכדי שהאסימפטוטיקה תתגלה. העיקר הוא הקנה מידה שנמדד בשלב 8: העומק 12 הזה קבוע, בעוד שהעומק של Jordan-Wigner גדל עם השרשרת. כבר ב-14 מודים זה 12 מול 34.
קריאות ה-decompose() למעלה חיוניות, משני טעמים בלתי תלויים.
evolve() ו-Operator משתמשים בהגדרה המדויקת של PauliEvolutionGate, ועוקפים סינתזה מותאמת אישית בצד ה-Qubit. אימות מול מעגל שלא פורק מדווח על נאמנות מושלמת גם עבור סינתזה שגויה במכוון.
אותו הדבר נכון רמה אחת למעלה, לסינתזה הפרמיונית. שער Evolution שלא פורק עובר לשלב הפרמיון-ל-Qubit בשלמותו, שממפה אותו בלי להתייעץ כלל עם Evolution.synthesis, ולכן reps לא היה משפיע בשקט. trotter_steps משלב 5 מבצע את הפירוק הזה; צנרת שקובעת את השיטה באמצעות F2FSynthesis מקבלת את אותה הרחבה מהמעבר עצמו.
כבדיקה צולבת אחרונה, צפיפויות האתרים שמחושבות במרחב המקודד חייבות לשחזר את התוצאה של Jordan-Wigner. הבדיקה הזו נוגעת לקידוד, לא למעגל, ולכן אף קירוב טרוטר לא נכנס אליה. שתי ההתפתחויות בזמן מחושבות במדויק, באקספוננציאציה של מטריצות של ההמילטוניאנים המתאימים. לכן כל אי-התאמה תצביע על הקידוד ולא על נוסחת מכפלה:
>>> time = 0.8
>>> state_jw = np.zeros(2**num_sites, dtype=complex)
>>> state_jw[sum(o << j for j, o in enumerate(occupations))] = 1.0
>>> evolved_jw = expm(-1j * time * jw_matrix) @ state_jw
>>> evolved_flow = expm(-1j * time * flow_matrix) @ (isometry @ state_jw)
>>>
>>> for j in range(num_sites):
...     v_flow = to_matrix(
...         SparseObservable.from_sparse_list([("ZZ", [j, j + 1], 1.0)], num_qubits)
...     )
...     v_jw = to_matrix(SparseObservable.from_sparse_list([("Z", [j], 1.0)], num_sites))
...     density_flow = (1 - np.vdot(evolved_flow, v_flow @ evolved_flow).real) / 2
...     density_jw = (1 - np.vdot(evolved_jw, v_jw @ evolved_jw).real) / 2
...     print(f"site {j}:  {density_flow:.10f}  {density_jw:.10f}")
site 0:  0.6507935456  0.6507935456
site 1:  0.5963201678  0.5963201678
site 2:  0.3365016619  0.3365016619
site 3:  0.4163846247  0.4163846247
הצפיפויות מסכימות עד עשר ספרות אחרי הנקודה.
מה לקחת מכאן
-
לקבץ לפני המיפוי. קבוצות זרימה מוגדרות על גרף האינטראקציה הפרמיוני המכוון, ולכן הקיבוץ נבחר בזמן שמבנה הבעיה עדיין זמין. התכונה
groupsנושאת אותו אל תוך המעגל, שםdecompose()אחד הופך אותו לשערEvolutionאחד לכל קבוצת זרימה. -
Qubits עזר קונים מבנה. השקעת Qubit נוסף אחד הופכת קבוצת זרימה שלמה לפאולים ממשקל 1, שההתפתחות שלהם לא צריכה שערי הסתבכות. המאמר [1] מתאר את הפשרה הזו באופן כללי. יחסי Qubit-למוד גדולים יותר מאפשרים מעגלי התפתחות רדודים יותר.
-
קידוד מותאם אישית הוא פונקציה אחת. ממפים אופרטור העברה מוכלל יחיד למחרוזת פאולי;
map_transfer_vertex_generators()ו-MapperFnEvolutionSynthesisעושים את השאר. -
המיפוי והקיבוץ לבדם לא מספיקים. פיצול ההתפתחות לפי קבוצת זרימה רק האט את הגידול הליניארי בעומק; סינתזה איבר-איבר של כל קבוצה עדיין זרקה את העובדה שהאיברים שלה מתחלפים. רק אספקת
EvolutionSynthesisשמודע לקבוצות זרימה הפכה את העומק לקבוע. קידודים מותאמים אישית, קיבוץ וסינתזה מותאמת אישית משלימים זה את זה: צריך את שלושתם. -
שתי נוסחאות מכפלה, שתי משימות.
FermionicLieTrotterקובע את הקירוב במרחב הפרמיוני, שם הקיבוץ עדיין נראה, ולכן הוא לבדו קובע את שגיאת טרוטר ואת מספר הצעדים.EvolutionSynthesisבצד ה-Qubit מחליט אז רק כמה בזול כל קבוצה ממומשת: שלב 9 מאשר ששתי הבחירות נותנות את אותו אופרטור יוניטרי. ההפרדה בין השתיים היא מה שמאפשר לכוונן את הדיוק ואת העלות באופן בלתי תלוי. ראו סינתזה של שער Evolution במרחב פרמיוני. -
לאמת. קידוד שמקיים את יחסי ההחלפה עדיין עלול לייצג המילטוניאן אחר אם גורם כפלי או סימן שגויים. בדיקת יחס שזירה (או, בזול יותר, הספקטרום) תופסת זאת.
ה-FlowSetSynthesis למעלה נכתב במכוון עבור הקידוד הזה על שרשרת חד-ממדית. הוא מתאים תבניות לתוויות הפאולי הספציפיות שהקידוד מפיק וזורק שגיאה על כל דבר אחר, במקום לחזור בשקט לנוסחת מכפלה כללית. למימוש כללי יש שני חצאים. קריאת מבנה קבוצת הזרימה מ-groups של האופרטור היא מה ש-F2FSynthesisPlugin להתפתחות כבר עושה. גזירת ה-Clifford המלכסן מחבורת היציבות, כפי שמתואר בסעיף IV C של המאמר [1], היא החצי שנשאר תלוי בקידוד.
בנוסף, דה-לוקליזציה של הזוגיות הופכת את איבר האינטראקציה לממשקל 2 ולא אלכסוני ב-Qubits בודדים, וזו העלות המקבילה לאיברי הקפיצה הזולים יותר.
הלאה: שני ממדים
כל מה שלמעלה חד-ממדי, ובכוונה. על שרשרת, קבוצות הזרימה הן פשוט שני כיווני החצים, והקידוד צריך Qubit עזר יחיד. אף אחת משתי ההפשטות האלה לא שורדת בשני ממדים, וזה המקום שבו צריך קידודים מקומיים.
על סריג מישורי, קבוצת זרימה היא מסלול מכוון (או איחוד של מסלולים מכוונים זרים בקודקודים) דרך גרף האינטראקציה, ומציאת קבוצה קטנה של מסלולים כאלה שמכסה כל קשת הופכת לבעיה קומבינטורית בפני עצמה, ולא סיווג בשתי שורות. גם אופי הקידודים משתנה; במקום Qubit עזר יחיד לכל השרשרת, הם מוסיפים אחד לכל אתר או תא בסריג. Verstraete-Cirac מזווג כל אתר פרמיוני עם Qubit עזר משלו, יחס Qubit-למוד של , ואילו Derby-Klassen ממקם אחד במרכז כל פלקט אי-זוגי, ליחס של . לפריסת הרגיסטר יש אז מבנה דו-ממדי אמיתי, וחבורת היציבות שצריך להטיל עליה כבר לא טריוויאלית. ההמילטוניאן המקודד נאמן רק על תת-מרחב, מה שמשנה גם את הכנת המצב וגם את מתכון האימות משלב 4.
הרכיבים שהמדריך הזה בונה הם אלה שעוברים הלאה: CustomF2QLayout עבור רגיסטר שגודלו שונה ממספר המודים, map_transfer_vertex_generators() עבור הקידוד עצמו, MapperFnEvolutionSynthesis לחיבור שלו ל-Transpiler, ו-EvolutionSynthesis מותאם אישית כדי שמבנה קבוצת הזרימה ישתלם. רק הקידוד ופירוק קבוצות הזרימה שונים.
המדריך לקבוצות זרימה דו-ממדיות ממשיך מכאן, ועובר על קידוד Verstraete-Cirac על סריג ריבועי: ארבע קבוצות זרימה, Clifford בעומק 2 לכל אחת, והטלה על חבורת היציבות שהאימות צריך אחר כך.
A. Gandon, S. Piccinelli, M. Rossmannek, F. Tacchino, A. Baiardi, J. Nys, and I. Tavernelli, Stabilizer-based quantum simulation of fermion dynamics with local qubit encodings (2026), arXiv:2512.11418v2.