Postselection עם בדיקות שגיאה לא-מרקוביות
המדריך הזה מסביר מה הן בדיקות שגיאה לא-מרקוביות ואיך לממש אותן בתוכנה באמצעות qiskit-mitigation. תתחיל בדוגמה קטנה של שני Qubits כדי להמחיש את הבדיקות ולדון באיך הן עובדות. אחרי שתבנה קצת אינטואיציה, תנסה דוגמה של 20 Qubits שבה תממש בדיקות ותשווה אסטרטגיות postselection שונות.
מה הן בדיקות שגיאה לא-מרקוביות?
בדיקות שגיאה לא-מרקוביות הן בדיקות מבוססות מדידה שבודקות אם המצב של Qubit כנראה נפגם על ידי מקור שגיאה לא-מרקובי. הבדיקה נעשית על ידי הצבת שער היפוך ביט עם משך מוארך (xslow או סדרה של שערי rx בזווית ) על כל Qubit בתחילת המעגל, ואחריו XGate רגיל ומדידה כדי לוודא שהמצב התהפך בהצלחה . אפשר לבצע את הבדיקה הזו גם בסוף המעגל אחרי כל מדידה סופית, כדי לוודא שהמכשיר מצליח להפוך את המצב הנמדד של ה-Qubit מ-. דגימות שמשויכות לבדיקות שנכשלו עשויות להיחשב לא אמינות, ו-postselection של דגימות שעוברות את כל הבדיקות בלבד יכול לשפר את הנאמנות (fidelity) של ההתפלגות הרועשת.
אסטרטגיות ל-postselection על סמך בדיקות שגיאה לא-מרקוביות
-
Postselection מבוסס צמתים: בוחרים רק דגימות שבהן כל Qubit עבר את הבדיקה (או הבדיקות) שלו. זו האסטרטגיה המחמירה ביותר, והיא בדרך כלל גורמת לכך שיותר דגימות נזרקות.
-
Postselection מבוסס צלעות: לכל צלע בגרף הצימוד של ה-Qubits, מוודאים שלפחות Qubit אחד עובר את הבדיקה (או הבדיקות). האסטרטגיה הזו מקלה יותר; אם Qubit נכשל בבדיקה, אפשר עדיין לשמור את הדגימה אם כל שכניו עוברים את הבדיקות שלהם.
Qubits צופים (Spectator)
אפשר לציין Qubits עזר "צופים" (spectator) שצמודים ל-Qubits ששימשו להרצת המעגל המקורי. אפשר להציב בדיקות שגיאה לא-מרקוביות על הצופים האלה, וכך לקבל כיסוי רחב יותר נגד הרעש הלא-מרקובי שהבדיקות האלה נועדו לזהות.
חלק 1. המחשת בדיקות שגיאה לא-מרקוביות
לפני שמדגימים את הטכניקה על QPU, תיצור מעגל קטן של שני Qubits ותוסיף בדיקות כדי להמחיש איך זה עובד. התחל במצב Bell שעבר transpile ל-QPU של ה-Backend ibm_kingston.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"matplotlib": "matplotlib", "numpy": "numpy", "qiskit": "qiskit", "qiskit_ibm_runtime": "qiskit-ibm-runtime", "qiskit_mitigation": "qiskit-mitigation", "samplomatic": "samplomatic"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
from qiskit import QuantumCircuit
from qiskit.transpiler import generate_preset_pass_manager
from qiskit_ibm_runtime import QiskitRuntimeService

service = QiskitRuntimeService(channel="ibm_quantum_platform")
backend = service.backend("ibm_kingston")

qc = QuantumCircuit(2)
qc.h(0)
qc.cx(0, 1)
qc.measure_all()
qc_isa = generate_preset_pass_manager(
    optimization_level=0, backend=backend
).run(qc)
qc_isa.draw("mpl")

הוסף כמה בדיקות שגיאה לא-מרקוביות לתחילת המעגל. בדיקות יוצבו רק על Qubits שמסתיימים במדידה. הבדיקות האלה מוודאות שהמכשיר מצליח להפוך את המצב ההתחלתי של ה-Qubit , והמדידות של הבדיקות האלה נקראות לרגיסטר קלאסי חדש בשם meas_pre.
from qiskit.transpiler import PassManager
from qiskit_mitigation.postselection.passes import (
    AddPreCircuitNonMarkovianErrorChecks,
)

qc_w_checks = PassManager([AddPreCircuitNonMarkovianErrorChecks()]).run(
    qc_isa
)
qc_w_checks.draw("mpl", idle_wires=False)

באופן דומה, אפשר להוסיף בדיקות לסוף המעגל אחרי כל מדידה סופית. הבדיקות האלה מוודאות שהמכשיר מצליח להפוך את מצב ה-Qubit מ-, והמדידות שלהן נקראות לרגיסטר קלאסי חדש בשם meas_ps.
from qiskit_mitigation.postselection.passes import (
    AddPostCircuitNonMarkovianErrorChecks,
)

qc_w_checks = PassManager([AddPostCircuitNonMarkovianErrorChecks()]).run(
    qc_w_checks
)
qc_w_checks.draw("mpl", idle_wires=False)

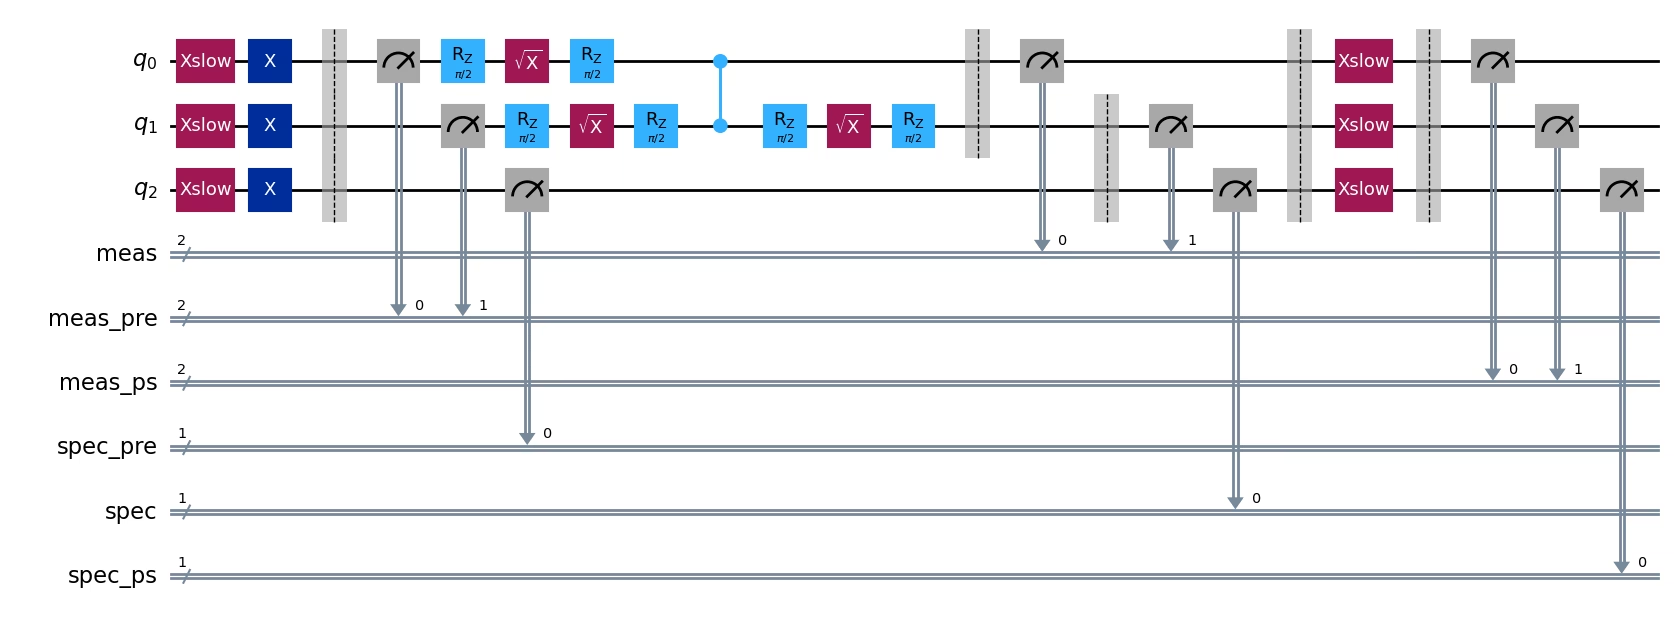
כפי שצוין בהקדמה, אפשר להשתמש ב-qubits עזר (ancilla) הסמוכים ל-qubits הנתונים בתור "צופים" (spectators) כדי לספק כיסוי רחב יותר של שגיאות. מוסיפים בדיקות צופים לפני המעגל ואחריו. אפשר לראות שמכיוון ש-qubit פיזי 2 ב-ibm_kingston סמוך ל-qubit הנתונים 1, הוא נוסף כצופה, והוספו אליו בדיקות לפני המעגל ואחריו. מדידות הצופים נוספו לרגיסטרים קלאסיים חדשים בשם spec_pre ו-spec.
מעגל כזה מכיל את כל בדיקות השגיאות הלא-מרקוביות האפשריות, ולכן דגימה ממנו מאפשרת למשתמשים לבצע postselection לפי כל שילוב של בדיקות [לפני/אחרי]-המעגל ואסטרטגיית postselection מבוססת [צמתים/קשתות]. בחלק 2 של המדריך הזה אפשר לראות איך זה עובד על חומרה קוונטית.
from qiskit_mitigation.postselection.passes import (
    AddSpectatorPostCircuitNonMarkovianErrorChecks,
    AddSpectatorPreCircuitNonMarkovianErrorChecks,
)

qc_w_checks = PassManager(
    [
        AddSpectatorPreCircuitNonMarkovianErrorChecks(
            coupling_map=backend.coupling_map
        ),
        AddSpectatorPostCircuitNonMarkovianErrorChecks(
            coupling_map=backend.coupling_map
        ),
    ]
).run(qc_w_checks)
qc_w_checks.draw("mpl", idle_wires=False, fold=-1)
חלק 2: הדגמת בדיקות שגיאות לא-מרקוביות על QPU והשוואה בין אסטרטגיות postselection
עכשיו, כשאתם מבינים מה הן בדיקות שגיאות לא-מרקוביות ואיך מממשים אותן בתוכנה, אפשר להריץ דוגמה גדולה יותר על QPU ולראות איך זה עובד. קודם כול מכינים מעגל. הבחירה במעגל לא כל כך חשובה; צריך רק מעגל שאפשר לאמת בקלות את הפלט שלו. כאן בחרנו מעגל איזינג מראתי חד-ממדי של 20 qubits. קשה יחסית להריץ את המעגל הזה על חומרה, והוא אמור להיות מושפע משגיאות לא-מרקוביות, מה שנותן הזדמנות להדגים את האפקטיביות של הבדיקות. בנוסף, המבנה המראתי מאפשר לנו להשוות בקלות את חישובי ערכי התצפית הרועשים לערכים המדויקים.
בניסוי הזה אנחנו מחשבים ערכי תצפית של observable. הבחירה ב-observable גם היא לא חשובה, ולכן בחרנו פשוט את הצפנה (magnetization) הממוצעת של אתר בודד .
import numpy as np
from qiskit.quantum_info import SparsePauliOp
from qiskit.transpiler import CouplingMap

num_qubits = 20
initial_layout = initial_layout = [
    124,
    125,
    126,
    127,
    128,
    129,
    130,
    131,
    132,
    133,
    134,
    135,
    139,
    155,
    154,
    153,
    152,
    151,
    150,
    149,
][:num_qubits]
coupling_map = CouplingMap.from_line(num_qubits, bidirectional=False)

# Num Trotter steps and `rx` angle
num_steps = 6
theta_rx = np.pi / 6

# Average single-site magnetization
observable = (
    SparsePauliOp(
        [
            "I" * iq + "Z" + "I" * (num_qubits - iq - 1)
            for iq in range(num_qubits)
        ]
    )
    / num_qubits
)

# Create the Trotter circuit
circuit = QuantumCircuit(num_qubits)
edges = CouplingMap.from_line(num_qubits, bidirectional=False).get_edges()
edges_a = [e for e in edges if e[0] % 2 == 0]
edges_b = [e for e in edges if e[0] % 2 == 1]
for _ in range(num_steps):
    circuit.rx(theta_rx, [i for i in range(num_qubits)])
    for edge in edges_a:
        circuit.cz(edge[0], edge[1])
    for edge in edges_b:
        circuit.cz(edge[0], edge[1])
circuit = circuit.compose(circuit.inverse())
circuit.measure_all()

# Transpile circuit to backend
pm = generate_preset_pass_manager(
    optimization_level=0, backend=backend, initial_layout=initial_layout
)
isa_circuit = pm.run(circuit)
print(
    f"two-qubit depth: {isa_circuit.depth(lambda instr: instr.operation.num_qubits == 2)}"
)
print(f"total depth:     {isa_circuit.depth()}")
isa_circuit.draw("mpl", fold=-1, idle_wires=False)
two-qubit depth: 24
total depth:     85
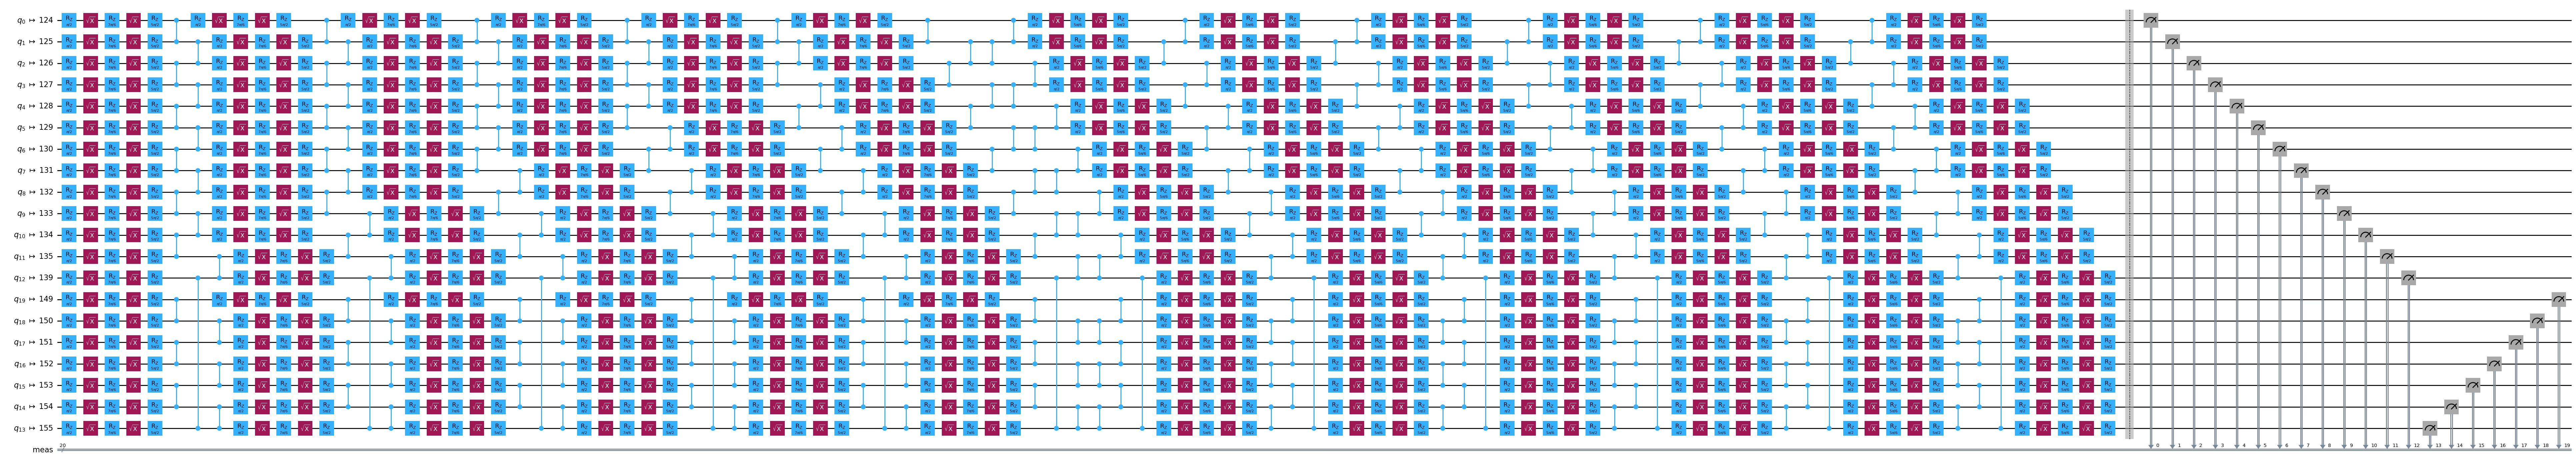
עכשיו מוסיפים בדיקות לפני המעגל ואחריו על כל qubit, כולל שבעת ה-qubits הצופים הסמוכים. כשמוסיפים למעגל את כל הבדיקות האפשריות, אפשר להחליט באיזו אסטרטגיית postselection להשתמש בזמן העיבוד שלאחר הריצה.
# Use all non-Markovian error checks so we can compare all strategies in post-processing.
combined = PassManager(
    [
        AddPreCircuitNonMarkovianErrorChecks(x_pulse_type="rx"),
        AddSpectatorPreCircuitNonMarkovianErrorChecks(
            backend.coupling_map, x_pulse_type="rx"
        ),
        AddPostCircuitNonMarkovianErrorChecks(x_pulse_type="rx"),
        AddSpectatorPostCircuitNonMarkovianErrorChecks(
            backend.coupling_map, x_pulse_type="rx"
        ),
    ]
).run(isa_circuit)
combined_isa = generate_preset_pass_manager(
    optimization_level=0, backend=backend
).run(combined)

print("cregs:", [(c.name, c.size) for c in combined_isa.cregs])
cregs: [('meas', 20), ('meas_pre', 20), ('spec_pre', 7), ('meas_ps', 20), ('spec', 7), ('spec_ps', 7)]
משתמשים בפרימיטיב Executor כדי לדגום את המעגל שמכיל את הבדיקות.
from qiskit_ibm_runtime import Executor
from samplomatic.quantum_program import QuantumProgram

# Raw and combined-checks circuits in a single 100k-shot program so they share calibration.
program = QuantumProgram(shots=100_000)
program.append_circuit_item(isa_circuit)  # raw circuit, no checks
program.append_circuit_item(
    combined_isa
)  # combined pre + post non-Markovian error checks
job = Executor(backend).run(program)
print(f"job id: {job.job_id()}")
print(f"status: {job.status()}")
job id: d9badrm6hjac73ffe31g
status: QUEUED
המחלקה PostSelector מכירה את מבנה ה-creg של הבדיקות, ולכן היא יכולה לשייך כל ביט בדגימות למדידת המעגל שלו. אפשר להשתמש בשיטה compute_mask שלה כדי ליצור מסכה על רצף דגימות, בהינתן אסטרטגיית ה-postselection (צמתים או קשתות) וסוג בדיקות השגיאות הלא-מרקוביות שרוצים לבחון (לפני המעגל או אחריו). כדי לשלב אסטרטגיות של לפני המעגל ואחריו למסכה אחת, אפשר לחשב את המסכות שלהן בנפרד ואז לשלב אותן בפעולת AND. כאן משתמשים ב-PostSelector כדי ליצור מסכות לכל האסטרטגיות השונות, ובוחנים את התוצאות בכל תמורה אפשרית של האסטרטגיות.
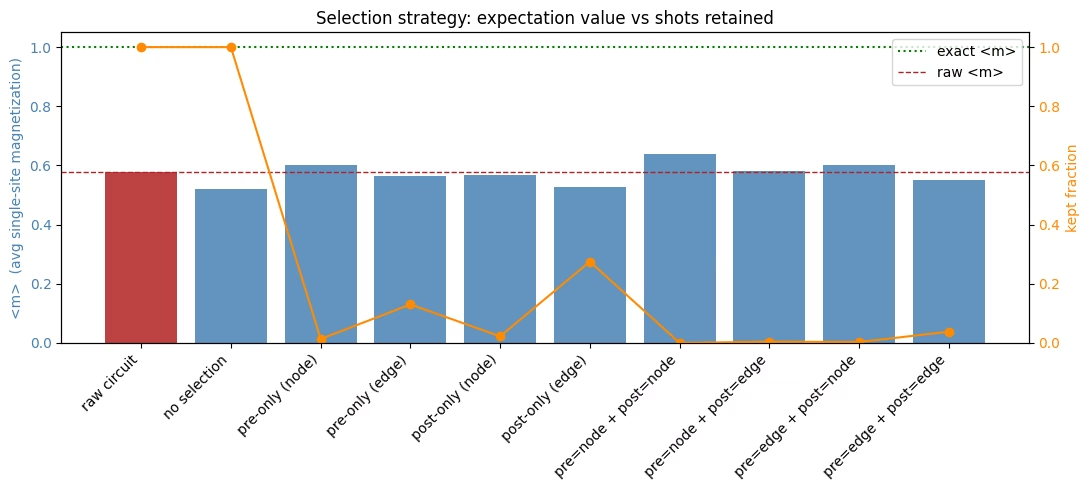
בהצגה החזותית שלמטה רואים איך אסטרטגיית ה-postselection משפיעה על שיעור ה-postselection וגם על איכות התשובה. כצפוי, האסטרטגיות שמבוססות על postselection לפי צמתים הניבו את שיעורי ה-postselection הנמוכים ביותר. האסטרטגיות מבוססות הקשתות מתירניות יותר ונוטות להניב שיעורי postselection גבוהים יותר. כדאי למשתמשים לנסות את האסטרטגיות השונות על הבעיה שלהם כדי למצוא את האיזון הנכון בין שיעור ה-postselection לאיכות ההתפלגות הנדגמת. בדוגמה הזאת, שימוש ב-postselection לפי צמתים עם בדיקות לפני המעגל ואחריו הניב את התשובה הטובה ביותר, עם שיעור postselection של .028%. חלק מהאסטרטגיות לא עקפו את המעגל הגולמי. אפשר לראות גם שהוספת הבדיקות בלי להשתמש באף אחת מהן (העמודה שמסומנת "no selection" בתרשים שלמטה) נותנת את התוצאה הגרועה ביותר.
import matplotlib.pyplot as plt
from qiskit_mitigation.postselection import PostSelector

selector = PostSelector.from_circuit(combined_isa, backend.coupling_map)

exec_results = job.result()
# The Executor returns numpy arrays keyed by classical-register name, so each result item is
# already the {creg_name: ndarray} mapping that compute_mask expects.
raw_bits = exec_results[0]["meas"]  # raw circuit, no checks
bits = exec_results[1]  # combined pre+post circuit

meas_bits = bits["meas"]
total = meas_bits[..., 0].size

def magnetization(b, mask=None):
    """Average single-site magnetization over the (optionally masked) measurement bits."""
    kept = b if mask is None else b[mask]
    return (1 - 2 * kept.astype(int)).mean()  # bit 0 -> +1, bit 1 -> -1

rows = []

def report(label, mask=None, b=meas_bits):
    """Record and print the magnetization and kept fraction for one selection strategy."""
    kept = b[..., 0].size if mask is None else int(mask.sum())
    ev = magnetization(b, mask)
    rows.append((label, ev, kept / total))
    print(f"{label:<24}: <m> = {ev:+.4f}   (kept {kept:>6}/{total})")

# Compare all possible postselection strategies
report("raw circuit", b=raw_bits)
report("no selection")
for s in ("node", "edge"):
    report(f"pre-only ({s})", selector.compute_mask(bits, s, mode="pre"))
for s in ("node", "edge"):
    report(f"post-only ({s})", selector.compute_mask(bits, s, mode="post"))
for pre_s in ("node", "edge"):
    for post_s in ("node", "edge"):
        keep = selector.compute_mask(
            bits, pre_s, mode="pre"
        ) & selector.compute_mask(bits, post_s, mode="post")
        report(f"pre={pre_s} + post={post_s}", keep)

labels = [r[0] for r in rows]
evs = [r[1] for r in rows]
fracs = [r[2] for r in rows]
x = range(len(labels))

fig, ax1 = plt.subplots(figsize=(11, 5))

# Bars: expectation value per selection strategy.
bar_colors = ["firebrick"] + ["steelblue"] * (len(evs) - 1)
ax1.bar(x, evs, color=bar_colors, alpha=0.85)
ax1.axhline(1.0, color="green", ls=":", lw=1.5, label="exact <m>")
ax1.axhline(rows[0][1], color="firebrick", ls="--", lw=1, label="raw <m>")
ax1.set_ylabel("<m>  (avg single-site magnetization)", color="steelblue")
ax1.tick_params(axis="y", labelcolor="steelblue")
ax1.set_xticks(list(x))
ax1.set_xticklabels(labels, rotation=45, ha="right")
ax1.legend(loc="upper right")

# Line: fraction of shots retained (right axis).
ax2 = ax1.twinx()
ax2.plot(x, fracs, "o-", color="darkorange")
ax2.set_ylabel("kept fraction", color="darkorange")
ax2.tick_params(axis="y", labelcolor="darkorange")
ax2.set_ylim(0, 1.05)

ax1.set_title("Selection strategy: expectation value vs shots retained")
fig.tight_layout()
plt.show()
raw circuit             : <m> = +0.5791   (kept 100000/100000)
no selection            : <m> = +0.5211   (kept 100000/100000)
pre-only (node)         : <m> = +0.6026   (kept   1357/100000)
pre-only (edge)         : <m> = +0.5637   (kept  13029/100000)
post-only (node)        : <m> = +0.5682   (kept   2254/100000)
post-only (edge)        : <m> = +0.5265   (kept  27514/100000)
pre=node + post=node    : <m> = +0.6393   (kept     28/100000)
pre=node + post=edge    : <m> = +0.5799   (kept    442/100000)
pre=edge + post=node    : <m> = +0.6006   (kept    317/100000)
pre=edge + post=edge    : <m> = +0.5521   (kept   3836/100000)