רענון תכונות backend עם בנצ'מרקינג בזמן אמת
אומדן שימוש: 3 דקות על ibm_kingston (הערה: זהו אומדן בלבד. זמן הריצה שלכם עשוי להשתנות.)
תוצאות למידה
-
מדוע התכונות המדווחות על ידי QPU יכולות לפגר אחרי ההתנהגות הנוכחית של המכשיר, ומתי כדאי למדוד אותן מחדש בעצמכם
-
מה כל אחד מחמשת ניסויי האפיון הסטנדרטיים (קריאה, בנצ'מרקינג אקראי חד-קיוביטי, בנצ'מרקינג אקראי שכבתי דו-קיוביטי, , ו-) מודד
-
כיצד להריץ את חבילת האפיון המלאה בקריאה אחת או שלב אחר שלב, ולקבל בחזרה אובייקט backend עם תכונות מרועננות
-
כיצד להשוות בין התכונות הנמדדות לבין המדווחות, ומדוע חלק מההבדלים משקפים מתודולוגיית מדידה ולא סחיפה של המכשיר
דרישות קדם
-
זרימת העבודה של דפוסי Qiskit
-
מצבי הרצה של Qiskit Runtime, במיוחד batch mode
-
איך לחקור מידע QPU, כמו מאפייני Backend ונתוני כיול
רקע
כל QPU של IBM Quantum® מדווח על קבוצת מאפיינים שמתארים עד כמה כל אחד מהקיוביטים שלו עובד כרגע: זמני רלקסציה (), זמני קוהרנטיות (), שגיאות קריאה, ושגיאות שערים של קיוביט אחד ושניים. המספרים האלה חשובים בפועל. ה-Transpiler משתמש בהם כדי להחליט על אילו קיוביטים פיזיים ה-Circuit שלך אמור לרוץ, טכניקות הפחתת שגיאות מסתמכות עליהם, ואתה עשוי להשתמש בהם כדי לשפוט אם ההתקן עובד מספיק טוב לניסוי מסוים.
המאפיינים המדווחים מגיעים מתהליכי כיול שרצים בדרך כלל בערך פעם ביום. עם זאת, קיוביטים על-מוליכים יכולים לנדוד על פני קני מידה קצרים יותר של זמן, ופגמים חולפים (מה שמכונה מערכות דו-רמתיות) יכולים להחליש באופן זמני קיוביט שנראה מצוין בזמן הכיול. בנוסף, עבודה לרוב עוברת Transpile הרבה לפני שהיא בפועל מתבצעת, כך שהחלטות המבוססות על המאפיינים המדווחים יכולות להסתמך על מידע לא עדכני. המדריך Real-time benchmarking for qubit selection מראה עד כמה המאפיינים האלה יכולים להשתנות מיום ליום, ובונה תהליך אפיון מלא באופן ידני מתוך Qiskit Experiments בודדים.
מדריך זה מציג את הגרסה הייעילה יותר של תהליך העבודה הזה, על ידי שימוש בכלי BackendCharacterization מתוך Qiskit Device Benchmarking, שאורז את בניית הניסויים, שליחת ה-Jobs, והתאמת העקומות בכמה קריאות בודדות. אתה משקיע כ-70 שניות של זמן QPU ומקבל בחזרה אובייקט Backend שהמאפיינים שלו משקפים את ההתקן כרגע, מוכן להשוואה מול הערכים המדווחים או להעברה לכלים נוספים בהמשך.
ניסויי האפיון
החבילה מודדת חמישה מאפיינים, כל אחד עם ניסוי סטנדרטי:
-
שגיאת קריאה (
readout): כל קיוביט מוכן במצב או ומיד נמדד. ההסתברות לקרוא את המצב השגוי נותנת את שגיאת הכנת המצב והמדידה (SPAM). -
שגיאת שער קיוביט בודד (
rb_1q): בנצ'מרקינג אקראי (RB) מריץ רצפים של שערי Clifford אקראיים על קיוביט בודד שהרכבתם, במקרה האידיאלי, שקולה לאופרטור הזהות. האופן שבו הסתברות ההישרדות דועכת עם אורך הרצף נותן את השגיאה הממוצעת לכל שער, ללא תלות בשגיאות SPAM. -
שגיאת שער שני קיוביטים (
rb_2q): אותו רעיון של RB מיושם על שכבות מלאות של שערי שני קיוביטים שאינם חופפים, המבוצעים בו זמנית, כמו בניסוי layer fidelity. מכיוון שהרבה שערים רצים בו זמנית, שיעורי השגיאה המתקבלים כוללים אפקטים של crosstalk וקרובים יותר למה שCircuit עמוק חווה בפועל. -
(
t1): כל קיוביט מועלה לאנרגיה ונמדד לאחר עיכובים גדלים. הדעיכה של אכלוס המצב המעורר נותנת את זמן הרלקסציה. -
(
t2): ניסוי הד Hahn ממקם כל קיוביט בסופרפוזיציה, מפעיל פולס הד באמצע העיכוב, ומודד עד כמה מהר קוהרנטיות הפאזה אובדת. כברירת מחדל נעשה שימוש בהד יחיד; וריאנט מרובה-הדים (בסגנון CPMG) מודגם בסוף מדריך זה.
מה הרענון עושה ומה הוא לא עושה
זכור שלוש נקודות בעת השימוש בתהליך עבודה זה:
-
המאפיינים המרועננים חיים רק באובייקט ה-Backend שמוחזר אליך. שום דבר לא משתנה בהתקן עצמו או בנתוני הכיול ש-IBM Quantum מדווחת למשתמשים אחרים.
-
הערכים הנמדדים הם תמונת מצב שנלקחה במתודולוגיה מסוימת. חלקם, ובעיקר שגיאות השכבות של שני קיוביטים וערכי בהד יחיד שנמדדו במקביל, נמדדים בצורה שונה מנתוני הכיול המדווחים, כך שחלק מכל פער שתצפה בו הוא מתודולוגי ולא נדידה. מדריך זה מציין היכן זה קורה.
-
האפיון עצמו עולה בזמן QPU (בערך 70 שניות עבור החבילה המלאה על מעבד Heron r2), וזהו המחיר של מידע עדכני.
תהליך העבודה עוקב אחר ארבעת השלבים של דפוס Qiskit:
-
שלב 1: מיפוי קלטים קלאסיים לבעיה קוונטית. בחר את ההתקן ואת קבוצת המאפיינים למדידה.
-
שלב 2: אופטימיזציה של הבעיה לביצוע על חומרה קוונטית. הכלי בונה את מעגלי הניסוי ישירות בשערים המקוריים של ההתקן ומריץ אותם במקביל על השבב.
-
שלב 3: ביצוע באמצעות פרימיטיבים של Qiskit. הניסויים רצים כ-Jobs של Sampler בתוך Batch.
-
שלב 4: עיבוד לאחר וקבלת התוצאה בפורמט קלאסי רצוי. התאם את נתוני המדידה למפות שגיאה לכל קיוביט, רענן את ה-Backend, והשווה בין המאפיינים הנמדדים לבין המדווחים.
דרישות
לפני תחילת מדריך זה, ודא שהתקנת את הדברים הבאים:
-
Qiskit SDK גרסה 2.0 ואילך, עם תמיכת ויזואליזציה
-
Qiskit Runtime גרסה 0.40 ואילך (
pip install qiskit-ibm-runtime) -
Qiskit Device Benchmarking, שמתקין גם Qiskit Experiments (
pip install git+https://github.com/qiskit-community/qiskit-device-benchmarking.git)
הגדרה
ייבא את הספריות הנדרשות.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"numpy": "numpy", "qiskit_device_benchmarking": "git+https://github.com/qiskit-community/qiskit-device-benchmarking.git", "qiskit_ibm_runtime": "qiskit-ibm-runtime"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
import logging
import sys

import numpy as np
from qiskit_ibm_runtime import Batch, QiskitRuntimeService

from qiskit_device_benchmarking.utilities.characterization_utils import (
    BackendCharacterization,
    plot_characterization_comparison,
)
חבילת האפיון בונה כמה ניסויים, שולחת מספר Jobs, ומתאימה את התוצאות, מה שיכול לקחת כמה דקות בסך הכול. הפעל תיעוד ברמת INFO כך שכל שלב ידפיס את ההתקדמות שלו כשהיא קורית.
logger = logging.getLogger("qiskit_device_benchmarking")
logger.setLevel(logging.INFO)
logger.addHandler(logging.StreamHandler(stream=sys.stdout))
דוגמת סימולטור בקנה מידה קטן
מדריך זה אינו כולל דוגמת סימולטור. תהליך העבודה מודד את אי-השלמויות הפיזיות של התקן ספציפי: באיזו מהירות הקיוביטים שלו עוברים רלקסציה ומאבדים פאזה, ובאיזו תדירות השערים והקריאה שלו נכשלים. לסימולטור אידיאלי אין אף אחת מאי-השלמויות האלה, כך שאין מה לאפיין. תוכל לצרף מודל רעש סינתטי ל-Backend מזויף, אך אז הניסויים ישחזרו רק את המספרים שהזנת בעצמך. מסיבה זו, אנחנו עוברים ישירות לחומרה, בחלוקה לארבעת השלבים של דפוס Qiskit.
דוגמת חומרה בקנה מידה גדול
שלב 1: מיפוי קלטים קלאסיים לבעיה קוונטית
בתהליך עבודה זה ה"בעיה" היא ההתקן עצמו: הקלטים הקלאסיים הם ה-QPU שברצונך לאפיין ורשימת המאפיינים למדידה, והניסויים הקוונטיים הם מעגלי האפיון שנוצרים מהם.
ראשית, בחר Backend. מדריך זה משתמש ב-ibm_kingston, מעבד Heron r2 בעל 156 קיוביטים; אתה יכול להחליף בכל התקן IBM Quantum שיש לך גישה אליו (או לבחור אחד באמצעות service.least_busy()).
service = QiskitRuntimeService()
device = "ibm_kingston"
backend = service.backend(device)
לאחר מכן, בחר אילו מאפיינים למדוד. אתה יכול להעביר כל תת-קבוצה של הניסויים הבאים:
-
readout: ניסוי SPAM (הכנת מצב ומדידה) -
rb_1q: בנצ'מרקינג אקראי מבודד לקיוביט בודד -
rb_2q: בנצ'מרקינג אקראי בו-זמני לשני קיוביטים מתוך ניסוי layer fidelity -
t2: ניסוי הד Hahn של (הד יחיד כברירת מחדל) -
t1: ניסוי רלקסציה של
הרץ את החבילה המלאה כדי לקבל תמונה מלאה של ההתקן; השמט ערכים מהרשימה אם אכפת לך רק מחלק מהמאפיינים ואתה רוצה לחסוך בזמן QPU.
experiments = ["readout", "rb_1q", "rb_2q", "t1", "t2"]
שלב 2: אופטימיזציה של הבעיה לביצוע על חומרה קוונטית
ברוב המדריכים, בשלב הזה היית מבצע Transpile למעגלים שלך. כאן, BackendCharacterization דואג לכך באופן פנימי. הוא בונה את מעגלי הניסוי ישירות בשערים המקוריים של ההתקן, מריץ את ניסויי הקיוביט הבודד על כל הקיוביטים במקביל, ומתזמן את הבנצ'מרקינג האקראי של שני הקיוביטים על פני שכבות זרות של מפת הצימוד כך שכל ההתקן מכוסה בכמה Jobs בודדים. בשל ריצה מקבילית זו, כל החבילה צורכת רק כ-70 שניות של זמן QPU.
אתחל את המחלקה שמנהלת את תהליך העבודה:
# Initialize the class used to run the experiments
characterizer = BackendCharacterization(backend)
שלב 3: ביצוע באמצעות פרימיטיבים של Qiskit
השיטה run_experiments בונה את המעגלים ושולחת אותם כ-Jobs של Sampler. הרץ אותה בתוך הקשר של Batch כך שה-Jobs יתוזמנו יחד על ה-QPU, והשיטה מחזירה תוצאה ברגע שכל ה-Jobs נשלחו. (אתה יכול גם להריץ אותה מחוץ ל-Batch, או בתוך Session.)
ייתכן שתראו אזהרה על backend שמועבר בזמן שמנהל ההקשר (context manager) של session פתוח. זה צפוי וניתן להתעלם ממנו בבטחה.
# Run the characterization experiments inside a Batch
with Batch(backend=backend):
    jobs = characterizer.run_experiments(experiments=experiments)
base_primitive.get_mode_service_backend:WARNING:2026-07-14 14:23:02,051: A backend was passed in as the mode but a session context manager is open so this job will run inside this session/batch instead of in job mode.
Building readout experiments
Building 1Q RB experiments
Building 2Q RB experiments
Building T1 experiments
Building T2 experiments
Layered two-qubit RB submitted: ['d9b7tfu6hjac73ffba2g', 'd9b7tjug26ic73dfju3g', 'd9b7u3u6hjac73ffban0', 'd9b7u7rv6alc73csmicg']
Readout job submitted: d9b7u8bv6alc73csmidg
T1 experiment submitted: ['d9b7u8ug26ic73dfjuqg']
T2 (Hahn) experiment submitted: ['d9b7u9fu62qs738othg0']
Single-qubit RB submitted: ['d9b7v8m6hjac73ffbc40', 'd9b7veeg26ic73dfk040']
השיטה מחזירה את ה-Jobs שנשלחו כמילון ממופתח לפי ניסוי, מה שמועיל למעקב אחריהם בלוח הבקרה של IBM Quantum Platform או לצורך ניפוי שגיאות.
# Print all the job IDs for debugging purposes
jobs
{'rb_2q': [<RuntimeJobV2('d9b7tfu6hjac73ffba2g', 'sampler')>,
  <RuntimeJobV2('d9b7tjug26ic73dfju3g', 'sampler')>,
  <RuntimeJobV2('d9b7u3u6hjac73ffban0', 'sampler')>,
  <RuntimeJobV2('d9b7u7rv6alc73csmicg', 'sampler')>],
 'readout': [<RuntimeJobV2('d9b7u8bv6alc73csmidg', 'sampler')>],
 't1': [<RuntimeJobV2('d9b7u8ug26ic73dfjuqg', 'sampler')>],
 't2': [<RuntimeJobV2('d9b7u9fu62qs738othg0', 'sampler')>],
 'rb_1q': [<RuntimeJobV2('d9b7v8m6hjac73ffbc40', 'sampler')>,
  <RuntimeJobV2('d9b7veeg26ic73dfk040', 'sampler')>]}
שלב 4: עיבוד לאחר וקבלת התוצאה בפורמט קלאסי רצוי
נתח את התוצאות
השיטה analyze_results ממתינה לסיום ה-Jobs ומתאימה את נתוני המדידה: דעיכות אקספוננציאליות עבור ו-, דעיכות הסתברות הישרדות עבור ניסויי ה-RB, ומטריצות שיוך עבור קריאה. היא מחזירה מילון של מפות שגיאה, ערך אחד עבור כל מאפיין נמדד, כל אחד ממפה קיוביט (או זוג קיוביטים) לערכו הנמדד.
error_maps = characterizer.analyze_results()
print(f"The following error maps are available: {list(error_maps.keys())}")
readout_q0 = error_maps["readout_error"][0]
print(f"For example, readout error for qubit 0 is {readout_q0}")
The following error maps are available: ['readout_error', 'oneq_error_x', 'oneq_error_sx', 'lf_error_map', 't1_map', 't2_map']
For example, readout error for qubit 0 is 0.007600000000000051
המפות מכסות שגיאת קריאה, שגיאות שערי x ו-sx של קיוביט בודד, שגיאות שכבות של שני קיוביטים (lf_error_map, מניסוי layer fidelity), וזמני ו- בשניות.
עדכן את מאפייני ה-Backend
השיטה update_backend כותבת את הערכים הנמדדים למאפיינים של עותק ה-Backend ומחזירה אותו. אובייקט ה-backend המקורי שומר על נתוני הכיול המדווחים, כך שנוכל להשוות בין השניים, כפי שמוצג בהמשך. זכור שעדכון זה הוא מקומי לחלוטין להפעלת Python שלך; הוא לא משנה שום דבר בהתקן או עבור משתמשים אחרים.
backend_updated = characterizer.update_backend()
Updating readout error
Updating single-qubit X error
Updating single-qubit SX error
Updating two-qubit error
Updating T1
Updating T2
השווה בין המאפיינים הנמדדים לבין המדווחים
לבסוף, שרטט את המאפיינים הנמדדים בזמן אמת מול הערכים שה-Backend מדווח. בכל פאנל הקיוביטים (או זוגות הקיוביטים) ממוינים לפי הערך הנמדד, כך שהעקומה הנמדדת חלקה מבנייתה, והפיזור של הערכים המדווחים סביבה מראה היכן השניים לא מסכימים. תרשים בודד מוצג עבור RB של קיוביט בודד מכיוון שאותה שגיאה נמדדת לכל שער מוקצית הן לשער x והן לשער sx. גבולות הצירים נבחרים מתוך רוב הנתונים כך שכמה חריגים קיצוניים לא ידחסו את התרשימים; כל נקודה מחוץ לטווח נספרת בהערה על התרשים (או העבר את ylim כדי לעקוף את הגבולות).
plot_characterization_comparison(
    old_props=backend.properties().to_dict(),
    new_props=backend_updated.properties().to_dict(),
    plots=["readout", "rb_1q", "rb_2q", "t1", "t2"],
)
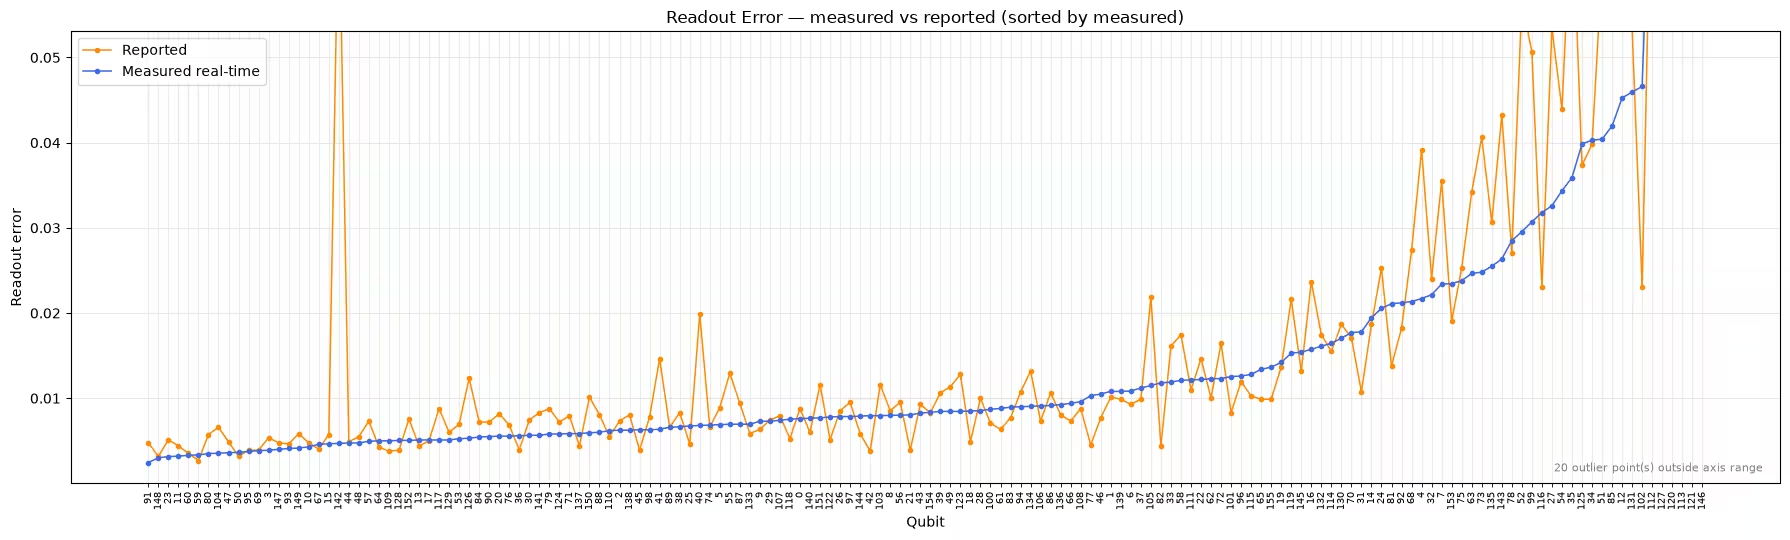
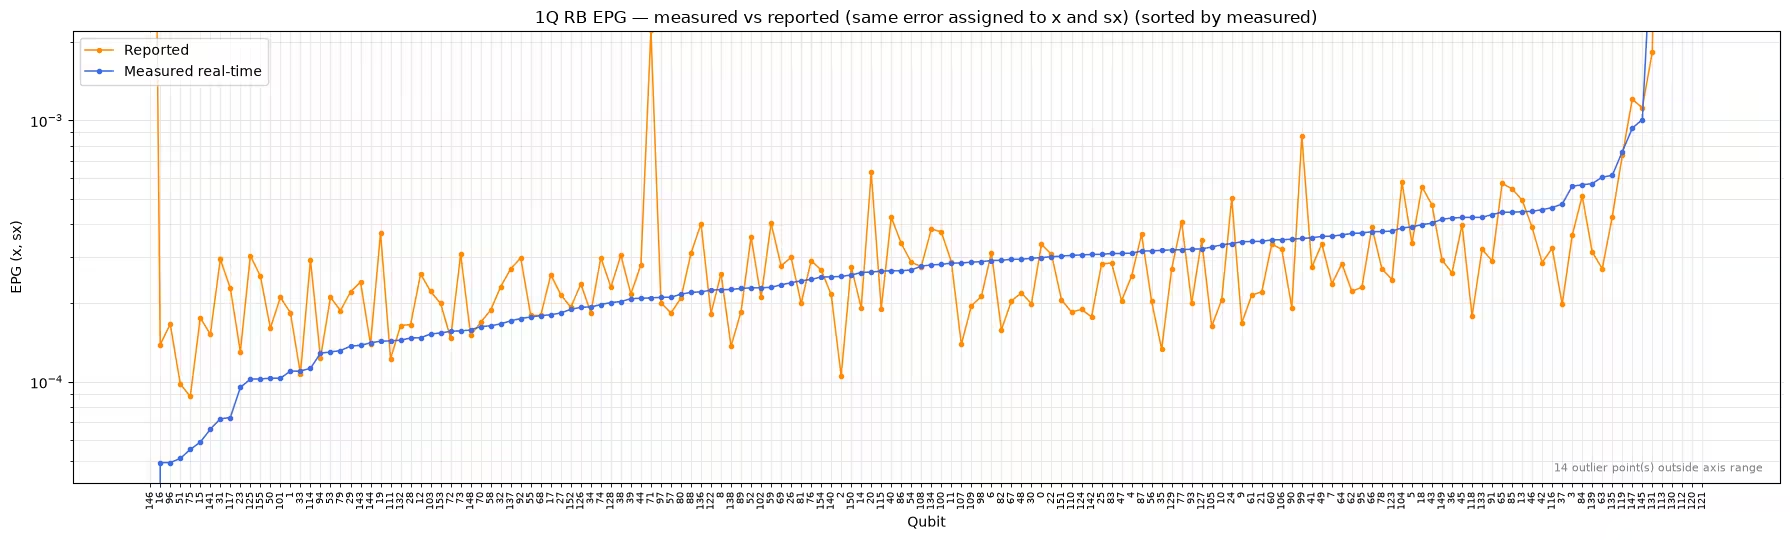
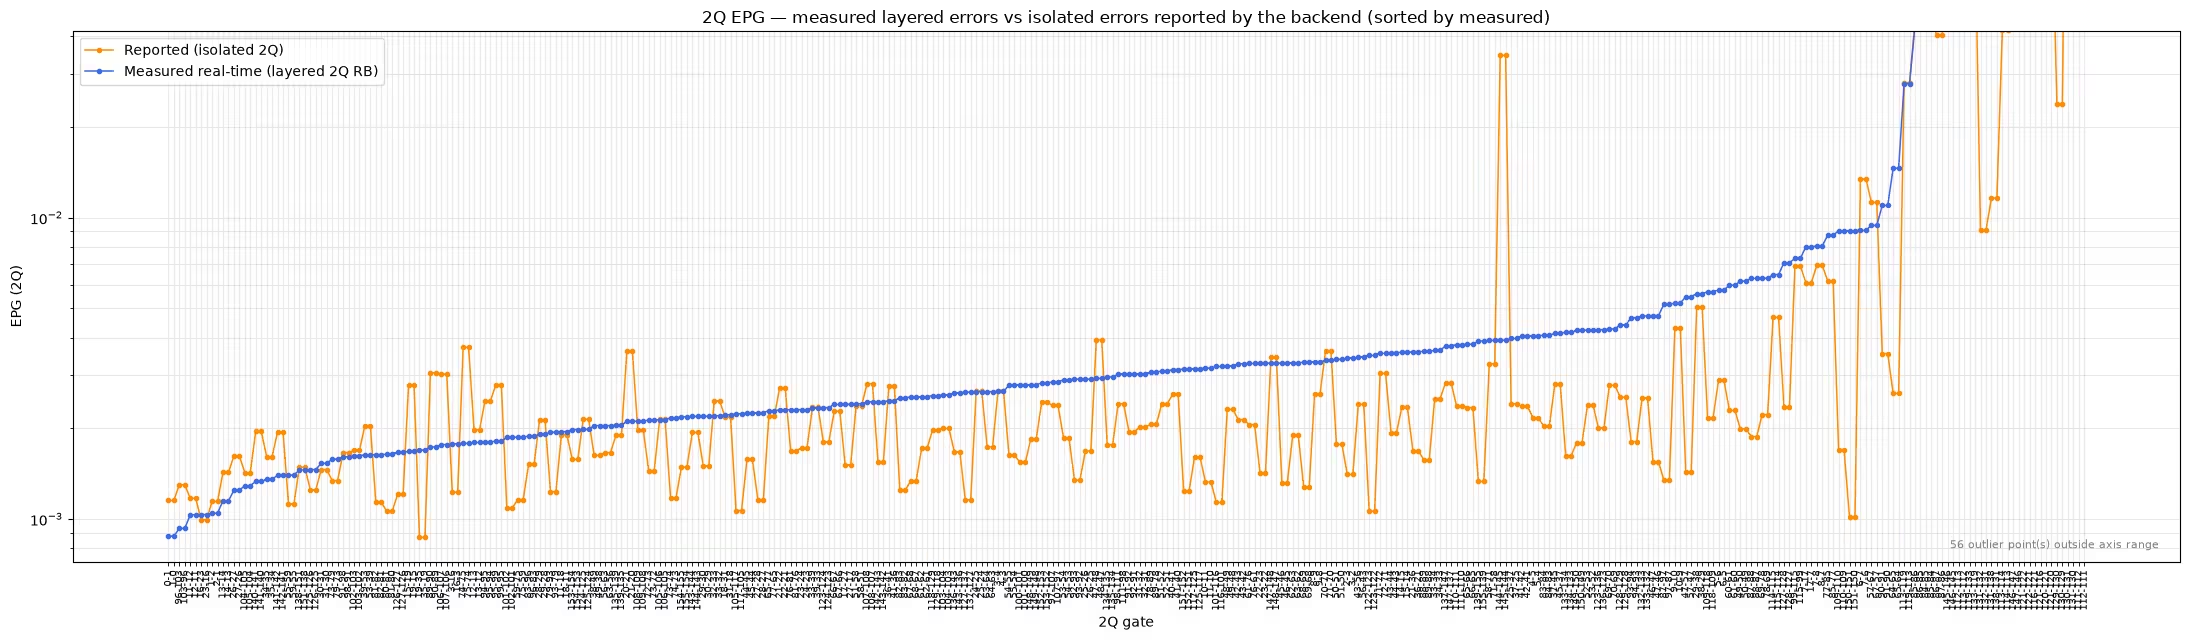
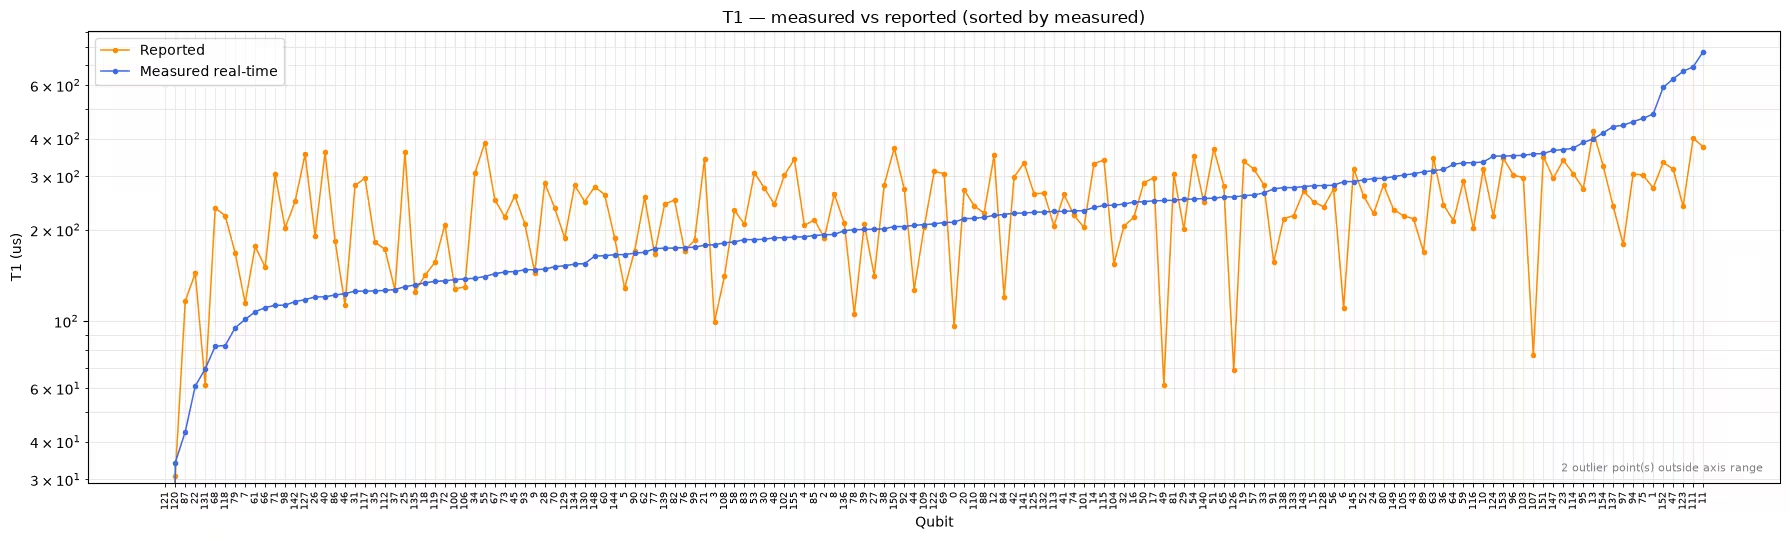
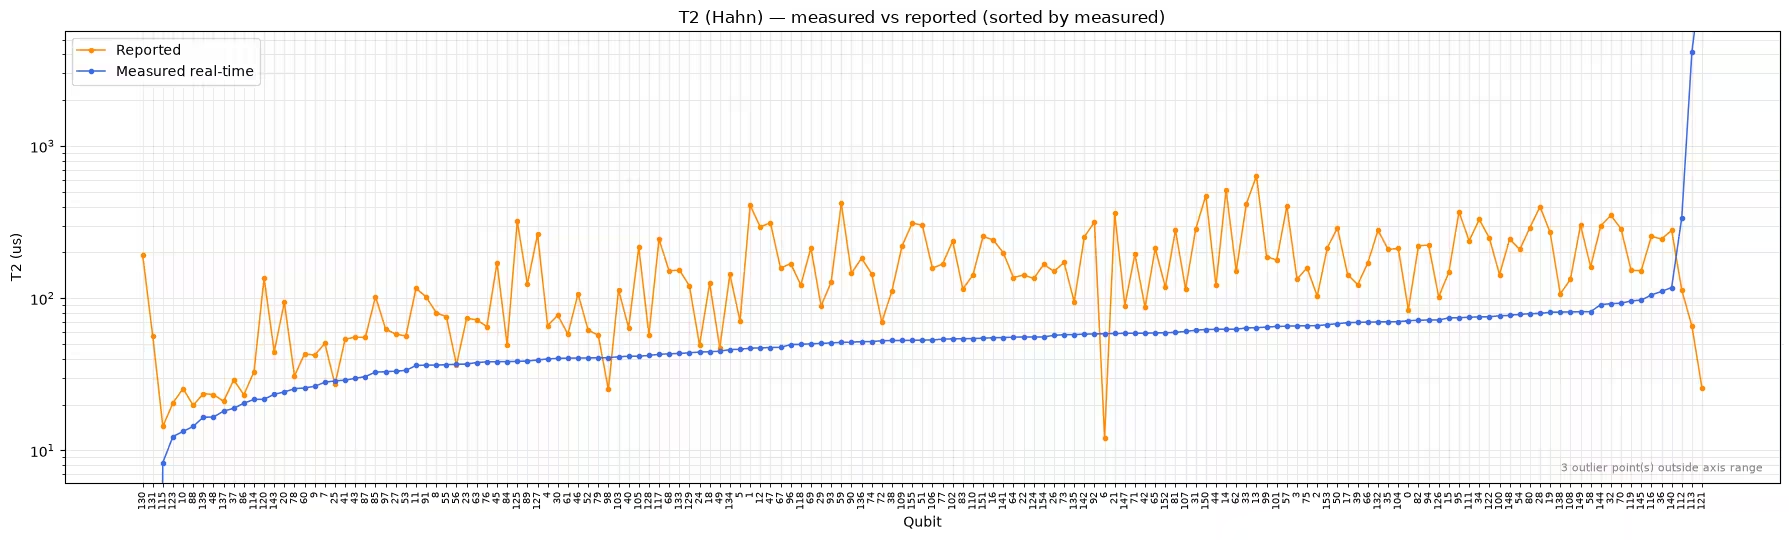
תרשימים אלה דורשים קריאה זהירה, מכיוון שלא כל פער בין שתי העקומות אומר שההתקן נדד:
-
שגיאות קריאה וקיוביט בודד: הערכים הנמדדים עוקבים אחר המדווחים ברוב הקיוביטים, בעוד שהערך המדווח עבור כמה קיוביטים רחוק מאוד מהעקומה הנמדדת. אי ההסכמות המקומיות האלה הן הנדידה שתהליך עבודה זה נועד לתפוס.
-
: שתי קבוצות הנתונים מתפזרות סביב זו את זו ללא הסטה שיטתית, מה שעקבי עם תנודתיות טבעית של לאורך זמן.
-
שגיאות שני קיוביטים: הערכים הנמדדים יושבים באופן שיטתי מעל המדווחים. זה צפוי מכיוון שהערכים המדווחים נמדדים על שערים מבודדים, בעוד שניסוי layer fidelity מריץ שערים רבים בו זמנית ולכן כולל crosstalk. המספרים בשכבות רלוונטיים יותר עבור מעגלים עמוקים, אבל הם לא ניתנים להשוואה ישירה עם נתוני הכיול המדווחים.
-
: הערכים הנמדדים יושבים משמעותית מתחת למדווחים ברוב הקיוביטים. שוב, מתודולוגיה משחקת תפקיד גדול, כפי שנבחן בסעיף הבא.
בדוק את תוצאות הניסוי הבודדות
אתה יכול גם לבדוק את התוצאות הגולמיות של ניסויי האפיון הבודדים דרך המאפיין experiment_data, שמחזיר את אובייקטי ה-ExperimentData הבסיסיים של Qiskit Experiments. לדוגמה, הדוגמה הבאה מציגה את עקומת הדעיכה הנמדדת של עבור קיוביט בודד, מה שמועיל לבדיקת איכות ההתאמה לפני שסומכים על המספר שהיא הפיקה.
t1_data = characterizer.experiment_data["t1"]

# Each qubit has its own fit figure
n_figs = len(t1_data.figure_names)
print(f"{n_figs} figures available, e.g. {t1_data.figure_names[0]}")

# Show the T1 decay curve of the first qubit
t1_data.figure(0)
156 figures available, e.g. T1_Q0_c78ef792.svg

מדוד T2 עם רצף ניתוק דינמי
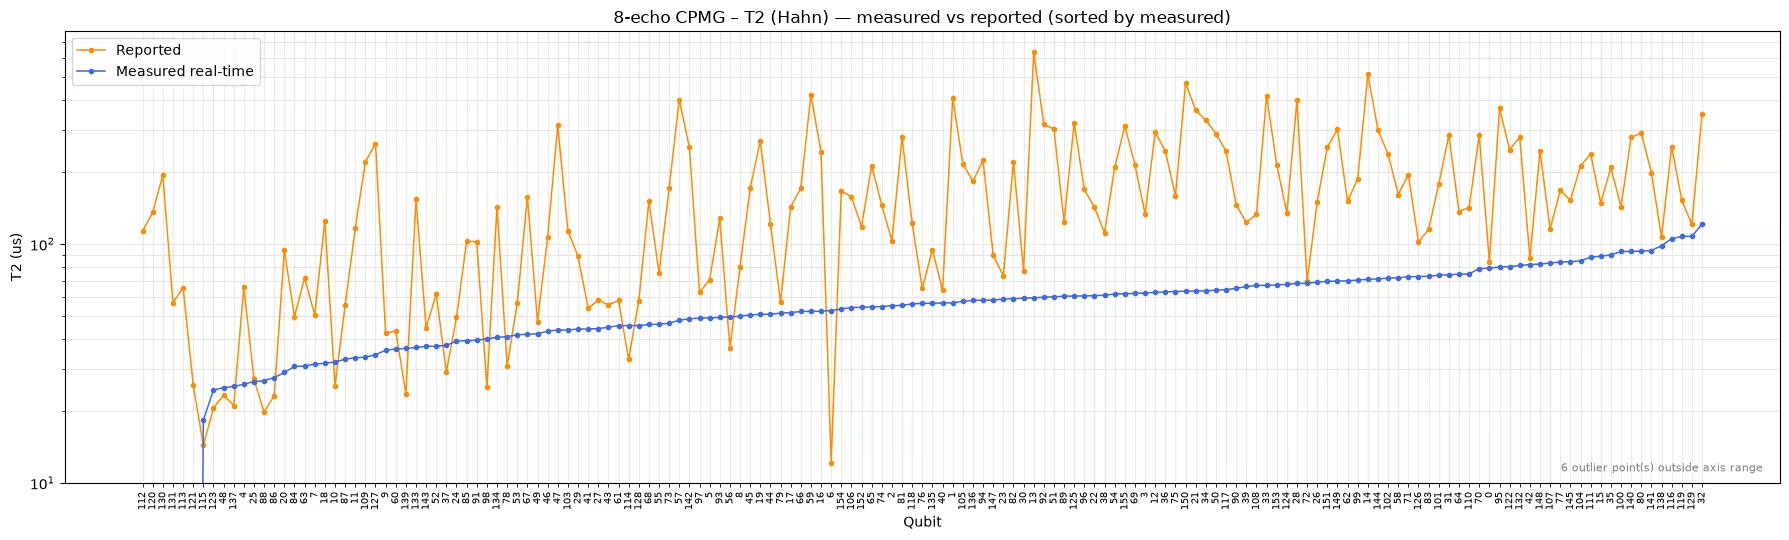
כברירת מחדל, ניסוי מפעיל הד Hahn יחיד ומודד את כל הקיוביטים במקביל, מה שכפי שהראה תרשים ההשוואה למעלה, יכול להניב ערכי נמוכים באופן ניכר ממה שה-Backend מדווח. השערה אחת היא מספר ההדים: ייתכן שהערכים המדווחים מכוילים עם ניתוק דינמי, שמדכא רעש בתדר נמוך. כדי לבחון זאת, הרץ אפיון של בלבד עם t2_num_echoes מוגדר לערך גדול יותר, מה שמפעיל רצף פולסי הד בסגנון CPMG. העיכובים מייצגים את זמן האבולוציה החופשית הכולל בשני המקרים, כך שערכי ה- המותאמים ניתנים להשוואה ישירה לתוצאות ההד היחיד.
# Run a T2-only characterization using a CPMG-style train of 8 echoes
characterizer_dd = BackendCharacterization(backend)
backend_updated_dd = characterizer_dd.run_and_update(
    experiments=["t2"], t2_num_echoes=8
)
Building T2 experiments
T2 (Hahn) experiment submitted: ['d9b96s6g26ic73dflcn0']
Updating T2
# Compare the multi-echo T2 against the backend-reported values
plot_characterization_comparison(
    old_props=backend.properties().to_dict(),
    new_props=backend_updated_dd.properties().to_dict(),
    plots=["t2"],
    title_prefix="8-echo CPMG",
)

# Compare medians across the reported values, the single-echo run,
# and the 8-echo run
reported_t2s = [
    prop["value"]
    for qubit in backend.properties().to_dict()["qubits"]
    for prop in qubit
    if prop["name"] == "T2"
]
t2_reported = np.median(reported_t2s)
t2_single = np.median(list(error_maps["t2_map"].values())) * 1e6
t2_dd = (
    np.median(list(characterizer_dd.analyze_results()["t2_map"].values()))
    * 1e6
)
print(
    f"Median T2 — reported: {t2_reported:.0f} us | "
    f"single echo: {t2_single:.0f} us | 8-echo CPMG: {t2_dd:.0f} us"
)
Median T2 — reported: 142 us | single echo: 53 us | 8-echo CPMG: 56 us
בהרצה זו, ההדים הנוספים בקושי שינו את התוצאה: החציון של 8 הדים (56 µs) קרוב לזה של הד יחיד (53 µs), ושניהם נותרים רחוקים מתחת לחציון המדווח (142 µs). מספר ההדים בלבד לא מסביר את הפער הזה; הבדלים מתודולוגיים אחרים מעורבים, כמו פרטי הליך הכיול, מדידת כל הקיוביטים במקביל ולא בבידוד, וכן הלאה.
הלקח המעשי הוא להתייחס בזהירות להשוואות (ושגיאת שכבות של שני קיוביטים) בין מתודולוגיות שונות. הערכים המרועננים הם תמונת מצב עצמית ועקבית שנלקחה בתנאים קרובים לעומס עבודה אמיתי, מה שהופך אותם למתאימים היטב להשוואת קיוביטים זה מול זה או למעקב אחר התקן לאורך זמן. פער יחסית לנתוני הכיול המדווחים, לעומת זאת, אינו בהכרח עדות לנדידה.
שלבים 1–4 בקריאה אחת מכווצת
לשימוש יומיומי לרוב אין צורך בתוצאות הביניים. השיטה run_and_update משרשרת את כל מה שעשית למעלה (בנייה, שליחה, התאמה ועדכון) לתוך קריאה בודדת שמחזירה את ה-Backend המרוענן. היא מקבלת את אותה רשימת experiments (ומעבירה הלאה אפשרויות כמו t2_num_echoes), ובאופן דומה יכולה להיות עטופה בהקשר של Batch או Session.
התא הבא לא מחזיר שליטה עד שכל ה-jobs והעיבוד שלאחר-ריצה הושלמו.
# Initialize a fresh characterizer
characterizer = BackendCharacterization(backend)

# Run all of the experiments and update the backend in a single call
backend_updated = characterizer.run_and_update(experiments=experiments)
Building readout experiments
Building 1Q RB experiments
Building 2Q RB experiments
Building T1 experiments
Building T2 experiments
Layered two-qubit RB submitted: ['d9b7oqnu62qs738otat0', 'd9b7p76g26ic73dfjolg', 'd9b7pnm6hjac73ffb57g', 'd9b7q4fu62qs738otce0']
Readout job submitted: d9b7q4mg26ic73dfjprg
T1 experiment submitted: ['d9b7q57u62qs738otcfg']
T2 (Hahn) experiment submitted: ['d9b7q5m6hjac73ffb5pg']
Single-qubit RB submitted: ['d9b7r4e6hjac73ffb71g', 'd9b7reu6hjac73ffb7d0']
Updating readout error
Updating single-qubit X error
Updating single-qubit SX error
Updating two-qubit error
Updating T1
Updating T2
אובייקט ה-backend_updated המרוענן מוכן כעת לשימוש בכל מקום שבו מאפייני Backend מוזנים לתהליך העבודה שלך. נסה תהליך זה יחד עם מדריך Real-time benchmarking for qubit selection כדי לבחור את הקיוביטים בעלי הביצועים הטובים ביותר בעת ביצוע Transpile ל-Circuit. מכיוון שההתקן ממשיך לנדוד, רענן את המאפיינים סמוך לזמן שבו אתה בפועל מריץ את עומס העבודה שלך.
השלבים הבאים
אם מצאת עבודה זו מעניינת, ייתכן שיעניין אותך החומר הבא:
- השתמש במאפיינים המרועננים כדי לבחור קיוביטים טובים יותר במדריך Real-time benchmarking for qubit selection
- למד כיצד נתוני הכיול המדווחים חשופים במדריך מידע QPU
- חקור את ניסויי האפיון הבודדים בתיעוד Qiskit Experiments
- עיין בבנצ'מרקים נוספים ברמת ההתקן במאגר Qiskit Device Benchmarking