זיהוי שגיאות בעלות עומס נמוך עם קודי מרחב-זמן
הערכת שימוש: 4 דקות במעבד Heron (ibm_kingston או שווה ערך) (הערה: זוהי הערכה בלבד. זמן הריצה בפועל עשוי להשתנות.)
תוצרי למידה
-
כיצד בדיקות Pauli במרחב-זמן מזהות שגיאות לוגיות במעגלי קליפורד, וכיצד בחירה מוקדמת על סמך התסמונות שלהן מגבירה את הנאמנות של התפלגות שנדגמה.
-
כיצד להשתמש בחבילת
qiskit-pauliceכדי למצוא ולהוסיף בדיקות יעילות מבחינת חומרה באופן אוטומטי באמצעותget_check_qubits,NoiseModel, ו-add_pauli_checks. -
כיצד להעריך את הנאמנות של מצב מייצב על ידי דגימת המייצבים שלו ובחירה מוקדמת על סמך תסמונות הבדיקה.
-
כיצד להריץ את תהליך העבודה המלא של זיהוי שגיאות על חומרת IBM Quantum® ולהשוות בין נאמנות רועשת לנאמנות לאחר בחירה מוקדמת.
דרישות מוקדמות
-
יסודות חומרה עבור מחשוב קוונטי בקנה מידה שימושי.
-
פורמליזם קליפורד ומייצבים, כולל האופן שבו קבוצת מייצבים מתארת מצב מייצב טהור.
רקע
זיהוי שגיאות בעלות עומס נמוך עם קודי מרחב-זמן [1] מאת Simon Martiel ו-Ali Javadi-Abhari מציג שיטה לזיהוי שגיאות לוגיות במעגלים שבשליטת קליפורד, שנמצאת בין תיקון שגיאות מלא לבין הפחתת שגיאות קלה יותר. הרעיון נבנה על בסיס בדיקות Pauli קוהרנטיות (CPC) מתוך Single-shot error mitigation by coherent Pauli checks [2] מאת van den Berg ואחרים. בשתי הגישות, מעגל "מטען" קליפורד משתלב (entangled) עם קיוביטים עזר (ancilla) כדי לבדוק אינווריאנטים מסוימים. מדידת קיוביטי העזר מפיקה תסמונת המדווחת האם זוהתה שגיאה במהלך הביצוע. שמירה רק על הדגימות שבהן לא זוהתה שגיאה משפרת את הנאמנות של ההתפלגות הנדגמת, במחיר של שיעור בחירה מוקדמת נמוך יותר.
ההבדל המרכזי בין בדיקות Pauli קוהרנטיות לבדיקות מרחב-זמן הוא האופרטורים שהן מודדות. בדיקות Pauli קוהרנטיות מודדות אופרטורים מקומיים בזמן ובעלי משקל גבוה. בטופולוגיות קיוביטים עם קישוריות מוגבלת, כגון heavy hex, בדיקות אלו דורשות שערי SWAP רבים ולעיתים קרובות הופכות את המעגל לעמוק מדי להרצה בפועל. יישום הבדיקות כקודי מרחב-זמן במקום זאת מפזר כל בדיקה על פני מעגל המטען במרחב ובזמן. כך מתקבל קידוד יעיל מבחינת חומרה, שנשאר יעיל בזיהוי שגיאות לוגיות תוך שמירה על עומס נמוך של קיוביטים ועומק.
מה עושה חבילת qiskit-paulice
חבילת qiskit-paulice מייתרת את הבנייה הידנית של הבדיקות הללו. תפקידה העיקרי הוא למצוא ולהוסיף בדיקות Pauli תקפות במרחב-זמן במיקומים במעגל שממקסמים את זיהוי השגיאות תוך מזעור עומס הקיוביטים. בדיקה היא תקפה כאשר האופרטורים שלה משאירים את הפעולה הלוגית של מעגל המטען ללא שינוי, במשקל נמוך כאשר היא משתמשת במעט שערי שזירה, ויעילה כאשר היא מזהה חלק גדול מהשגיאות, ביחס לרעש שהבדיקה עצמה מכניסה. החבילה מדרגת בדיקות מועמדות מול מודל רעש ומטמיעה במעגל את הטובות ביותר. מדריך זה משתמש בשלוש שיטות API:
-
get_check_qubitsבודקת מפת קישוריות של Backend ומחזירה זוגות של קיוביטי יעד וקיוביטי עזר. בדיקה עלtarget_qubits[i]משתמשת ב-ancilla_qubits[i]. -
NoiseModel.from_backendבונה מודל רעש גס מנתוני בנצ'מרק של ה-Backend. המודל מדרג בדיקות מועמדות, כך שאין צורך במודל רעש נלמד ומדויק. עבור מודל Pauli-Lindblad נלמד, ראוNoiseModel.from_pauli_lindblad_maps. -
add_pauli_checksמוצאת ומכניסה בדיקות למעגל. היא מחזירה רצף של אובייקטיCheckedCircuitעם מספר גדל והולך של בדיקות, וכל אובייקט מספקget_postselection_methodהממפה מחרוזת ביטים שנמדדה לוקטור תסמונת. הארגומנטcostבוחר את הפונקציה שמדרגת בדיקה (gamma, עומס הדגימה של ערוץ הרעש ההפוך לאחר בחירה מוקדמת, אוLER, קצב השגיאה הלוגית). הארגומנטmethodבוחר את אסטרטגיית החיפוש (windowed,genetic, אוwindowed_genetic). מדריך זה משתמש ב-cost="gamma"וב-method="windowed", שיחד נותנים בחירת בדיקות דטרמיניסטית וניתנת לשחזור.
הערכת נאמנות מדגימת מייצבים
כדי למדוד עד כמה טוב זיהוי השגיאות פועל, ניתן להעריך את הנאמנות של מצב המייצב שהמעגל אמור להכין באופן אידיאלי, כנגד המצב הרועש שהחומרה מפיקה בפועל. המקרן על מצב מייצב טהור שווה לממוצע האחיד על פני האיברים של קבוצת המייצבים שלו :
הצבת זה בביטוי הנאמנות נותנת את הנאמנות של כערך התוחלת הממוצע של כל מייצב ביחס ל-:
עבור בעיות גדולות יותר, מנייה של כל המייצבים אינה ישימה, ולכן ניתן להעריך את הנאמנות מדגימה אקראית. הגרלה של מייצבים באופן אחיד ואקראי מתוך נותנת הערכה חסרת הטיה:
מכיוון שמעגל קליפורד מכין מצב מייצב, ניתן להעריך את נאמנותו ישירות מערכי תוחלת שנדגמו של המייצבים שלו. מדריך זה סוקר תחילה את תהליך העבודה על סימולטור עם מעגל קטן, ולאחר מכן מריץ את אותו תהליך עבודה על חומרה עם מעגל גדול ועמוק יותר. ככל שמעגלים כוללים יותר פעולות שאינן קליפורד, מספר הבדיקות התקפות מצטמצם במהירות, כך שהשיטה עובדת בצורה הטובה ביותר עבור מעגלים בשליטת קליפורד.
דרישות
לפני שתתחילו במדריך זה, ודאו שהתקנתם את הדברים הבאים:
-
Qiskit SDK גרסה 2.0 ומעלה, עם תמיכת ויזואליזציה
-
Qiskit Runtime גרסה 0.40 ומעלה (
pip install qiskit-ibm-runtime) -
Qiskit Aer גרסה 0.17 ומעלה (
pip install qiskit-aer) -
Qiskit Paulice (
pip install qiskit-paulice) -
tqdm (
pip install tqdm)
הגדרה
ייבאו את הספריות הדרושות והגדירו את פונקציות העזר שאינן זמינות כייבוא. הפונקציה random_clifford_circuit בונה מטען קליפורד אקראי בסגנון brickwork, find_check_layout מחפשת במפת הקישוריות של ה-Backend נתיב קיוביטים בעל שגיאה נמוכה עם קיוביטי עזר זמינים רבים, learned_noise_model הופכת פלט של NoiseLearner למודל רעש של qiskit-paulice, append_basis_rotation מסובבת מעגל כך שמייצב יימדד בבסיס החישובי, expectation מחשבת ערך תוחלת של מייצב מספירות שנדגמו, ו-cum_mean_sem עוקבת אחר הערכת הנאמנות המתמשכת.
# Added by doQumentation — required packages for this notebook
!pip install -q matplotlib numpy qiskit qiskit-aer qiskit-ibm-runtime qiskit-paulice tqdm
# Standard library imports
import random
import time

# External libraries
import matplotlib.pyplot as plt
import numpy as np
from tqdm import tqdm

# Qiskit
from qiskit import QuantumCircuit
from qiskit.quantum_info import Clifford, Pauli, PauliLindbladMap, PauliList
from qiskit.result import sampled_expectation_value
from qiskit.transpiler import generate_preset_pass_manager
from qiskit.visualization import plot_coupling_map

# Qiskit Aer
from qiskit_aer import AerSimulator
from qiskit_aer.noise import NoiseModel as AerNoiseModel
from qiskit_aer.noise import ReadoutError, depolarizing_error

# Qiskit IBM Runtime
from qiskit_ibm_runtime import NoiseLearner, QiskitRuntimeService
from qiskit_ibm_runtime import SamplerV2 as Sampler

# Qiskit Paulice
from qiskit_paulice import add_pauli_checks
from qiskit_paulice.layout import get_check_qubits
from qiskit_paulice.noise_models import NoiseModel
def random_clifford_circuit(
    num_qubits: int, depth: int, rng: np.random.Generator
) -> QuantumCircuit:
    """Brickwork random Clifford on `num_qubits`, with `depth` CZ layers."""
    qc = QuantumCircuit(num_qubits)
    qc.h(range(num_qubits))
    for d in range(depth):
        for i in range(d % 2, num_qubits - 1, 2):
            qc.cz(i, i + 1)
        for q in range(num_qubits):
            if rng.integers(0, 2):
                qc.sx(q)
            if rng.integers(0, 2):
                qc.s(q)
            if rng.integers(0, 2):
                qc.sx(q)
    return qc

def find_check_layout(
    backend,
    num_qubits: int,
    rng: np.random.Generator,
    num_trials: int = 200,
    max_gate_error: float = 0.03,
    max_readout_error: float = 0.2,
) -> list[int]:
    """Find a low-error path of `num_qubits` qubits with many available ancillas.

    Builds random self-avoiding walks on the coupling map, excluding the qubits
    and two-qubit gates whose reported errors exceed the thresholds, and keeps
    the path that offers the most target and ancilla pairs. Ties are broken by
    the lower average two-qubit gate error along the path.
    """
    target = backend.target
    gate_2q = next(
        name for name in ("cz", "ecr", "cx") if name in target.operation_names
    )

    # Collect per-edge gate errors and per-qubit readout errors
    edge_error = {}
    for qubits, props in target[gate_2q].items():
        edge = tuple(sorted(qubits))
        if props is not None and props.error is not None:
            edge_error[edge] = min(edge_error.get(edge, 1.0), props.error)
    readout_error = {
        qubit: target["measure"][(qubit,)].error
        for (qubit,) in target["measure"]
    }

    # Keep only the edges whose gate and readout errors are acceptable
    adjacency = {}
    for (q1, q2), error in edge_error.items():
        if (
            error <= max_gate_error
            and readout_error.get(q1, 1.0) <= max_readout_error
            and readout_error.get(q2, 1.0) <= max_readout_error
        ):
            adjacency.setdefault(q1, set()).add(q2)
            adjacency.setdefault(q2, set()).add(q1)

    # Random self-avoiding walks; keep the path with the most check pairs
    starts = sorted(adjacency)
    best_path = None
    best_score = (-1, float("inf"))
    for _ in range(num_trials):
        path = [starts[rng.integers(len(starts))]]
        while len(path) < num_qubits:
            options = sorted(adjacency[path[-1]] - set(path))
            if not options:
                break
            path.append(options[rng.integers(len(options))])
        if len(path) < num_qubits:
            continue
        num_pairs = len(get_check_qubits(backend.coupling_map, path)[0])
        mean_error = float(
            np.mean(
                [edge_error[tuple(sorted(e))] for e in zip(path, path[1:])]
            )
        )
        if num_pairs > best_score[0] or (
            num_pairs == best_score[0] and mean_error < best_score[1]
        ):
            best_path, best_score = path, (num_pairs, mean_error)

    if best_path is None:
        raise RuntimeError(
            "No connected low-error path found. Relax the error thresholds."
        )
    return best_path

def learned_noise_model(layer_errors, layout: list[int]) -> NoiseModel:
    """Build a `NoiseModel` from `NoiseLearner` results.

    `NoiseLearner` reports one `PauliLindbladError` per entangling layer, whose
    generators are indexed against that layer's own physical qubits, while
    `NoiseModel.from_pauli_lindblad_maps` expects `PauliLindbladMap`s indexed the
    way `NoiseModel.from_backend` indexes them: by position in `layout`. This
    translates between the two and drops generators that fall outside `layout`.
    """
    phys_to_virt = {phys: virt for virt, phys in enumerate(layout)}
    maps = []
    for layer in layer_errors:
        if layer.error is None:
            continue
        terms = []
        for pauli, rate in zip(
            layer.error.generators, layer.error.rates, strict=True
        ):
            label, indices = [], []
            for local, phys in enumerate(layer.qubits):
                x, z = bool(pauli.x[local]), bool(pauli.z[local])
                if not (x or z):
                    continue
                if phys not in phys_to_virt:
                    break  # generator reaches outside the layout, so skip it
                label.append("Y" if x and z else "X" if x else "Z")
                indices.append(phys_to_virt[phys])
            else:
                if label:
                    terms.append(
                        ("".join(label), tuple(indices), float(rate))
                    )
        # Each map needs a 2-qubit generator to define an entangling layer
        if any(len(t[1]) == 2 for t in terms):
            maps.append(
                PauliLindbladMap.from_sparse_list(
                    terms, num_qubits=len(layout)
                )
            )
    if not maps:
        raise RuntimeError(
            "No usable layer errors. Check that the learner ran on this layout."
        )
    return NoiseModel.from_pauli_lindblad_maps(maps)

def append_basis_rotation(
    circuit: QuantumCircuit, pauli: Pauli
) -> QuantumCircuit:
    """Strip measurements, append basis rotations for `pauli`, and re-measure."""
    out = circuit.remove_final_measurements(inplace=False)
    for q in range(pauli.num_qubits):
        if pauli.x[q]:
            if pauli.z[q]:
                out.sdg(q)
            out.h(q)
    out.measure_all()
    return out

def expectation(counts: dict, pauli: Pauli) -> float:
    """Expectation value of `pauli` from counts measured in the Z basis.

    Pads with identity on any qubits beyond the support of `pauli`, such as the
    check ancillas that appear in the postselected counts.
    """
    if not counts:
        return float("nan")
    n = pauli.num_qubits
    sign = -1 if int(pauli.phase) % 4 == 2 else 1
    total = len(next(iter(counts)))
    label = "".join(
        "Z" if q < n and (pauli.x[q] or pauli.z[q]) else "I"
        for q in range(total - 1, -1, -1)
    )
    return sign * sampled_expectation_value(counts, label)

def cum_mean_sem(values: np.ndarray):
    """Cumulative mean and standard error of the mean, ignoring NaNs."""
    valid = ~np.isnan(values)
    total = np.cumsum(np.where(valid, values, 0.0))
    total_sq = np.cumsum(np.where(valid, values**2, 0.0))
    count = np.maximum(np.cumsum(valid).astype(float), 1)
    mean = total / count
    sem = np.sqrt(np.maximum(total_sq / count - mean**2, 0) / count)
    return np.where(np.cumsum(valid) > 0, mean, np.nan), sem
דוגמת סימולטור בקנה מידה קטן
סעיף זה סוקר את תהליך העבודה המלא על סימולטור רועש. הוא משתמש בנתוני בנצ'מרק של Backend לבחירת פריסת קיוביטים ומודל רעש, מוצא בדיקות אוטומטית, ומשתמש בבחירה מוקדמת על ההתפלגות הנדגמת כדי להראות את שיפור הנאמנות.
שלב 1: מיפוי קלטים קלאסיים לבעיה קוונטית
מעגל המטען הוא מעגל קליפורד אקראי רדוד, חד-ממדי, בסגנון brickwork. מכיוון שהמעגל הוא קליפורד, הוא מכין מצב מייצב שאת נאמנותו ניתן להעריך ישירות מערכי תוחלת שנדגמו של המייצבים. התחילו עם מעגל רדוד כדי שהבדיקות יהיו קלות להצגה בשלב הבא.
num_qubits = 12
depth = 4
seed = 1764
rng = np.random.default_rng(seed)
np.random.seed(seed)

circuit = random_clifford_circuit(num_qubits, depth, rng)
circuit.measure_all()
circuit.draw("mpl", fold=-1, scale=0.6)

שלב 2: אופטימיזציה להרצה על חומרה קוונטית
מיפוי המעגל לחומרה קובע את פריסת הקיוביטים הפיזית, את מודל הרעש שמדרג בדיקות מועמדות, ואת הבדיקות עצמן.
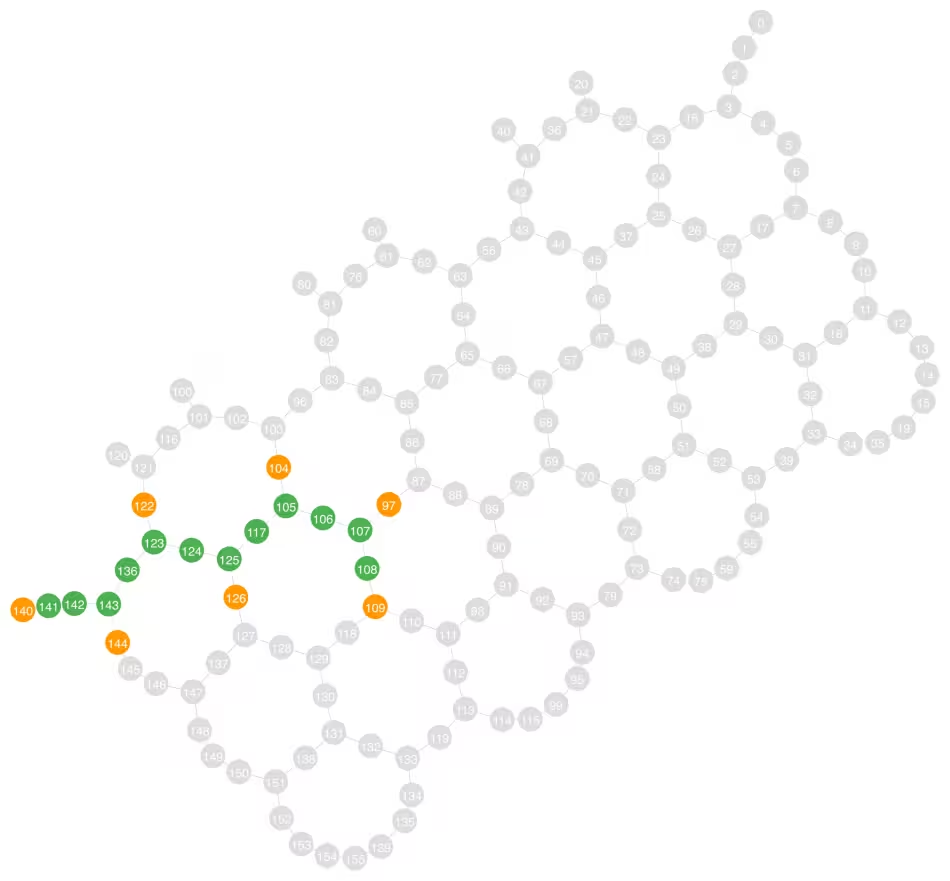
תחילה, בחרו Backend וחפשו במפת הקישוריות שלו פריסת קיוביטים חד-ממדית באמצעות פונקציית העזר find_check_layout שהוגדרה בסעיף ההגדרה. פונקציית העזר בונה הליכות אקראיות נמנעות-מעצמן שמתחמקות משערים וקריאות בעלי השגיאה הגבוהה ביותר, ושומרת את הנתיב המציע את מספר הזוגות הרב ביותר של יעד ועזר. מכיוון שהחיפוש קורא את נתוני הקישוריות והשגיאה מה-Backend עצמו, אותו קוד רץ על כל QPU של IBM Quantum. הפונקציה get_check_qubits מחזירה לאחר מכן את זוגות היעד והעזר, כאשר בדיקה על target_qubits[i] משתמשת ב-ancilla_qubits[i].
בגרף הקישוריות שלהלן, הקיוביטים הירוקים הם קיוביטי מטען והקיוביטים הכתומים הם קיוביטי העזר המיישמים את הבדיקות. קיוביטים בעלי קיוביט עזר סמוך משמשים כקיוביטי יעד לבדיקות.
service = QiskitRuntimeService()
backend = service.least_busy(operational=True, simulator=False)

print(f"Backend: {backend.name}")

# Search for a low-error path, then pair each target qubit with a neighboring ancilla
layout = find_check_layout(backend, num_qubits, rng)
target_qubits, ancilla_qubits = get_check_qubits(backend, layout)
num_checks = len(target_qubits)

print(f"Target qubits:  {target_qubits}")
print(f"Ancilla qubits: {ancilla_qubits}")
plot_coupling_map(
    num_qubits=backend.num_qubits,
    qubit_coordinates=getattr(
        backend.configuration(), "qubit_coordinates", None
    ),
    coupling_map=backend.configuration().coupling_map,
    figsize=(12, 12),
    qubit_color=[
        "#4CAF50"
        if i in set(layout)
        else "#FF9800"
        if i in set(ancilla_qubits)
        else "#DDDDDD"
        for i in backend.coupling_map.graph.node_indices()
    ],
    qubit_size=220,
    line_width=2,
    font_size=90,
)
Backend: ibm_boston
Target qubits:  [105, 107, 108, 123, 125, 141, 143]
Ancilla qubits: [104, 97, 109, 122, 126, 140, 144]
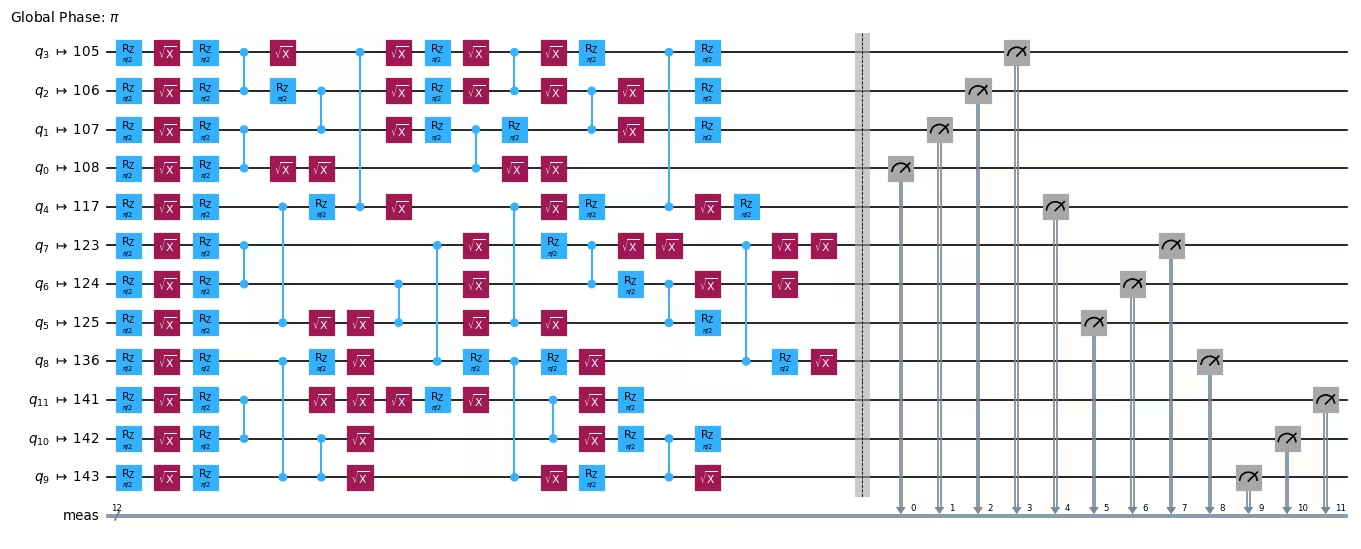
לאחר בחירת ה-Backend והפריסה, בצעו טרנספיילינג למטען למעגל בארכיטקטורת סט הוראות (ISA). יש צורך רק בקביעת הפריסה ובתרגום השערים לסט השערים הילידי של ה-Backend.
pm = generate_preset_pass_manager(
    optimization_level=0, backend=backend, initial_layout=layout
)
circuit_isa = pm.run(circuit)
circuit_isa.draw("mpl", fold=-1, scale=0.6)
בהמשך, מדגמנים כיצד רעש השערים והקריאה על ה-Backend משפיע על הביצוע. מודל הרעש קובע היכן במעגל בדיקה תופסת את מרב השגיאה. מודל מדויק יותר משפר את הזיהוי, אך בדרך כלל אין צורך ללמוד אותו על ידי דגימת ה-QPU. המודל שלהלן מסיק ערוץ דה-פולריזציה אחיד עבור רעש שערים וקריאה מנתוני בנצ'מרק של qiskit-ibm-runtime.
noise_model = NoiseModel.from_backend(
    backend, layout, uniform_gate_noise=True
)
print(noise_model)
NoiseModel(gate_noise=0.001079865281450939, readout_noise=0.006001790364583333, idling_noise=None)
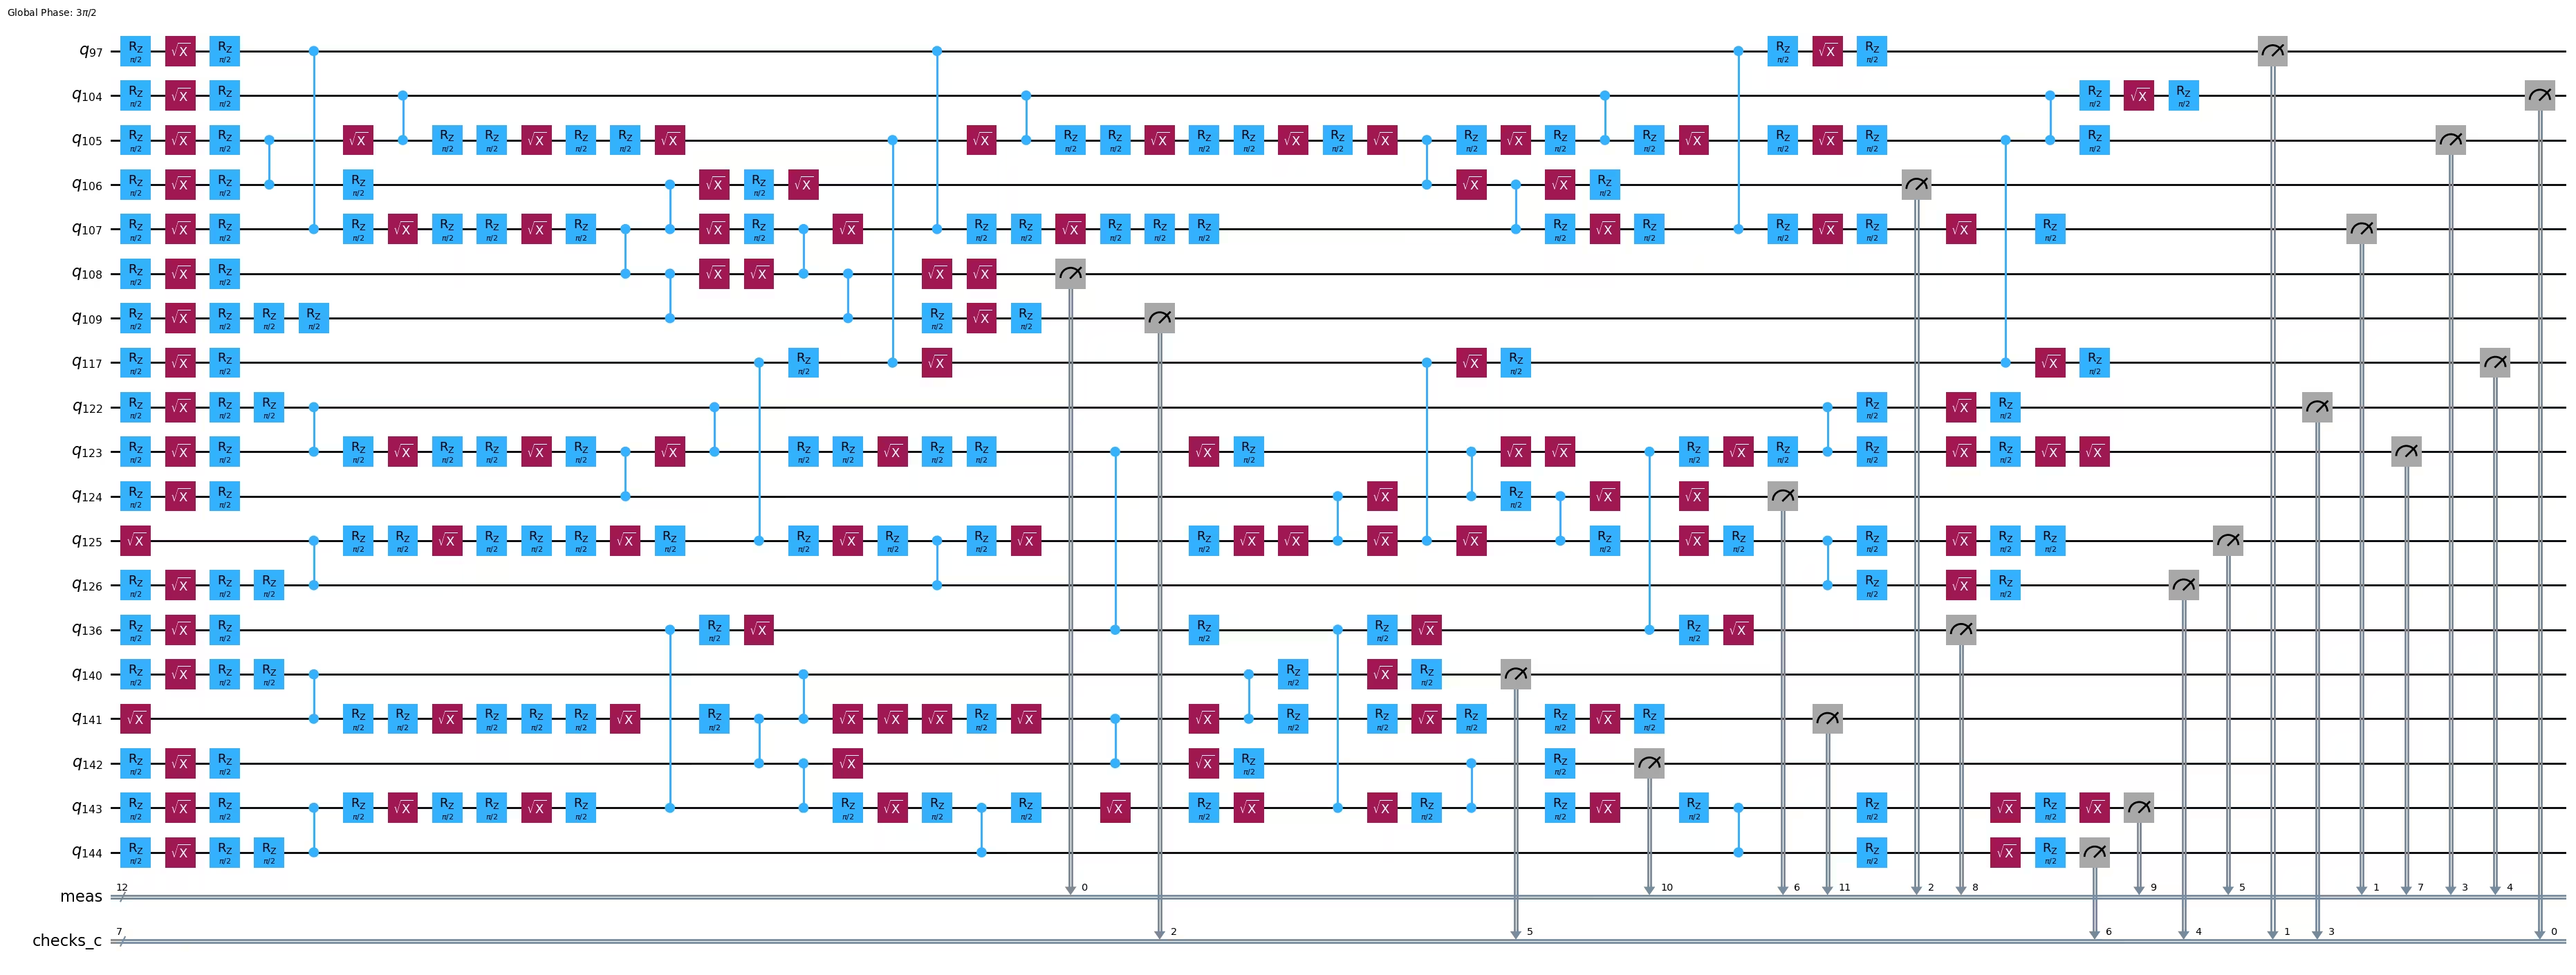
כעת הוסיפו בדיקות למעגל. הפונקציה add_pauli_checks מקבלת את מטען הקליפורד, רשימת קיוביטי היעד, ומודל הרעש. הארגומנט ancilla_qubits מודיע לפונקציה איזה קיוביט עזר פיזי לשייך לכל יעד. בדיקות מתווספות לפי הסדר שבו מופיעים קיוביטי היעד, כך שהפריסה הסופית של המעגל הבדוק היא layout + ancilla_qubits. כדי להריץ מעגל פלט עם פחות (i) בדיקות, הפריסה הסופית היא layout + ancilla_qubits[:i].
פלט add_pauli_checks הוא רצף של מעגלים עם מספר גדל והולך של בדיקות, החל מאפס בדיקות ועד בדיקה אחת על כל קיוביט יעד. הוויזואליזציה מאשרת שהבדיקות משתמשות בזוגות היעד והעזר שצוינו. לפרטים על מציאת בדיקות טובות, ראו סעיפים II עד IV במידע המשלים במקור [1].
checked = add_pauli_checks(
    circuit_isa,
    target_qubits,
    noise_model,
    ancilla_qubits=ancilla_qubits,
    cost="gamma",
    method="windowed",
    seed=seed,
)

print(f"Physical layout of payload and ancillas: {layout + ancilla_qubits}")
print("Checked circuit:")
checked[-1].circuit.draw("mpl", fold=-1, idle_wires=False)
Physical layout of payload and ancillas: [108, 107, 106, 105, 117, 125, 124, 123, 136, 143, 142, 141, 104, 97, 109, 122, 126, 140, 144]
Checked circuit:
שלב 3: הרצה באמצעות פרימיטיבים של Qiskit
כדי להפוך את השפעת רעש השערים לגלויה, הגדילו את עומק המטען ודגמו תת-קבוצה של המייצבים שלו. כל מייצב בדרך כלל אינו מתחלף עם האחרים ברמת הקיוביט, כך שסט בדיקות יחיד אינו תקף עבור שני מייצבים שונים. במקום לקבץ מייצבים לקבוצות מתחלפות, מוצאים סט בדיקות טוב עבור כל מייצב בנפרד. דגימת מייצבים באופן אחיד ואקראי נותנת הערכת נאמנות חסרת הטיה.
בנו את המעגל העמוק יותר והגרילו דגימה אקראית של המייצבים שלו.
depth = 24
num_stabilizers = 20
num_shots = 1_000

circuit = random_clifford_circuit(num_qubits, depth, rng)

# Build the full stabilizer group, then sample from it uniformly at random
circ_no_meas = circuit.remove_final_measurements(inplace=False)
stabilizer_group = PauliList([Pauli("I" * num_qubits)])
for generator in (
    Pauli(label) for label in Clifford(circ_no_meas).to_labels(mode="S")
):
    stabilizer_group = stabilizer_group + stabilizer_group.compose(generator)

keep = np.where(
    stabilizer_group.x.any(axis=1) | stabilizer_group.z.any(axis=1)
)[0]
chosen = np.random.default_rng(seed).choice(
    keep, size=min(num_stabilizers, len(keep)), replace=False
)
stabilizers = [stabilizer_group[int(i)] for i in chosen]

two_qubit_depth = circuit.depth(lambda x: x.operation.num_qubits == 2)
print(
    f"Sampled {len(stabilizers)} stabilizers of a {circuit.num_qubits}-qubit "
    f"circuit with two-qubit depth {two_qubit_depth}: "
    f"{{{stabilizers[0]}, {stabilizers[1]}, ...}}"
)
Sampled 20 stabilizers of a 12-qubit circuit with two-qubit depth 24: {ZXIIXZYYXIZZ, XXXYIIZYXIII, ...}
עבור כל מייצב שנדגם, סובבו את המעגל כך שהמייצב יימדד בבסיס החישובי, בצעו לו טרנספיילינג ל-Backend, ומצאו סט בדיקות טוב. זוגות היעד והעזר מעורבבים יחד עבור כל מייצב כך שכל יעד שומר על קיוביט העזר שלו. זכרו שבדיקות מוטמעות ברצף לפי הסדר שבו ניתנים קיוביטי היעד, ובדיקה שהוטמעה אינה משתנה ככל שמוסיפים בדיקות נוספות.
noisy_circuits = []
checked_circuits = []
depths_2q = []
t0 = time.time()
for i, pauli in enumerate(tqdm(stabilizers)):
    noisy_circuits.append(pm.run(append_basis_rotation(circuit, pauli)))
    # Shuffle target and ancilla pairs together so each target keeps its ancilla
    targets, ancillas = zip(
        *random.sample(
            list(zip(target_qubits, ancilla_qubits, strict=True)),
            k=len(target_qubits),
        ),
        strict=True,
    )
    checked_circuits.append(
        add_pauli_checks(
            noisy_circuits[-1],
            list(targets),
            noise_model,
            ancilla_qubits=list(ancillas),
            cost="gamma",
            method="windowed",
            seed=seed + 1 + i,
        )
    )
    depths_2q.append(
        checked_circuits[-1][-1].circuit.depth(lambda x: len(x.qubits) == 2)
    )

print(
    f"Added {num_checks} checks to {len(stabilizers)} circuits "
    f"in {(time.time() - t0):.0f}s."
)
print(
    f"On average, two-qubit depth increased from "
    f"{circuit.depth(lambda x: len(x.qubits) == 2)} to {int(np.mean(depths_2q))} "
    f"when adding {num_checks} checks."
)
100%|██████████| 20/20 [00:15<00:00, 1.29it/s]
Added 7 checks to 20 circuits in 15s.
On average, two-qubit depth increased from 24 to 33 when adding 7 checks.
דגמו את המטען החשוף ואת המעגלים הבדוקים באמצעות Qiskit Aer. הסימולטור משתמש באותו מודל דה-פולריזציה שדירג את הבדיקות, כך שהרעש שאליו הבדיקות מכוונות הוא הרעש שהסימולטור מחיל.
aer_nm = AerNoiseModel()
aer_nm.add_all_qubit_quantum_error(
    depolarizing_error(noise_model.gate_noise, 2), ["cz"]
)
p = noise_model.readout_noise
aer_nm.add_all_qubit_readout_error(ReadoutError([[1 - p, p], [p, 1 - p]]))
noisy_sim = AerSimulator(method="stabilizer", noise_model=aer_nm)

counts = []
for i, checked_circ_result in enumerate(tqdm(checked_circuits)):
    noisy_counts = (
        noisy_sim.run(
            noisy_circuits[i], shots=num_shots, seed_simulator=seed * i + 1
        )
        .result()
        .get_counts()
    )
    checked_counts_per_variant = []
    for k, ck in enumerate(checked_circ_result):
        variant_counts = (
            noisy_sim.run(
                ck.circuit, shots=num_shots, seed_simulator=seed * i + 2 + k
            )
            .result()
            .get_counts()
        )
        checked_counts_per_variant.append(variant_counts)
    counts.append((noisy_counts, checked_counts_per_variant))
100%|██████████| 20/20 [00:17<00:00, 1.13it/s]
שלב 4: עיבוד לאחר-הרצה והחזרת התוצאה בפורמט קלאסי רצוי
כל בדיקה משתמשת בשערי שזירה בין קיוביט עזר אחד לקיוביט יעד אחד. קיוביט העזר מתחיל במצב , כך ש- מייצב את הקלט שלו. הפצת קדימה דרך המעגל הבדוק מפיקה אופרטור Pauli על הפלט שהאיברים שאינם זהות שלו מגדירים את התמיכה (support) של הבדיקה. בדיקה עוברת כאשר לביטים בתמיכה שלה יש זוגיות זוגית. דגימה נשמרת רק כאשר כל בדיקה עוברת.
ה-get_postselection_method של כל CheckedCircuit מחזיר פונקציה הממפה מחרוזת ביטים שנמדדה לוקטור תסמונת. שמרו את הדגימות שהתסמונת שלהן אפס עבור כל בדיקה, והשליכו את השאר. הגרף שלהלן מראה שהוספת בדיקות נוספות מורידה את שיעור הבחירה המוקדמת. שיעור בחירה מוקדמת נמוך יותר דורש יותר ירי (shots) כדי להגיע לדיוק יעד, כך שקיימת פשרה בין יכולת הזיהוי לעלות הדגימה. השיעור נראה מתכנס, מה שמצביע על כך שבדיקות נוספות תורמות פחות יכולת זיהוי.
rate_per_variant = []
kept_per_stab = []
for i, (_, checked_counts_per_variant) in enumerate(counts):
    rates = []
    kept_at_num_checks = None
    for k, variant_counts in enumerate(checked_counts_per_variant):
        ps_fn = checked_circuits[i][k].get_postselection_method()
        kept = {
            bs: n for bs, n in variant_counts.items() if not ps_fn(bs).any()
        }
        rates.append(sum(kept.values()) / num_shots)
        if k == num_checks:
            kept_at_num_checks = kept
    rate_per_variant.append(rates)
    kept_per_stab.append(kept_at_num_checks)

max_len = max(len(s) for s in rate_per_variant)
rates_arr = np.full((len(rate_per_variant), max_len), np.nan)
for i, s in enumerate(rate_per_variant):
    rates_arr[i, : len(s)] = s
ks = np.arange(max_len)

fig, ax = plt.subplots(figsize=(8, 4))
ax.plot(ks, rates_arr.T, color="#ff8c00", alpha=0.15, linewidth=1)
ax.plot(
    ks,
    np.nanmedian(rates_arr, axis=0),
    color="black",
    linewidth=1,
    linestyle="--",
    label="median",
)
ax.set_xlabel("Checks committed")
ax.set_ylabel("Postselection rate")
ax.set_ylim((0, 1.05))
ax.set_title(
    f"Per-stabilizer postselection rate ({len(rates_arr)} stabilizers)"
)
ax.legend()
ax.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()

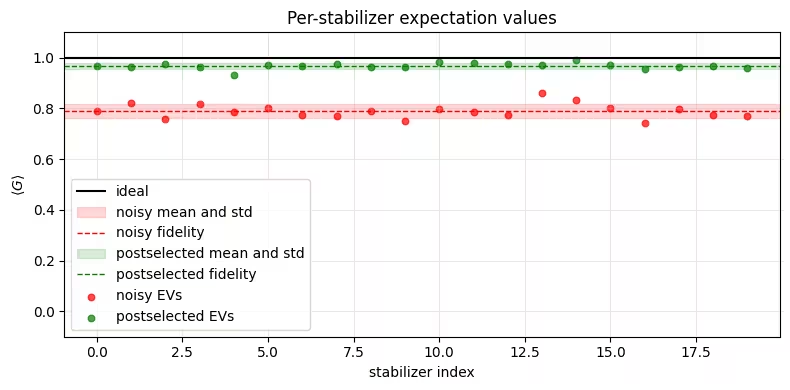
כעת השוו את הנאמנות של המצב הרועש החשוף לזו של המצב לאחר בחירה מוקדמת. בחירה מוקדמת רק של הדגימות שבהן לא זוהתה שגיאה מעלה את ערך התוחלת של כל מייצב, ולכן את הנאמנות המוערכת. הערכים לאחר בחירה מוקדמת משתמשים בפחות דגימות מהערכים הגולמיים, ובכל זאת ערכי התוחלת מדויקים יותר והשונות הנדגמת נמוכה יותר. שימו לב גם שהשיעור הממוצע של בחירה מוקדמת קרוב לנאמנות הרועשת. זה מה שניתן לצפות לו כאשר הבדיקות מזהות כמעט את כל הדגימות השגויות: החלק של הדגימות שעוברות כל בדיקה מתקרב לחלק הדגימות חסרות השגיאה, שהוא הנאמנות של המצב הרועש.
results = []
for i, ((noisy_counts, _), kept) in enumerate(
    zip(counts, kept_per_stab, strict=True)
):
    results.append(
        (
            expectation(noisy_counts, stabilizers[i]),
            expectation(kept, stabilizers[i]),
            sum(kept.values()) / num_shots,
        )
    )

fidelity_noisy = float(np.nanmean([r[0] for r in results]))
fidelity_postsel = float(np.nanmean([r[1] for r in results]))
psr = float(np.mean([r[2] for r in results]))
print(
    f"ideal fidelity:          1.0\n"
    f"noisy fidelity:          {fidelity_noisy:.4f}\n"
    f"postselected fidelity:   {fidelity_postsel:.4f}\n"
    f"mean postselection rate: {psr:.3f}"
)

evs_ideal = np.ones(len(results))
evs_noisy = np.array([r[0] for r in results])
evs_post = np.array([r[1] for r in results])
idx = np.arange(len(results))

def strip(ax, ys, color, label):
    m, s = np.nanmean(ys), np.nanstd(ys)
    ax.axhspan(
        m - s, m + s, color=color, alpha=0.15, label=f"{label} mean and std"
    )
    ax.axhline(
        m, color=color, linewidth=1, linestyle="--", label=f"{label} fidelity"
    )

fig, ax = plt.subplots(figsize=(8, 4))
ax.axhline(np.nanmean(evs_ideal), color="black", linewidth=1.5, label="ideal")
strip(ax, evs_noisy, "red", "noisy")
strip(ax, evs_post, "green", "postselected")
ax.scatter(idx, evs_noisy, color="red", s=22, alpha=0.7, label="noisy EVs")
ax.scatter(
    idx,
    evs_post,
    color="green",
    s=22,
    alpha=0.7,
    label="postselected EVs",
)
ax.set_xlabel("stabilizer index")
ax.set_ylabel(r"$\langle G \rangle$")
ax.set_ylim((-0.1, 1.1))
ax.set_title("Per-stabilizer expectation values")
ax.legend(loc="lower left")
ax.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()

M = np.arange(1, len(results) + 1)
fig, ax = plt.subplots(figsize=(8, 4))
for ys, color, label in [
    (evs_ideal, "black", "ideal"),
    (evs_noisy, "red", "noisy"),
    (evs_post, "green", "postselected"),
]:
    cm, sem = cum_mean_sem(ys)
    ax.plot(M, cm, color=color, linewidth=1.5, label=label)
    ax.fill_between(M, cm - sem, cm + sem, color=color, alpha=0.15)
ax.set_xlabel("number of stabilizers averaged")
ax.set_ylabel("running fidelity estimate")
ax.set_title("Fidelity convergence versus number of stabilizers")
ax.legend()
ax.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()
ideal fidelity:          1.0
noisy fidelity:          0.7899
postselected fidelity:   0.9679
mean postselection rate: 0.780

ציון הגמא מדווח כמה מערוץ הרעש המדומה נשאר בלתי מזוהה על ידי הבדיקות. שרטוט ציון הגמא כנגד מספר הבדיקות המוטמעות מראה כיצד יכולת הזיהוי משתפרת עם הוספת כל בדיקה. ערך של 1.0 פירושו שהבדיקות תופסות את כל הרעש המדומה. העקומות יורדות לכיוון 1.0 ככל שמוטמעות יותר בדיקות, מה שמראה שכל בדיקה נוספת תופסת חלק מהשגיאה הבלתי מזוהה שנותרה.
stab_scores = [
    [variant.cost for variant in checked_circ_result]
    for checked_circ_result in checked_circuits
]
max_len = max(len(s) for s in stab_scores)
scores = np.full((len(stab_scores), max_len), np.nan)
for i, s in enumerate(stab_scores):
    scores[i, : len(s)] = s
ks = np.arange(max_len)

fig, ax = plt.subplots(figsize=(8, 4))
ax.plot(ks, scores.T, color="#4682b4", alpha=0.15, linewidth=1)
ax.plot(
    ks,
    np.nanmedian(scores, axis=0),
    color="black",
    linewidth=1,
    linestyle="--",
    label="median",
)
ax.set_xlabel("Checks committed")
ax.set_ylabel("Gamma")
ax.set_yscale("log")
ax.set_title(f"Per-stabilizer gamma curves ({len(scores)} stabilizers)")
ax.legend()
ax.grid(True, alpha=0.3, which="both")
plt.tight_layout()
plt.show()

דוגמת חומרה בקנה מידה גדול
אותו תהליך עבודה רץ על חומרה עם מטען גדול ועמוק יותר. סעיף זה משתמש שוב ב-Backend מדוגמת הסימולטור אך בונה פריסה חדשה בת 20 קיוביטים עם זוגות יעד ועזר משלה ומנהל מעברים (pass manager) משלה, ולאחר מכן שולח את המעגלים ל-QPU בעבודה אחת. בגודל זה, רוב הירי מפעיל לפחות בדיקה אחת, כך ששיעור הבחירה המוקדמת נמוך, וכל מעגל זקוק לתקציב ירי גדול כדי שיישארו מספיק דגימות. הדוגמה לכן מרכזת את תקציבה על מספר מצומצם של מייצבים נדגמים; זוהי עדיין הערכת נאמנות חסרת הטיה, אך גסה יותר מהממוצע על פני מייצבים רבים בדוגמת הסימולטור.
דבר אחד משתנה ביחס לדוגמת הסימולטור: במקום להסיק ערוץ דה-פולריזציה אחיד מנתוני כיול, סעיף זה לומד את מודל הרעש עם NoiseLearner ובונה את המודל של qiskit-paulice מהתוצאה באמצעות NoiseModel.from_pauli_lindblad_maps. מודל Pauli-Lindblad נלמד לוכד את המבנה המרחבי של הרעש בפריסה הספציפית הזו, במקום להניח שכל קשת רועשת באותה מידה, כך שמיקום הבדיקות מדורג מול רעש דומה יותר לרעש שמשפיע על ה-QPU. למידת הרעש דורשת דגימה של ה-QPU ויש לקחת זאת בחשבון בכל תקציב דגימה כולל של QPU.
הפרמטרים שלהלן קובעים את מספר הקיוביטים, העומק, מספר המייצבים, ומספר הירי. הגדילו את hw_num_shots ביחס הפוך לשיעור הבחירה המוקדמת: בשיעור של 3%, 40,000 ירי משאירים כ-1,200 דגימות שנבחרו מראש לכל מעגל. הגדילו את hw_num_stabilizers להערכת נאמנות מדויקת יותר, במחיר של יותר מעגלים לכל עבודה, שכל אחד מהם דורש את אותו תקציב ירי.
שלבים 1-4 (מכווצים לבלוק קוד יחיד)
התא הבא מריץ את אותם ארבעה שלבים כמו דוגמת הסימולטור. הוא בונה את המטען הגדול יותר ודוגם כמה מייצבים (שלב 1); בוחר פריסה, לומד עליה את מודל הרעש, ומוצא את המעגל הבדוק המלא עבור כל מייצב (שלב 2); שולח עבודת Sampler אחת המכילה גם את המעגלים החשופים וגם את הבדוקים (שלב 3); ובוחר מראש (postselects) את הספירות הבדוקות כדי להשוות את הערכות הנאמנות הרועשת והלאחר-בחירה-מוקדמת, לכל מייצב ובממוצע (שלב 4). בגודל זה, מנייה של כל קבוצת המייצבים כמו בדוגמת הסימולטור אינה ישימה, ולכן התא דוגם תת-קבוצה אקראית של מייצבים כדי לחשב הערכה של הנאמנות.
שימו לב ששלב 2 עושה כאן יותר מאשר בדוגמת הסימולטור: למידת מודל הרעש שולחת עבודת NoiseLearner משלה לפני עבודת ה-Sampler, כך שהתא מריץ שתי עבודות בסך הכול. הן נושאות את התגיות TUT_ASPC_LEARN ו-TUT_ASPC כדי שתוכלו למצוא אותן מאוחר יותר. ראו ארגון וחיפוש לפי תגיות עבודה למידע נוסף על תיוג עבודות.
# -------------------------Step 1: build a larger payload and sample stabilizers-------------------------
hw_num_qubits = 20
hw_depth = 36
hw_num_stabilizers = 10
hw_num_shots = 40_000

hw_circuit = random_clifford_circuit(hw_num_qubits, hw_depth, rng)
hw_no_meas = hw_circuit.remove_final_measurements(inplace=False)

# Enumerating all 2^n stabilizers is infeasible at this size, so draw each
# stabilizer by composing a random subset of the group generators
hw_generators = [
    Pauli(label) for label in Clifford(hw_no_meas).to_labels(mode="S")
]
sample_rng = np.random.default_rng(seed)
hw_stabilizers = []
while len(hw_stabilizers) < hw_num_stabilizers:
    mask = sample_rng.integers(0, 2, hw_num_qubits).astype(bool)
    if not mask.any():
        continue  # skip the identity
    stabilizer = Pauli("I" * hw_num_qubits)
    for generator, chosen in zip(hw_generators, mask, strict=True):
        if chosen:
            stabilizer = stabilizer.compose(generator)
    hw_stabilizers.append(stabilizer)

# -------------------------Step 2: find a 20-qubit layout, learn its noise, and add checks-------------------------
# A single bad coupler or bad-readout qubit on the path drags every
# stabilizer down, so search harder and with tighter error thresholds
hw_layout = find_check_layout(
    backend,
    hw_num_qubits,
    rng,
    num_trials=500,
    max_gate_error=0.015,
    max_readout_error=0.05,
)
hw_target_qubits, hw_ancilla_qubits = get_check_qubits(backend, hw_layout)
hw_pm = generate_preset_pass_manager(
    optimization_level=0, backend=backend, initial_layout=hw_layout
)
print(f"Layout with {len(hw_target_qubits)} check pairs: {hw_layout}")

# ----- learn a Pauli-Lindblad noise model on this layout -----
# The simulator example scored checks against a uniform depolarizing channel
# inferred from calibration data. Here, learn the noise instead: NoiseLearner
# runs its own job on the QPU and returns a Pauli-Lindblad channel per unique
# entangling layer, so the checks are placed against the noise this layout
# actually has, including its spatial structure. All the sampled stabilizers
# share the same entangling layers and differ only in their final basis
# rotation, so learning on the bare payload covers all of them.
learner = NoiseLearner(
    mode=backend,
    options={
        "max_layers_to_learn": 4,
        "num_randomizations": 32,
        "shots_per_randomization": 128,
        "environment": {"job_tags": ["TUT_ASPC_LEARN"]},
    },
)
learner_job = learner.run([hw_pm.run(hw_circuit)])
print(f"Submitted noise-learner job {learner_job.job_id()}")
hw_layer_errors = learner_job.result().data

# To see how much the learned model helps, swap the next line for the
# simulator example's uniform model - a one-line change:
# hw_noise_model = NoiseModel.from_backend(backend, hw_layout, uniform_gate_noise=True)
hw_noise_model = learned_noise_model(hw_layer_errors, hw_layout)
# NoiseLearner characterizes gate noise only, so keep the readout estimate
# from calibration data rather than leaving it unset
hw_noise_model.readout_noise = NoiseModel.from_backend(
    backend, hw_layout, uniform_gate_noise=True
).readout_noise
print(
    f"Learned {len(hw_layer_errors)} layers; "
    f"readout noise {hw_noise_model.readout_noise:.5f}"
)

# ----- add the fully checked circuit per stabilizer -----
hw_noisy_circuits = []
hw_checked_circuits = []
for i, pauli in enumerate(tqdm(hw_stabilizers)):
    bare = hw_pm.run(append_basis_rotation(hw_circuit, pauli))
    hw_noisy_circuits.append(bare)
    variants = add_pauli_checks(
        bare,
        hw_target_qubits,
        hw_noise_model,
        ancilla_qubits=hw_ancilla_qubits,
        cost="gamma",
        method="windowed",
        seed=seed + 1 + i,
    )
    hw_checked_circuits.append(variants[-1])  # keep the fully checked circuit

# -------------------------Step 3: submit one Sampler job with the bare and checked circuits-------------------------
sampler = Sampler(mode=backend)
sampler.options.default_shots = hw_num_shots
sampler.options.environment.job_tags = ["TUT_ASPC"]

pubs = hw_noisy_circuits + [cc.circuit for cc in hw_checked_circuits]
job = sampler.run(pubs)
print(f"Submitted job {job.job_id()} with {len(pubs)} circuits")

# -------------------------Step 4: postselect and compare fidelity-------------------------
result = job.result()
n_stab = len(hw_stabilizers)

hw_results = []
for i in range(n_stab):
    noisy_counts = result[i].join_data().get_counts()
    checked_counts = result[n_stab + i].join_data().get_counts()
    ps_fn = hw_checked_circuits[i].get_postselection_method()
    kept = {bs: c for bs, c in checked_counts.items() if not ps_fn(bs).any()}
    hw_results.append(
        (
            expectation(noisy_counts, hw_stabilizers[i]),
            expectation(kept, hw_stabilizers[i]),
            sum(kept.values()) / sum(checked_counts.values()),
        )
    )

hw_fidelity_noisy = float(np.nanmean([r[0] for r in hw_results]))
hw_fidelity_postsel = float(np.nanmean([r[1] for r in hw_results]))
hw_psr = float(np.mean([r[2] for r in hw_results]))
print(
    f"noisy fidelity estimate:        {hw_fidelity_noisy:.4f}\n"
    f"postselected fidelity estimate: {hw_fidelity_postsel:.4f}\n"
    f"mean postselection rate:        {hw_psr:.4f} "
    f"(~{int(round(hw_psr * hw_num_shots))} kept shots per circuit)"
)

# Per-stabilizer breakdown. The postselection rate varies from stabilizer to
# stabilizer, so a stabilizer whose postselected value barely moves is usually
# one whose checks rejected little; the kept-shot count says how much of the
# gap is statistics rather than signal.
print("\nper-stabilizer results:")
print(
    f"{'idx':>3}  {'noisy':>8}  {'postsel':>8}  {'psr':>7}  {'kept shots':>10}"
)
for i, (noisy, post, psr_i) in enumerate(hw_results):
    print(
        f"{i:>3}  {noisy:>8.4f}  {post:>8.4f}  {psr_i:>7.4f}  "
        f"{int(round(psr_i * hw_num_shots)):>10}"
    )

hw_noisy = np.array([r[0] for r in hw_results])
hw_post = np.array([r[1] for r in hw_results])
idx = np.arange(n_stab)

fig, ax = plt.subplots(figsize=(9, 4))
ax.axhline(1.0, color="black", linewidth=1.5, label="ideal")
strip(ax, hw_noisy, "red", "noisy")
strip(ax, hw_post, "green", "postselected")
ax.scatter(idx, hw_noisy, color="red", s=22, alpha=0.7, label="noisy EVs")
ax.scatter(
    idx,
    hw_post,
    color="green",
    s=22,
    alpha=0.7,
    label="postselected EVs",
)
ax.set_xlabel("stabilizer index")
ax.set_ylabel(r"$\langle G \rangle$")
ax.set_ylim((-0.1, 1.1))
ax.set_xticks(idx)
ax.set_title("Per-stabilizer expectation values on hardware")
# Outside the axes so it cannot hide a data point
ax.legend(loc="center left", bbox_to_anchor=(1.02, 0.5), frameon=False)
ax.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()
Layout with 11 check pairs: [153, 152, 151, 138, 131, 130, 129, 118, 109, 110, 111, 98, 91, 90, 89, 78, 69, 70, 71, 58]
Submitted noise-learner job d9f4mncjeosc73fjfmkg
Learned 4 layers; readout noise 0.00470
100%|██████████| 10/10 [01:01<00:00, 6.18s/it]
Submitted job d9f4s04jeosc73fjftkg with 20 circuits
noisy fidelity estimate:        0.3685
postselected fidelity estimate: 0.6869
mean postselection rate:        0.2851 (~11404 kept shots per circuit)

per-stabilizer results:
idx     noisy   postsel      psr  kept shots
  0    0.3769    0.6918   0.3247       12987
  1    0.3745    0.6760   0.2999       11995
  2    0.3659    0.6389   0.3549       14196
  3    0.3821    0.7060   0.2660       10641
  4    0.3653    0.7475   0.2531       10124
  5    0.3752    0.7022   0.2698       10791
  6    0.3508    0.7144   0.2711       10842
  7    0.3485    0.7087   0.2381        9523
  8    0.3825    0.6289   0.2928       11711
  9    0.3630    0.6549   0.2808       11232

עבור מעגלים בגודל זה, רוב הדגימות מכילות לפחות שגיאה אחת שזוהתה, כך ששיעור הבחירה המוקדמת קטן והבחירה המוקדמת משליכה את רוב הירי. הדגימות שעוברות כל בדיקה נותנות ערך תוחלת טוב בהרבה מהמעגל החשוף, וערכי כל מייצב נפרדים בבירור מקו הבסיס הרועש. כדי לחדד את הערכת הנאמנות, דגמו יותר מייצבים עם אותו תקציב ירי לכל מעגל. כדי להעלות את שיעור הבחירה המוקדמת, צמצמו את עומק המעגל או הטמיעו פחות בדיקות; כדי לדחוף למטענים גדולים יותר, הגדילו את תקציב הירי ביחס הפוך לשיעור הבחירה המוקדמת.
השלבים הבאים
אם מצאתם את העבודה הזו מעניינת, ייתכן שתתעניינו בחומר הבא:
-
המדריך על קודי חזרה להיכרות עם תיקון שגיאות קוונטי.
-
תיעוד
qiskit-pauliceעבור ה-API המלא למציאת בדיקות, ומאגר ה-GitHub של החבילה עבור קוד המקור. -
המאמר זיהוי שגיאות בעלות עומס נמוך עם קודי מרחב-זמן עבור התאוריה שמאחורי הבדיקות.
מקורות
-
[1] Martiel, S., & Javadi-Abhari, A. (2025). Low-overhead error detection with spacetime codes. arXiv preprint arXiv:2504.15725.
-
[2] van den Berg, E., Bravyi, S., Gambetta, J. M., Jurcevic, P., Maslov, D., & Temme, K. (2023). Single-shot error mitigation by coherent Pauli checks. Physical Review Research, 5(3), 033193.