ניהול ביצועים: פונקציית Qiskit מאת Q-CTRL Fire Opal
ראו את ה-API reference
Qiskit Functions הן תכונה ניסיונית הזמינה רק למשתמשי תוכנית IBM Quantum® Premium Plan, Flex Plan ו-On-Prem (דרך IBM Quantum Platform API). הן בסטטוס גרסת תצוגה מקדימה וכפופות לשינויים.
Package versions
הקוד בעמוד זה פותח באמצעות הדרישות הבאות. אנו ממליצים להשתמש בגרסאות אלו או חדשות יותר.
qiskit[all]~=2.3.1
qiskit-ibm-runtime~=0.45.1
סקירה כללית
Fire Opal Performance Management מאפשרת לכולם להשיג תוצאות משמעותיות ממחשבי קוונטום בקנה מידה גדול, מבלי שיצטרכו להיות מומחי חומרה קוונטית. בעת הרצת Circuit-ים עם Fire Opal Performance Management, טכניקות דיכוי שגיאות מבוססות AI מיושמות אוטומטית, ומאפשרות להרחיב את קנה המידה לבעיות גדולות יותר עם יותר Gate-ים ו-Qubit-ים. גישה זו מצמצמת את מספר ה-shots הנדרשים להגעה לתשובה הנכונה, ללא תקורה נוספת — מה שמביא לחיסכון משמעותי הן בזמן החישוב והן בעלויות.
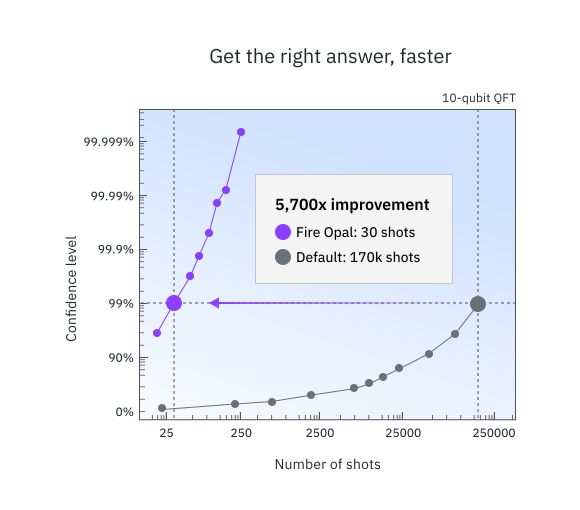
ניהול ביצועים מדכא שגיאות ומגדיל את ההסתברות לקבל את התשובה הנכונה על חומרה רועשת. במילים אחרות, הוא מגדיל את יחס האות-לרעש. התמונה הבאה מציגה כיצד הדיוק המשופר שמאפשר ניהול ביצועים יכול לצמצם את הצורך ב-shots נוספים במקרה של אלגוריתם Quantum Fourier Transform עם 10 qubit-ים. עם 30 shots בלבד, Q-CTRL מגיעה לסף הביטחון של 99%, בעוד ש-Sampler ברירת המחדל (QiskitRuntime Sampler, optimization_level=3 ו-resilience_level=1, ibm_sherbrooke) דורש 170,000 shots. בכך שמגיעים לתשובה הנכונה מהר יותר, חוסכים זמן ריצה חישובי משמעותי.
אפשר להשתמש בפונקציית ניהול הביצועים עם כל אלגוריתם, וניתן לשלב אותה בקלות במקום ה-פרימיטיבים של IBM Quantum הסטנדרטיים. מאחורי הקלעים, מספר טכניקות דיכוי שגיאות פועלות יחד כדי למנוע שגיאות בזמן ריצה. כל שיטות ה-pipeline של Fire Opal מוגדרות מראש ואינן תלויות באלגוריתם, כך שתמיד מקבלים את הביצועים הטובים ביותר ישר מהקופסה.
לקבלת גישה לניהול ביצועים, צרו קשר עם Q-CTRL.
תיאור
ל-Fire Opal Performance Management שתי אפשרויות ריצה הדומות לפרימיטיבים של IBM Quantum, כך שניתן בקלות להשתמש ב-Sampler וב-Estimator של Q-CTRL במקומם. זרימת העבודה הכללית לשימוש בפונקציית ניהול הביצועים היא:
- הגדירו את ה-Circuit (ואת האופרטורים במקרה של ה-Estimator).
- הריצו את ה-Circuit.
- אחזרו את התוצאות.
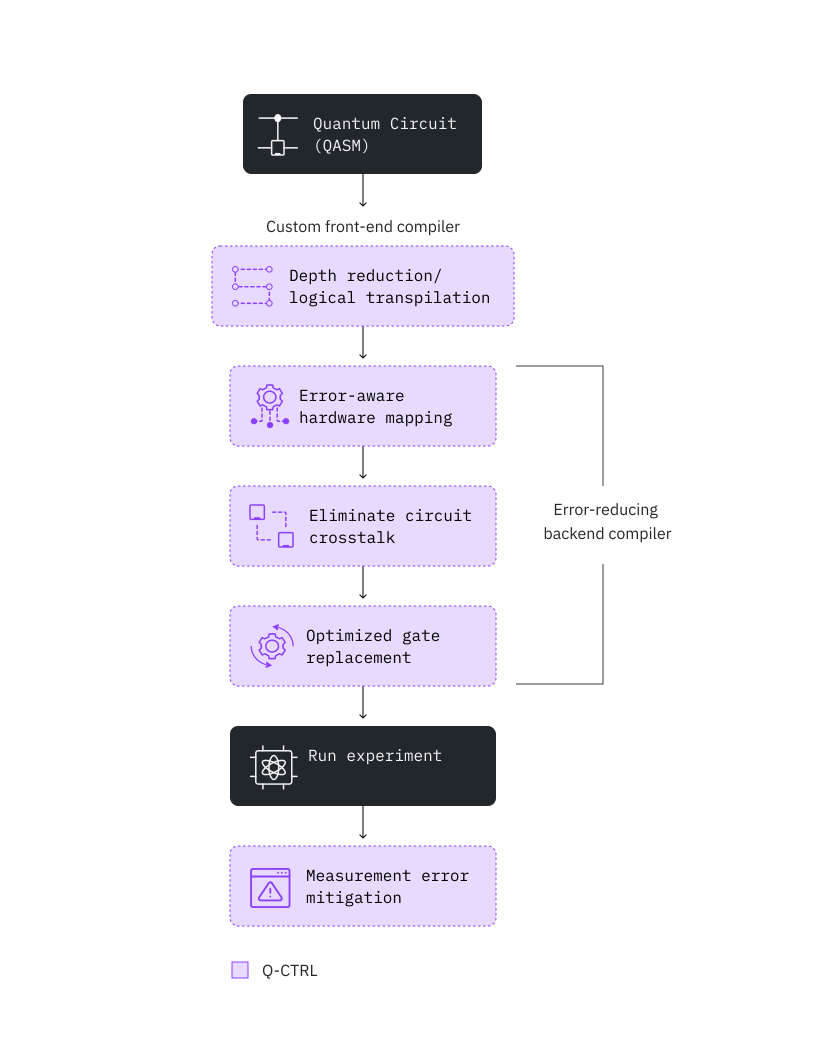
כדי לצמצם את הרעש של החומרה, Fire Opal משתמשת במגוון טכניקות דיכוי שגיאות מבוססות AI כפי שמוצג בתמונה הבאה. עם Fire Opal, כל ה-pipeline אוטומטי לחלוטין וללא כל צורך בהגדרות.
ה-pipeline של Fire Opal מבטל את הצורך בתקורה נוספת, כמו זמן ריצה קוונטי מוגדל או qubit-ים פיזיים נוספים. שימו לב שזמן העיבוד הקלאסי עדיין משפיע (ראו את הקטע מדדי ביצועים לאומדנים, כאשר "Total time" משקף הן עיבוד קלאסי והן קוונטי). בניגוד למיתון שגיאות (error mitigation), שדורש תקורה בצורת דגימה, דיכוי השגיאות של Fire Opal פועל הן ברמת ה-Gate והן ברמת הפולס כדי לטפל במקורות שונים של רעש ולהקטין את הסיכוי שתתרחש שגיאה. מניעת השגיאות מייתרת את הצורך בעיבוד יקר לאחר המדידה.
התמונה הבאה מציגה את שיטות דיכוי השגיאות ש-Fire Opal Performance Management מפעיל באופן אוטומטי.
הפונקציה מציעה שני פרימיטיבים, Sampler ו-Estimator, והקלט והפלט של שניהם מרחיבים את המפרט המיושם עבור הפרימיטיבים של IBM Quantum V2.
מדדי ביצועים
תוצאות בנצ'מרקינג אלגוריתמי שפורסמו מדגימות שיפור ביצועים משמעותי על פני אלגוריתמים שונים, כולל Bernstein-Vazirani, Quantum Fourier Transform, חיפוש Grover, אלגוריתם אופטימיזציה קוונטית מקורבת, ו-Variational Quantum Eigensolver. שאר החלק הזה מספק פרטים נוספים על סוגי האלגוריתמים שניתן להריץ, כמו גם את הביצועים וזמני הריצה הצפויים.
המחקרים העצמאיים הבאים מדגימים כיצד ניהול הביצועים של Q-CTRL מאפשר מחקר אלגוריתמי בקנה מידה שובר שיאים:
- Parametrized Energy-Efficient Quantum Kernels for Network Service Fault Diagnosis - למידת גרעין קוונטי עד 50 qubit-ים
- Tensor-based quantum phase difference estimation for large-scale demonstration - אומדן פאזה קוונטית עד 33 qubit-ים
- Hierarchical Learning for Quantum ML: Novel Training Technique for Large-Scale Variational Quantum Circuits - טעינת נתונים קוונטית עד 21 qubit-ים
הטבלה הבאה מספקת מדריך גס לדיוק ולזמני ריצה מריצות בנצ'מרקינג קודמות על ibm_fez. הביצועים על מכשירים אחרים עשויים להשתנות. זמן השימוש מבוסס על הנחה של 10,000 shots לכל Circuit. "מספר ה-Qubit-ים" המצוין אינו מגבלה קשה אלא מייצג סף גס שבו ניתן לצפות לדיוק עקבי מאוד בפתרונות. גדלי בעיות גדולים יותר נפתרו בהצלחה, ובדיקה מעבר למגבלות אלה מוזמנת.
| דוגמה | מספר qubit-ים | דיוק | מדד דיוק | זמן כולל (שניות) | שימוש ב-Runtime (שניות) | פרימיטיב (מצב) |
|---|---|---|---|---|---|---|
| Bernstein–Vazirani | 50Q | 100% | שיעור הצלחה (אחוז הריצות שבהן התשובה הנכונה היא ה-bitstring בעל הספירה הגבוהה ביותר) | 10 | 8 | Sampler |
| Quantum Fourier Transform | 30Q | 100% | שיעור הצלחה (אחוז הריצות שבהן התשובה הנכונה היא ה-bitstring בעל הספירה הגבוהה ביותר) | 10 | 8 | Sampler |
| Quantum Phase Estimation | 30Q | 99.9998% | דיוק הזווית שנמצאה: 1- abs(real_angle - angle_found)/pi | 10 | 8 | Sampler |
| סימולציה קוונטית: מודל Ising (15 צעדים) | 20Q | 99.775% | (מוגדר למטה) | 60 (לכל צעד) | 15 (לכל צעד) | Estimator |
| סימולציה קוונטית 2: דינמיקה מולקולרית (20 נקודות זמן) | 34Q | 96.78% | (מוגדר למטה) | 10 (לכל נקודת זמן) | 6 (לכל נקודת זמן) | Estimator |
הגדרת דיוק מדידת ערך ציפייה — המדד מוגדר כדלקמן:
כאשר = ערך ציפייה אידיאלי, = ערך ציפייה נמדד, = ערך מקסימלי אידיאלי, ו- = ערך מינימלי אידיאלי. הוא פשוט הממוצע של ערך על פני מדידות מרובות.
מדד זה משמש מפני שהוא אינווריאנטי להזזות גלובליות ולשינויי קנה מידה של טווח הערכים האפשריים. במילים אחרות, בין אם תזיזו את טווח ערכי הציפייה האפשריים למעלה או למטה ובין אם תגדילו את הפריסה, ערך אמור להישאר עקבי.
תחילת עבודה
Fire Opal Performance Management משתמשת ב-Qiskit גרסה 2.0.0, שהיא הגרסה המומלצת. הגרסאות הנתמכות הן Qiskit >=v2.0.0.
אמתו את הזהות שלכם באמצעות מפתח ה-API של IBM Quantum Platform, ובחרו את פונקציית ה-Qiskit כך. (הקטע הזה מניח שכבר שמרתם את החשבון שלכם בסביבה המקומית שלכם.)
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"matplotlib": "matplotlib", "numpy": "numpy", "qiskit": "qiskit", "qiskit_ibm_catalog": "qiskit-ibm-catalog", "qiskit_ibm_runtime": "qiskit-ibm-runtime"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
# This cell is hidden from users. It hides the "...You have imported samplomatic..." warning.
import warnings

warnings.filterwarnings("ignore", message=".*You have imported samplomatic*")
from qiskit_ibm_catalog import QiskitFunctionsCatalog

catalog = QiskitFunctionsCatalog(channel="ibm_quantum_platform")

# verify that you have access to the function
catalog.list()
[QiskitFunction(qunova/hivqe-chemistry),
 QiskitFunction(global-data-quantum/quantum-portfolio-optimizer),
 QiskitFunction(algorithmiq/tem),
 QiskitFunction(qedma/qesem),
 QiskitFunction(multiverse/singularity),
 QiskitFunction(ibm/circuit-function),
 QiskitFunction(q-ctrl/optimization-solver),
 QiskitFunction(colibritd/quick-pde),
 QiskitFunction(q-ctrl/performance-management),
 QiskitFunction(kipu-quantum/iskay-quantum-optimizer)]
# Access Function
perf_mgmt = catalog.load("q-ctrl/performance-management")
אם ברצונכם להשתמש ב-Backend שפונקציה זו אינה תומכת בו כרגע, פנו ל-Q-CTRL כדי להוסיף תמיכה.
פרימיטיב Estimator
דוגמה ל-Estimator
השתמשו בפרימיטיב Estimator של Fire Opal Performance Management כדי לקבוע את ערך הציפייה של זוג Circuit-observable יחיד.
בנוסף לחבילות qiskit-ibm-catalog ו-qiskit, תשתמשו גם בחבילת numpy להרצת דוגמה זו. ניתן להתקין חבילה זו על ידי ביטול ההערה בתא הבא אם אתם מריצים דוגמה זו ב-notebook באמצעות IPython kernel.
# %pip install numpy
1. יצירת ה-Circuit
כדוגמה, צרו אופרטור Hermitian אקראי ו-observable כקלט לפונקציית ניהול הביצועים.
import numpy as np
from qiskit.circuit.library import iqp
from qiskit.quantum_info import random_hermitian, SparsePauliOp

n_qubits = 50

# Generate a random circuit
mat = np.real(random_hermitian(n_qubits, seed=1234))
circuit = iqp(mat)
circuit.measure_all()

# Define observables as a string
observable = SparsePauliOp("Z" * n_qubits)
# Create PUB tuple
estimator_pubs = [(circuit, observable)]
2. הרצת ה-Circuit
הריצו את ה-Circuit, ובאופן אופציונלי הגדירו את ה-Backend ואת מספר ה-shots.
# This cell is hidden from users
from qiskit_ibm_runtime import QiskitRuntimeService

service = QiskitRuntimeService()
backend_name = service.least_busy().name
# Run the circuit using Estimator
qctrl_estimator_job = perf_mgmt.run(
    primitive="estimator",
    pubs=estimator_pubs,
    backend_name=backend_name,
)
ניתן להשתמש ב-Qiskit Serverless APIs המוכרים לבדיקת סטטוס עומס העבודה של פונקציית ה-Qiskit:
qctrl_estimator_job.status()
'QUEUED'
3. אחזור התוצאה
# Retrieve the counts from the result list
result = qctrl_estimator_job.result()
התוצאות הן באותו פורמט כמו תוצאת Estimator:
import numpy

result_str = str(result)

with numpy.printoptions(threshold=200):
    print(
        f"The result of the submitted job had {len(result)} PUB "
        f"and has a value:\n {result[0]}\n"
    )

print("The associated PubResult of this job has the following DataBins:")
print(f"{result[0].data}\n")

print(f"And this DataBin has attributes: {result[0].data.keys()}")

print("The expectation values measured from this PUB are:")
print(f"{result[0].data.evs}")
The result of the submitted job had 1 PUB
The result of the submitted job had 1 PUB and has a value:
 PubResult(data=DataBin(evs=0.0195, stds=0.9998098569228051), metadata={'precision': None})

The associated PubResult of this job has the following DataBins:
DataBin(evs=0.0195, stds=0.9998098569228051)

And this DataBin has attributes: dict_keys(['evs', 'stds'])
The expectation values measured from this PUB are:
0.0195
פרימיטיב Sampler
דוגמה של Sampler
השתמשו בפרימיטיב Sampler של Fire Opal Performance Management כדי להריץ Circuit של Bernstein–Vazirani. האלגוריתם הזה, שמשמש למציאת מחרוזת נסתרת מהפלטים של פונקציית קופסה שחורה, הוא אלגוריתם בנצ'מרק נפוץ כי יש לו תשובה נכונה אחת בלבד. 1. יצירת ה-Circuit
הגדירו את התשובה הנכונה לאלגוריתם, את המחרוזת הנסתרת, ואת ה-Circuit של Bernstein–Vazirani. אפשר לשנות את רוחב ה-Circuit פשוט על ידי שינוי circuit_width.
import qiskit

circuit_width = 35
hidden_bitstring = "1" * circuit_width

# Create circuit, reserving one qubit for BV oracle
bv_circuit = qiskit.QuantumCircuit(circuit_width + 1, circuit_width)
bv_circuit.x(circuit_width)
bv_circuit.h(range(circuit_width + 1))
for input_qubit, bit in enumerate(reversed(hidden_bitstring)):
    if bit == "1":
        bv_circuit.cx(input_qubit, circuit_width)
bv_circuit.barrier()
bv_circuit.h(range(circuit_width + 1))
bv_circuit.barrier()
for input_qubit in range(circuit_width):
    bv_circuit.measure(input_qubit, input_qubit)

# Create PUB tuple
sampler_pubs = [(bv_circuit,)]
2. הרצת ה-Circuit
הריצו את ה-Circuit, ובאופן אופציונלי הגדירו את ה-Backend ואת מספר ה-shots.
# Run the circuit using Sampler
qctrl_sampler_job = perf_mgmt.run(
    primitive="sampler",
    pubs=sampler_pubs,
    backend_name=backend_name,
)
בדקו את הסטטוס של עבודת Qiskit Function שלכם או קבלו תוצאות כך:
# Print the ID so you can use it later, if necessary
print(qctrl_sampler_job.job_id)

qctrl_sampler_job.status()
60fe2fa1-a860-43e4-8615-c6ac4180f93b
'QUEUED'
3. אחזור התוצאה
# Retrieve the job results
sampler_result = qctrl_sampler_job.result()
# Get results for the first (and only) PUB
pub_result = sampler_result[0]
counts = pub_result.data.c.get_counts()

print("Counts for the meas output register (limited to 30 results):")
for i, (bitstring, count) in enumerate(counts.items()):
    if i >= 50:
        print(f"  ... ({len(counts) - 30} more items)")
        break
    print(f"  {bitstring}: {count}")
Counts for the meas output register (limited to 30 results):
  11111111111111111111111111111111111: 1661
  11111111111111111111111111110111111: 60
  11111111111111111111111111111101111: 54
  11111111111111111111111111111110111: 54
  11111111111111011111111111111111111: 46
  11111111111111111110111111111111111: 44
  11111111111111111111111101111111111: 42
  11111111111111111111111110111111111: 42
  11111111111111110111111111111111111: 41
  11111111111111111111111111111111101: 39
  11111111111111111111101111111111111: 38
  11111111111111111111110111111111111: 38
  11111111111111111111111111101111111: 37
  11111111111111111111111111111111110: 36
  11111111111110111111111111111111111: 35
  11111111111111111111111111111011111: 32
  11111111111111101111111111111111111: 32
  01111111111111111111111111111111111: 27
  11111111111111111011111111111111111: 23
  11111111101111111111111111111111111: 22
  11111111111111111111111111111111011: 21
  11111111011111111111111111111111111: 20
  00000000000000011111111111111111111: 18
  11111111111111111111110101111111111: 18
  00000001111111111111111111111111111: 17
  11111111001111111111111111111111111: 16
  11101111111111111111111111111111111: 16
  11111111111101111111111111111111111: 16
  00000101111111111111111111111111111: 13
  11111111111111111111111011111111111: 13
  11111111111111111111111110101111111: 13
  11111111111111111101111111111111111: 12
  10111111111111111111111111111111111: 12
  11111111111111111111111110001111111: 12
  00000000000000000011111111111111111: 11
  11111111111111111111111111111110110: 10
  00000000000000000000000001111111111: 10
  11111111111011111111111111111111111: 9
  11111111111111101011111111111111111: 9
  00000000011111111111111111111111111: 8
  10101111111111111111111111111111111: 8
  00000000000000000000000001011111111: 8
  11111111111111111111111111111111001: 8
  00000111111111111111111111111111111: 7
  11111111111111111111111111111101110: 7
  11111111110111111111111111111111111: 7
  00000000000001011111111111111111111: 6
  00000000000000001111111111111111111: 6
  00000000000000000001011111111111111: 6
  11111111111111111111111111011111111: 6
  ... (1050 more items)
3. שרטוט המחרוזות הבינאריות המובילות
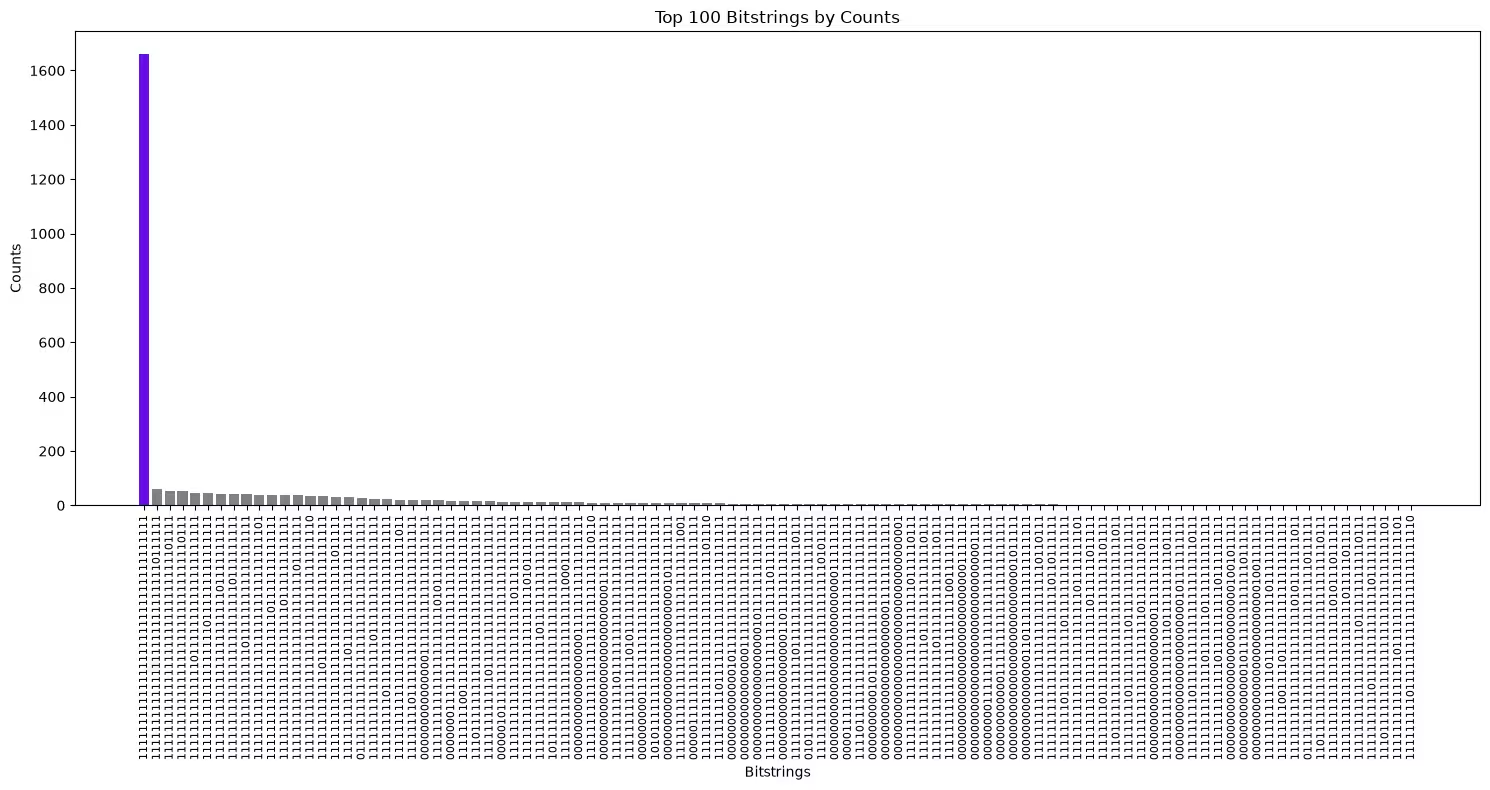
שרטטו את המחרוזת הבינארית עם הכמות הגבוהה ביותר כדי לבדוק אם המחרוזת הנסתרת היא הערך השכיח (mode).
import matplotlib.pyplot as plt

def plot_top_bitstrings(counts_dict, hidden_bitstring=None):
    # Sort and take the top 100 bitstrings
    top_100 = sorted(counts_dict.items(), key=lambda x: x[1], reverse=True)[
        :100
    ]
    if not top_100:
        print("No bitstrings found in the input dictionary.")
        return

    # Unzip the bitstrings and their counts
    bitstrings, counts = zip(*top_100)

    # Assign colors: purple if the bitstring matches hidden_bitstring,
    # otherwise gray
    colors = [
        "#680CE9" if bit == hidden_bitstring else "gray" for bit in bitstrings
    ]

    # Create the bar plot
    plt.figure(figsize=(15, 8))
    plt.bar(
        range(len(bitstrings)), counts, tick_label=bitstrings, color=colors
    )

    # Rotate the bitstrings for better readability
    plt.xticks(rotation=90, fontsize=8)
    plt.xlabel("Bitstrings")
    plt.ylabel("Counts")
    plt.title("Top 100 Bitstrings by Counts")

    # Show the plot
    plt.tight_layout()
    plt.show()
המחרוזת הנסתרת מסומנת בסגול, והיא אמורה להיות המחרוזת עם הכמות הגבוהה ביותר.
plot_top_bitstrings(counts, hidden_bitstring)
יומן שינויים
-
2026-02-20: הודעת הוצאה משימוש - שדה המטאדאטה
provider_job_idsיוצא משימוש בעוד 30 יום בגרסה 0.13.0. משתמשים יכולים לגשת למזהה ה-job דרך מתודתjob_id()של שירות ה-runtime. -
2026-02-11: עכשיו יש תמיכה ב-
ibm_miami, והוספנו מטאדאטת ביצוע ל-PubResult.
קבלת תמיכה
לכל שאלה או בעיה, צור קשר עם Q-CTRL.
השלבים הבאים
-
בקשו גישה ל-Q-CTRL Performance Management.
-
היכנסו ל-API reference של פונקציית Qiskit זו.
-
נסה את המדריך Transverse-Field Ising Model with Q-CTRL's Performance Management.
-
נסו את המדריך Quantum Phase Estimation with Q-CTRL's Qiskit Functions
-
עיינו ב-מקרה הבוחן של הבנק ה-Redacted.
-
עיינו ב-מקרה הבוחן של BlueQubit.