הפחתת שגיאות
השיעור הזה נותן רקע על טכניקות שונות להפחתת שגיאות, כדי לעזור לכם לפתח אינטואיציה לגבי איך ומתי הכי כדאי להשתמש בהן. חשוב לדעת שביישומים מודרניים של הטכניקות האלה משתמשים בכלים מתוחכמים יותר, כמו Samplomatic, Shaded Lightcones ו-Executor. את תהליכי העבודה האלה נציג בשיעורים הבאים.
הסרטון הזה נותן סקירה של טכניקות להפחתת שגיאות. הטקסט שלהלן מוסיף פרטים ובוחן את השיטות האלה בעזרת Qiskit.
סקירה של טכניקות להפחתת שגיאות
הפחתת שגיאות היא כל תהליך שמנסה לצמצם את ההשפעה של שגיאות בחישובים קוונטיים אחרי שכבר התרחשו. זה שונה מדיכוי שגיאות (suppression), שמנסה למנוע את השגיאות מראש, ומתיקון שגיאות, שמקודד מידע על פני קיוביטים פיזיים רבים ובודק את העקביות של המידע הזה כדי לשמר מידע בקיוביט לוגי יחיד. לאורך השיעור הזה, הכי נכון להבין את טכניקות הפחתת השגיאות כשיטות לבניית אומדנים טובים יותר של ערכי תוחלת אידיאליים, או דוגמים טובים יותר של התפלגויות הסתברות, ולא כשיטות לתיקון מצבים קוונטיים במהלך הביצוע. נבחן להלן את שיטות הפחתת השגיאות, שכולן זמינות ב-Qiskit ובתוספים שלו, והן כלים מבטיחים במרדף אחרי יתרון קוונטי.
הכחדת שגיאות קריאה עם twirling (TREX) מגרילה את תהליך המדידה: לפני המדידה מפעילים פעולות Pauli שנבחרות באקראי, ואחר כך מבטלים באופן קלאסי את השפעתן הידועה על מחרוזות הביטים שנצפו. תחת הנחות מתאימות על רעש המדידה, זה הופך את ערוץ שגיאת הקריאה לצורה פשוטה וסימטרית יותר, שקל יותר לכייל ולהפחית.
הפחתת שגיאות מדידה ללא מטריצה (M3) היא טכניקה ניתנת להרחבה להפחתת שגיאות מדידה, שנמנעת מבניית מטריצת ההקצאה או ההופכית שלה במפורש.
אקסטרפולציה לרעש אפס (ZNE) מקרבת את הערך שהיה לאובזרבבל בהיעדר רעש: מגדילים את הרעש באופן מלאכותי בגורם ידוע ואז עושים אקסטרפולציה חזרה למקרה של רעש אפס. לשם כך הרעש צריך לגדול בצורה צפויה. הצפיות הזאת עשויה לדרוש שיטות אחרות שנדון בהן בשיעור הזה (מתיחת פולסים, קיפול שערים והגברת שגיאות הסתברותית (PEA)).
ביטול שגיאות הסתברותי (PEC) היא מהטכניקות החזקות ביותר להפחתת שגיאות, אבל גם היקרה ביותר מבחינה חישובית. היא לומדת את התנהגות הרעש של המערכת ומנסה לבטל אותו על ידי בנייה סטטיסטית של אומדן חסר הטיה לחישוב האידיאלי. הפלט של PEC הוא אובזרבבלים מתוקנים סטטיסטית, ולא תוצאות מתוקנות שגיאות.
עכשיו נצלול לכל אחת מהשיטות האלה.
M3
שגיאות מדידה הן אחד ממקורות הרעש העיקשים ביותר, והתלויים בחומרה, במכשירים קוונטיים בטווח הקרוב. גם כשמצב קוונטי הוכן והתפתח כמו שצריך, שלב הקריאה האחרון עלול לדווח בטעות על תוצאת בסיס החישוב האמיתית. השגיאות האלה נובעות מהבחנה לא מושלמת בין המצבים הפיזיקליים שמתאימים ל- ול-, מהרפיה במהלך המדידה ומפגמים באלקטרוניקה של המדידה. כתוצאה מכך, התפלגות מחרוזות הביטים שנצפית היא לרוב גרסה מעוותת של ההתפלגות האמיתית (האידיאלית), כשהסתברות מוקצית בטעות בין תוצאות.
הפחתת שגיאות מדידה מטפלת בבעיה הזאת על ידי מידול מפורש של האופן שבו תוצאות מדידה מוקצות בטעות. בניסוח הסטנדרטי, ההתנהגות הזאת נתפסת באמצעות מטריצת הקצאה , שהאיברים שלה מייצגים את ההסתברות לתעד את התוצאה כשמצב הבסיס האמיתי היה . אם רעש המדידה קלאסי ויציב, וקטור ההסתברויות שנצפה קשור להתפלגות האידיאלית ביחס לינארי פשוט,
שימו לב שמטריצת ההקצאה היא העתקה סטוכסטית קלאסית, ולא ערוץ קוונטי. היא פועלת על קריאות קלאסיות, ולא על המצבים הקוונטיים שנדגמו כדי לקבל את הקריאות.
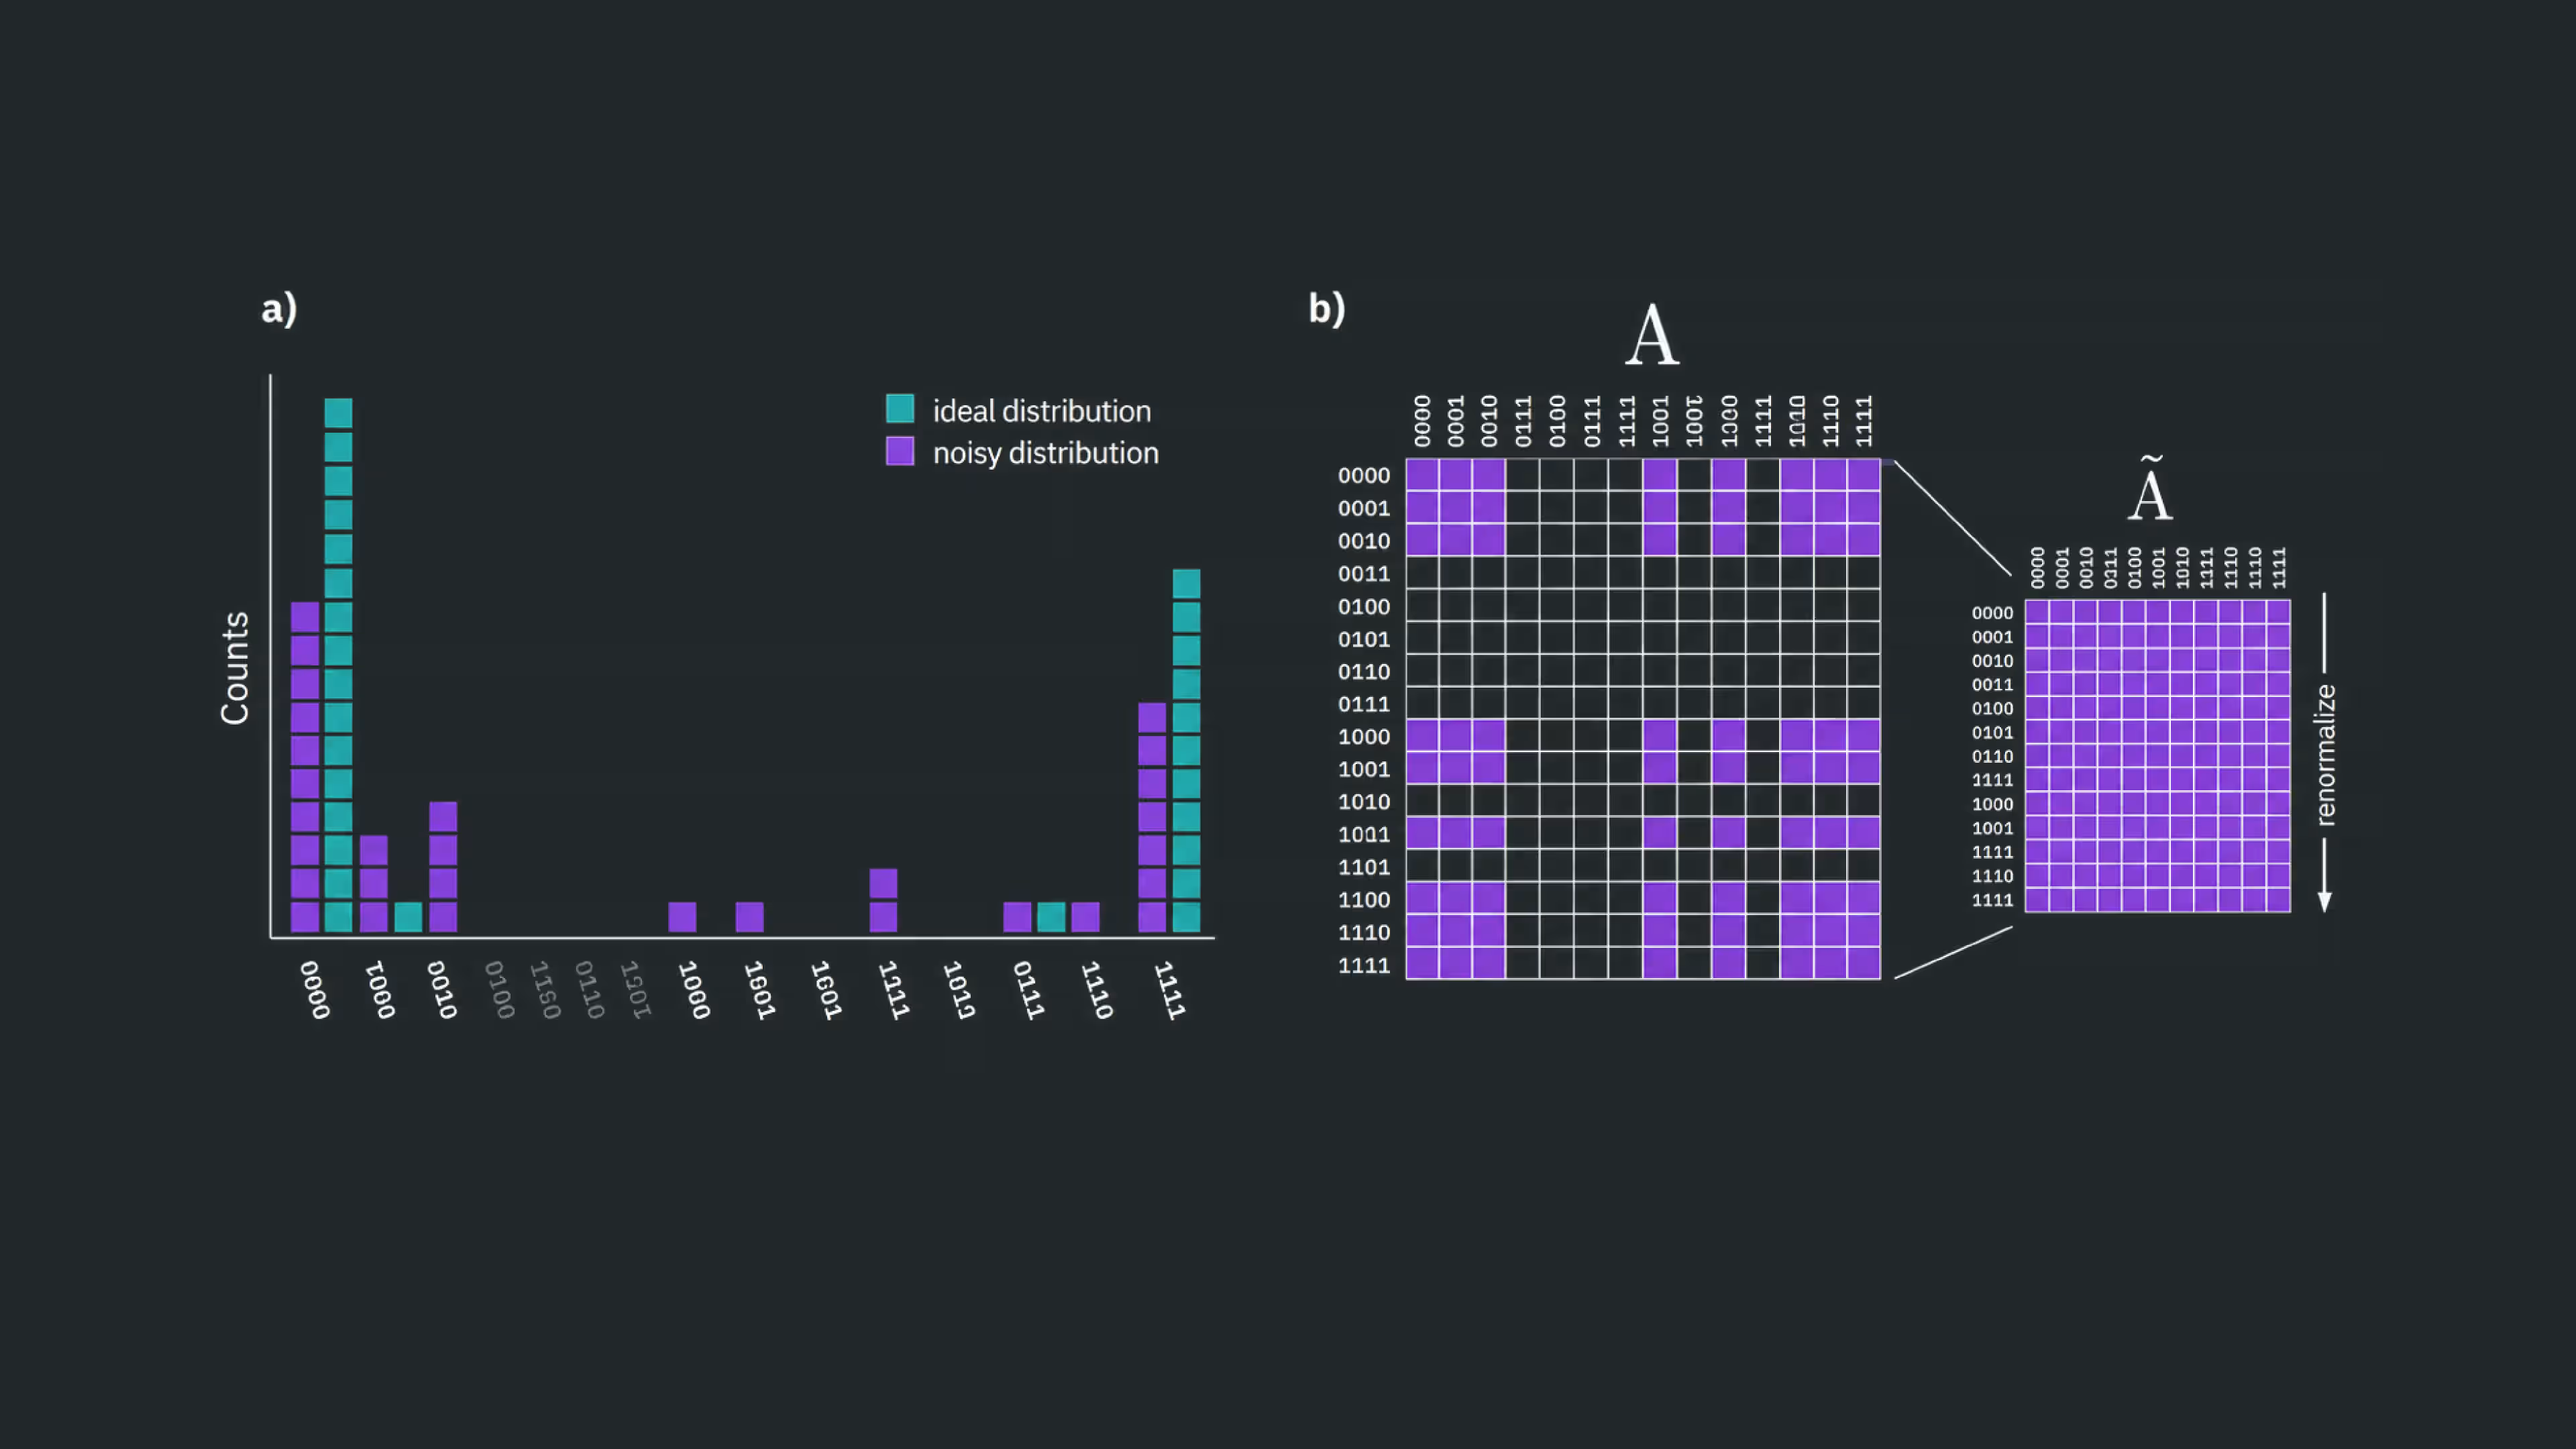
הפחתת שגיאות מדידה ללא מטריצה (M3) משתמשת במבנה הזה כדי לבנות אומדן מופחת של בלי ליצור או להפוך את המטריצה המלאה , דבר שאינו אפשרי עבור מספר גדול של קיוביטים. במקום זה, M3 מנצלת את העובדה שהרבה עומסי עבודה קוונטיים בטווח הקרוב מייצרים התפלגויות עם שיאים חדים או אנטרופיה נמוכה, ולכן ההפחתה מתמקדת רק בתת-הקבוצה של תוצאות שתורמות באופן משמעותי להתפלגות שנצפתה.
כדי לבנות את מודל ההקצאה, צריך להריץ ניסויי כיול נוספים על החומרה הקוונטית. בדרך כלל מכינים מצבי בסיס חישובי ידועים ומתעדים איך מערכת המדידה מדווחת עליהם. תקורת הכיול גדלה עם מספר הקיוביטים הנמדדים, ואילו העלות החישובית של ההפחתה תלויה במבנה ההתפלגות שנצפתה. העלות הזאת קטנה בהרבה ממה שנדרש כדי לאפיין במפורש את מטריצת ההקצאה המלאה בגודל . התקורה של הכיול אמיתית, אבל היא קלה בהשוואה לטכניקות ברמת המעגל כמו אקסטרפולציה לרעש אפס או ביטול שגיאות הסתברותי, ולכן M3 היא כלי מעשי ונפוץ להפחתת שגיאות קריאה בניסויים קוונטיים בטווח הקרוב.
שימו לב שהכיול שימושי רק במידה שתהליך המדידה נשאר יציב מספיק בין ריצות הכיול לבין הניסוי עצמו.
נתחיל בביצוע מקרה פשוט ידנית כדי להמחיש איך זה עובד, ואחר כך נשתמש בכלים המובנים ב-Qiskit כדי להראות שימוש ב-M3 בקנה מידה ריאליסטי יותר.
דוגמה קטנה ל-M3
נתחיל בבניית מצב Bell פשוט.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"matplotlib": "matplotlib", "mthree": "mthree", "numpy": "numpy", "qiskit": "qiskit", "qiskit_aer": "qiskit-aer", "qiskit_ibm_runtime": "qiskit-ibm-runtime"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
from qiskit import QuantumCircuit
import numpy as np

qc = QuantumCircuit(2, 2)
qc.h(0)
qc.cx(0, 1)
qc.measure([0, 1], [0, 1])
<qiskit.circuit.instructionset.InstructionSet at 0x714a5fa4d630>
אפשר להשתמש בסימולטור עם מודל רעש כי אנחנו מגבילים את הדוגמה הזאת למעגל קטן מאוד. אנחנו מגדירים במפורש את מודל הרעש שלנו עם שגיאת קריאה מהצורה:
if true=0: [95% chance of reading 0, 5% chance of reading 1]
if true=1: [8% chance of reading 0, 92% chance of reading 1]
שיעורי שגיאות הקריאה האלה גבוהים בהרבה ממה שרואים במחשבים קוונטיים אמיתיים של IBM®. בחרנו בערכים הגבוהים מסיבות פדגוגיות, כדי שנוכל לראות בבירור את ההשפעה של M3.
from qiskit_aer import AerSimulator
from qiskit_aer.noise import NoiseModel, ReadoutError

ro_error = ReadoutError([[0.95, 0.05], [0.08, 0.92]])

noise_model = NoiseModel()
noise_model.add_readout_error(ro_error, [0])
noise_model.add_readout_error(ro_error, [1])

backend_noisy = AerSimulator(noise_model=noise_model)
אפשר להריץ את המעגל על הסימולטור הרועש כדי לראות את ההשפעות של שגיאת הקריאה.
result = backend_noisy.run(qc, shots=5000, seed_simulator=123).result()
raw_counts = result.get_counts()
raw_counts
{'01': 290, '11': 2165, '10': 304, '00': 2241}
בדוגמת הצעצוע שלנו הגדרנו את שגיאת הקריאה של מודל הרעש. אבל כשמשתמשים במחשב קוונטי אמיתי, שגיאת הקריאה אינה ידועה מראש. צריך להעריך אותה בניסוי. לשם כך יוצרים מעגלים שמכינים קיוביט במצב בסיס חישובי ידוע, או , ומודדים אותו. בהיעדר שגיאת קריאה היינו מודדים בדיוק את המצב שהוכן. על ידי איסוף סטטיסטיקה מהמדידות האלה אפשר לבנות מטריצת הקצאה שמתארת את שגיאת הקריאה. בדוגמת הצעצוע הזאת היא אמורה להיראות דומה לזאת שהגדרנו.
במערכת ריאליסטית יותר, צריך לצבור סטטיסטיקה עבור כל קיוביט פיזי. זה לפעמים לא פשוט, כי הטרנספילציה ממפה מעגל מופשט לחומרה ומספר הקיוביט משתנה. נחזור לזה בדוגמה הבאה. בדוגמת הסימולטור הזאת הקצינו אותו מודל שגיאות קריאה לכל הקיוביטים, ולכן אפיון אחד מספיק.
# Define a function to make a state and measure it.
def measure_state(state):
    qc = QuantumCircuit(1, 1)
    if state == 1:
        qc.x(0)
    qc.measure(0, 0)
    return backend_noisy.run(qc, shots=5000, seed_simulator=123).result().get_counts()
# Use the function to get statistics on readout errors
cal_counts_0 = measure_state(0)  # True state = 0
cal_counts_1 = measure_state(1)  # True state = 1

cal_counts_0, cal_counts_1
({'1': 244, '0': 4756}, {'0': 420, '1': 4580})
# Create the normalized readout error matrix

# def normalize(d):
#    s = sum(d.values())
#    return {k: v/s for k,v in d.items()}
# p0 = normalize(cal_counts_0)
# p1 = normalize(cal_counts_1)

p0 = {k: v / sum(cal_counts_0.values()) for k, v in cal_counts_0.items()}
p1 = {k: v / sum(cal_counts_1.values()) for k, v in cal_counts_1.items()}

A_1q = np.array(
    [
        [p0["0"], p1["0"]],  # row: measured 0, columns true 0/1
        [p0["1"], p1["1"]],
    ]
)
A_1q
array([[0.9512, 0.084 ],
       [0.0488, 0.916 ]])
שימו לב שזה קרוב מאוד למטריצת שגיאות הקריאה ששימשה לבניית הסימולטור.
שוב, במחשב קוונטי אמיתי היו לנו סטטיסטיקות כאלה עבור כמה קיוביטים פיזיים. עבור הסימולטור הזה אנחנו מניחים ששני הקיוביטים סובלים משגיאות קריאה זהות ובלתי תלויות, ולכן אפשר לבנות את מטריצת ההקצאה של שני קיוביטים A_2q כמכפלה טנזורית של המטריצות המתאימות של קיוביט אחד. שימו לב גם שהמטרה של M3 היא לא לבנות את מטריצת ההקצאה כולה. במקום זה, M3 מתמקדת בתת-הקבוצה של תוצאות שתורמות באופן משמעותי להתפלגות שנצפתה. את המטריצה כולה נבנה רק בדוגמה הקטנה שלנו כדי לראות איך זה עובד. המימוש של M3 ב-qiskit-ibm-runtime מתוחכם יותר מדוגמת הצעצוע הזאת, כי עליו להתמודד עם הרבה קיוביטים בעלי מאפייני קריאה שונים ועדיין להימנע מבניית מטריצת ההקצאה המלאה.
A_2q = np.kron(A_1q, A_1q)
print(A_2q)
[[0.89794576 0.07107    0.07107    0.005625  ]
 [0.04965424 0.87653    0.00393    0.069375  ]
 [0.04965424 0.00393    0.87653    0.069375  ]
 [0.00274576 0.04847    0.04847    0.855625  ]]
בדוגמה הזאת אנחנו מניחים ששגיאות הקריאה בקיוביטים שונים בלתי תלויות, ולכן אפשר לבנות את מטריצת ההקצאה של שני קיוביטים כמכפלה טנזורית של המטריצות המתאימות של קיוביט אחד.
נשיג את התוצאות הגולמיות והמופחתות להשוואה.
bitstrings = ["00", "01", "10", "11"]
# Normalize raw counts
raw_probs = np.array([raw_counts.get(b, 0) for b in bitstrings], dtype=float)
raw_probs /= raw_probs.sum()
raw_probs
array([0.4482, 0.0592, 0.0598, 0.4328])
בשלב הזה אפיינו בניסוי איך תהליך המדידה מעוות את ההסתברויות של התוצאות האידיאליות. המטרה שלנו עכשיו היא לבטל את העיוות הזה ולהחיל את התיקון שהתקבל על ההסתברויות הגולמיות.
מכיוון שאנחנו מבצעים היפוך לינארי ולא תיקון פיזיקלי, ה"הסתברויות" שמתקבלות לא תמיד חייבות להיות חיוביות. הסתברויות-מעין שליליות קטנות מאוד הן צפויות ומשקפות את העובדה שהפחתת שגיאות מדידה מפיקה אומדן ולא התפלגות הסתברות פיזיקלית.
# Explicit inversion is feasible only for very small systems
# This is why M3 avoids creating the entire A matrix.

A_inv = np.linalg.inv(A_2q)

# Note: mitigated_probs might contain negative values.
# This is expected and reflects estimator, not physical, probabilities.

mitigated_probs = A_inv @ raw_probs
print(mitigated_probs)
[ 4.96000451e-01 -4.69852308e-04 2.17747967e-04 5.04251654e-01]
נמיר את אלה לספירות לצורך ציור.
shots = sum(raw_counts.values())  # e.g., 5000
ideal_probs = [0.50, 0.00, 0.00, 0.50]  # ideal Bell distribution
# Convert probabilities to integer counts for plotting only.
# Not physically meaningful when probabilities are negative

def probs_to_counts(bitstrings, probs, shots):
    """
    Convert a probability vector into a Qiskit-style counts dictionary.
    Ensures integer shot counts and correct normalization.
    """
    counts = {}
    # First convert to raw integer counts
    int_counts = [round(p * shots) for p in probs]
    # Fix rounding error by adjusting the last entry
    diff = shots - sum(int_counts)
    int_counts[-1] += diff
    # Build dict
    for b, c in zip(bitstrings, int_counts):
        if c > 0:
            counts[b] = c
    return counts

mitigated_counts = probs_to_counts(bitstrings, mitigated_probs, shots)
ideal_counts = probs_to_counts(bitstrings, ideal_probs, shots)
לבסוף נסתכל על ההתפלגויות הגולמית, המופחתת והאידיאלית. ה"ספירות" המופחתות שלהלן הן רק עזר להמחשה, שמתקבל מסקיילינג מחדש של הסתברויות-המעין המופחתות.
from qiskit.visualization import plot_histogram

plot_histogram(
    [raw_counts, mitigated_counts, ideal_counts],
    legend=["Raw", "Mitigated", "Ideal"],
    sort="asc",
    title="Raw vs Mitigated vs Ideal",
)
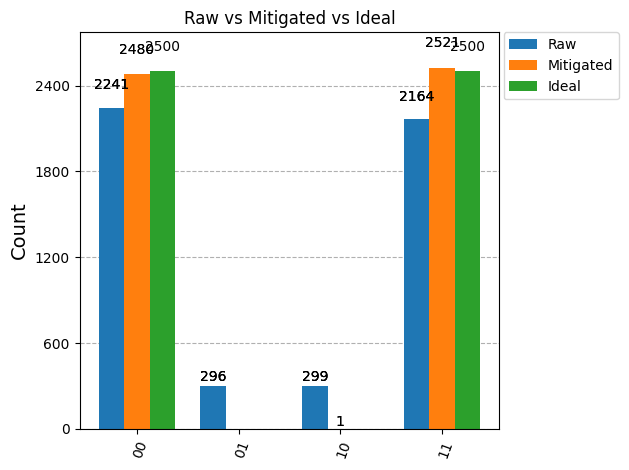
ברור שהתוצאות המופחתות של M3 קרובות הרבה יותר להתפלגויות האידיאליות, ואפשר לראות למה.
החלת M3 על תהליכי עבודה ריאליסטיים יותר מורכבת בהרבה. שימו לב:
- מחשבים קוונטיים אמיתיים מכילים הרבה קיוביטים פיזיים, ולכל אחד מהם מאפייני שגיאת קריאה משלו. צריך למדל את השגיאות האלה ולשלב אותן בצורה מתאימה.
- מטריצת ההקצאה המלאה גדלה אקספוננציאלית עם מספר הקיוביטים, ובמהירות הופכת לבלתי מעשית לבנייה מפורשת. בגלל זה M3 מתמקדת בתת-הקבוצה של תוצאות שתורמות באופן משמעותי להתפלגות שנצפתה, במקום לבנות את כל מטריצת ההקצאה.
- בבעיות אמיתיות שמעניינות אותנו, ייתכן שההתפלגות האידיאלית אינה ידועה.
מכל הסיבות האלה, תהליך ההפחתה המלא עטוף בתוסף ה-Qiskit בשם mthree.
דוגמה גדולה יותר ל-M3
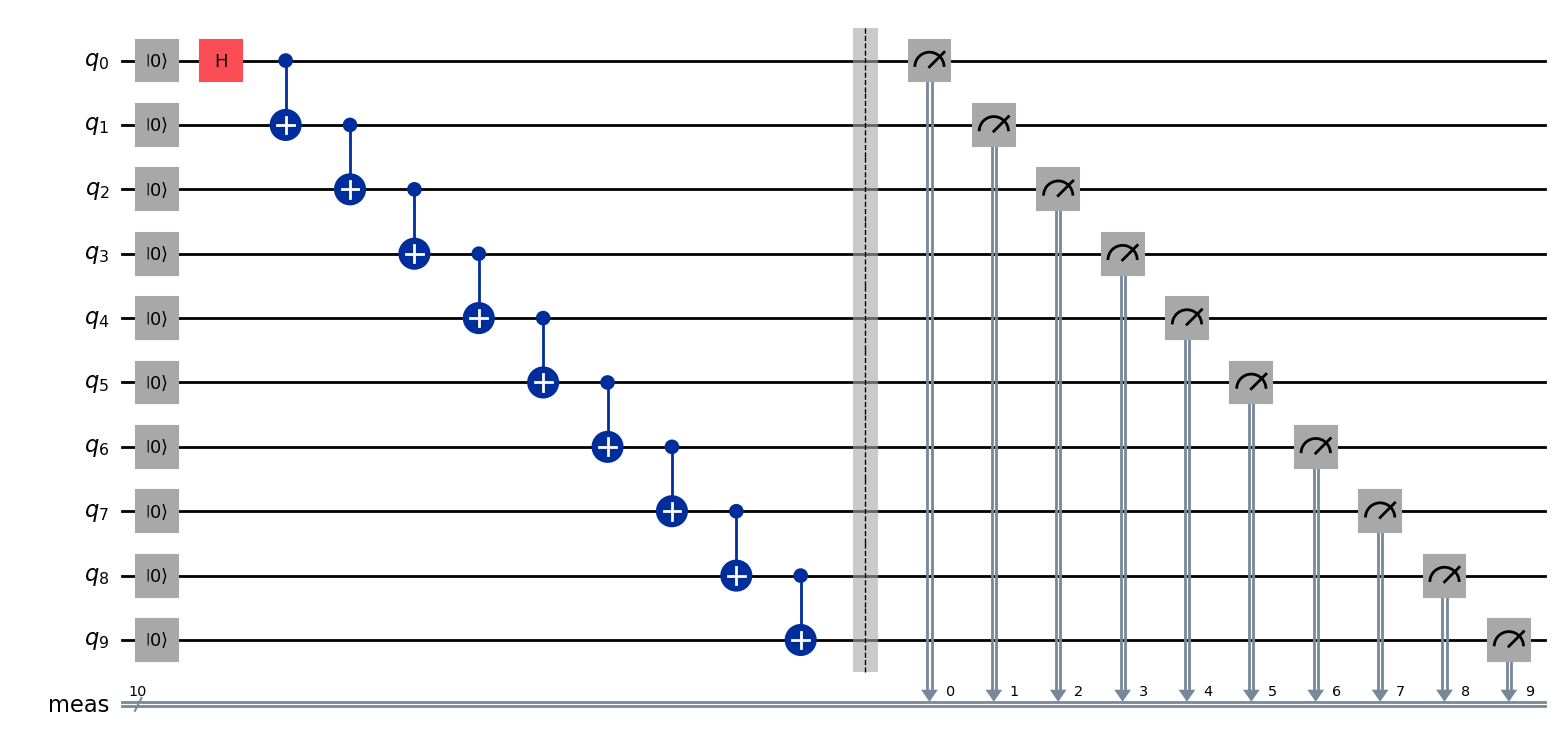
עכשיו נחיל את M3 על מעגל גדול יותר, כזה שקביעת תת-המרחב הרלוונטי של בו ידנית הייתה מסורבלת, אבל הוא עדיין פשוט מספיק כדי שנדע מהי ההתפלגות האידיאלית: מצב GHZ. נתחיל בייבוא החבילה mthree ובהגדרת מעגל קוונטי של GHZ.
import numpy as np
from qiskit import QuantumCircuit

# from qiskit_ibm_runtime.fake_provider import FakeCasablancaV2
import mthree

num_qubits = 10

qc = QuantumCircuit(num_qubits)
qc.reset(range(num_qubits))
qc.h(0)
for i in range(num_qubits - 1):
    qc.cx(i, i + 1)
qc.measure_all()
qc.draw("mpl")
כדי להריץ את זה על מחשב קוונטי אמיתי, נייבא את qiskit_ibm_runtime וחבילות נוספות שנדרשות. נשתמש ב-SamplerV2 כדי לקבל התפלגות של פלטים.
# Import packages needed for using real quantum computers

from qiskit_ibm_runtime import QiskitRuntimeService
from qiskit_ibm_runtime.executor_sampler import SamplerV2 as Sampler
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

# --------- Configuration ----------
service = QiskitRuntimeService(channel="ibm_quantum_platform", instance="your crn here")

# backend_real = service.backend("ibm_fez")     # adjust if needed
backend_real = service.least_busy(simulator=False, operational=True)
עכשיו נבצע טרנספילציה של המעגל ל-Backend שלנו. אנחנו קובעים כאן את רמת האופטימיזציה ל-0 כדי להתמקד בהשפעות של M3 בלי להוסיף כלים נוספים. זה אומר שה-fidelity הסופי לא ייצג את מה שאפשר להשיג על חומרה של IBM Quantum® עם מלוא סט הכלים הזמינים, אבל זה מאפשר לנו להתמקד דווקא בתועלת של M3.
# Exclude any optimization to focus only on M3 effects
opt_level = 0
pm = generate_preset_pass_manager(optimization_level=opt_level, backend=backend_real)
qc_isa = pm.run(qc)
עכשיו נגדיר את ה-Sampler, ושוב נכבה טכניקות נוספות לדיכוי שגיאות כמו dynamical decoupling ו-twirling.
shots = 8192

# No twirling
sampler_no_twirl = Sampler(mode=backend_real)
sampler_no_twirl.options.twirling.enable_gates = False
sampler_no_twirl.options.twirling.enable_measure = False
sampler_no_twirl.options.default_shots = shots
sampler_no_twirl.options.dynamical_decoupling.enable = False
לבסוף נריץ את ה-job שלנו.
# This job took 7 seconds on ibm_fez. Your actual execution time can vary.
job = sampler_no_twirl.run([qc_isa])
res_real = job.result()
job_id = job.job_id()
print("job number for real  ", job_id)
job number for real d7ark4e5nvhs73a2fu6g
אפשר לחלץ את הספירות הגולמיות מהמעגל שלמעלה.
counts_real = []
for i in range(len(res_real)):
    counts_real.append(res_real[i].data.meas.get_counts())
עכשיו נריץ את mthree על ה-Backend שלנו כדי לאפיין את מודל ההקצאה שמשמש להפחתת שגיאות מדידה. נבצע סקיילינג מחדש של ההתפלגות הגולמית בעזרת המידע הזה. שימו לב שלפעמים זה עלול להניב הסתברויות שליליות קטנות מאוד (ומכאן המונח הסתברויות-מעין).
# Added 6 sec on ibm_fez, on top of original 7 sec to run circuits. Your time might differ.
mit_real = mthree.M3Mitigation(backend_real)
mappings_real = mthree.utils.final_measurement_mapping(qc_isa)
mit_real.cals_from_system(mappings_real)
quasis_real = mit_real.apply_correction(counts_real, mappings_real)
התיקון של mthree מפיק הסתברויות-מעין, ולא ספירות. אפשר לבצע סקיילינג מחדש לספירות ידנית. פונקציית העזר שלהלן ממירה לספירות ומעגלת לערכים שלמים. בנוסף, במעגלים גדולים יהיו הרבה מחרוזות שגויות עם מעט מאוד ספירות, שמלכלכות את ההיסטוגרמה. פונקציית העזר השנייה שלהלן מסירה כל מחרוזת עם פחות ספירות מסף שנבחר, כדי לתת לנו מבט ברור על האיברים הדומיננטיים בהתפלגות.
def quasidistribution_to_counts(quasi_list, shots):
    return [
        {bitstr: int(round(float(prob) * shots)) for bitstr, prob in quasi.items()}
        for quasi in quasi_list
    ]

def filter_counts_by_threshold(counts_list, t):
    filtered = []

    for counts in counts_list:
        new_counts = {}
        for bitstr, val in counts.items():
            c = int(round(float(val)))  # FORCE conversion
            if abs(c) >= t:
                new_counts[bitstr] = c
        filtered.append(new_counts)

    return filtered
quasi_counts = quasidistribution_to_counts(quasis_real, shots)
trim_threshold = 30
trimmed_quasi = filter_counts_by_threshold(quasi_counts, trim_threshold)
trimmed_raw = filter_counts_by_threshold(counts_real, trim_threshold)
אפשר גם ליצור בקלות את ההתפלגות התיאורטית האידיאלית, שבה להסתברות של מצב האפסים ושל מצב האחדים יש ערך שווה, ולכל שאר התוצאות הסתברות אפס, לצורך השוואה.
ideal = [
    {
        "0" * num_qubits: int(round(float(shots) / 2)),
        "1" * num_qubits: int(round(float(shots) / 2)),
    }
]
לבסוף אפשר להציג את התוצאות שלנו בתרשים.
from qiskit.visualization import plot_histogram

plot_histogram(
    [trimmed_raw[0], trimmed_quasi[0], ideal[0]],
    legend=["Raw", "Mitigated", "Ideal"],
    sort="asc",
    title="Raw vs Mitigated vs Ideal",
)
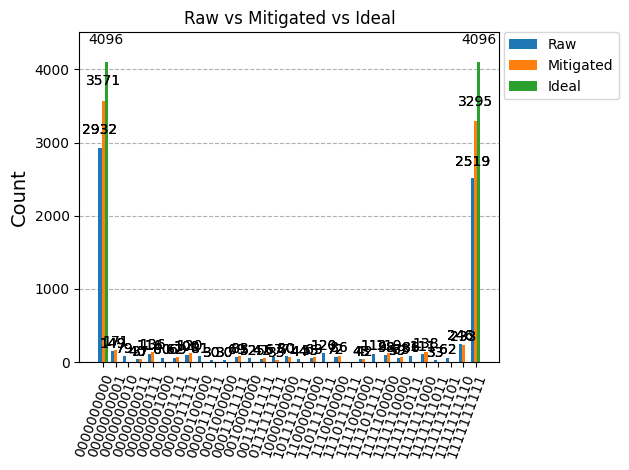
התוצאות המופחתות קרובות להתפלגות האידיאלית יותר מהתוצאות הלא מופחתות. אפשר לכמת את זה טוב יותר בעזרת הספירות של מחרוזות הביטים האידיאליות.
def extract_all_zero_and_all_one(counts):
    """
    Extract counts for the all-0 and all-1 bitstrings.

    Parameters
    ----------
    counts : dict[str, int]
        Counts dictionary.

    Returns
    -------
    dict[str, int]
        Dictionary containing only 00...0 and 11...1 entries if present.
    """
    n = len(next(iter(counts)))  # infer bitstring length
    zero_state = "0" * n
    one_state = "1" * n

    return {k: counts[k] for k in (zero_state, one_state) if k in counts}

correct_counts_raw = extract_all_zero_and_all_one(trimmed_raw[0])
correct_counts_mitigated = extract_all_zero_and_all_one(trimmed_quasi[0])
keys = ["0" * num_qubits, "1" * num_qubits]
fidelity_raw = (
    correct_counts_raw.get(keys[0]) + correct_counts_raw.get(keys[1])
) / shots
fidelity_mit = (
    correct_counts_mitigated.get(keys[0]) + correct_counts_mitigated.get(keys[1])
) / shots
print("Percent correct raw counts: ", fidelity_raw)
print("Percent correct mitigated counts: ", fidelity_mit)
Percent correct raw counts:  0.6654052734375
Percent correct mitigated counts:  0.838134765625
הכלי הפשוט הזה שיפר את ה-fidelity שלנו ב-26% ביחס ל-fidelity הלא מופחת, בתקורה נמוכה יחסית. ברור ש-M3 יכולה להיות מאוד שימושית. אבל מעגל ה-GHZ נבחר כמקרה שימוש טוב, כי יש לו שיאים חדים בשני מצבי פלט. בבעיות מסוימות הספירות מתפזרות באופן אחיד יותר (מצבים עם אנטרופיה גבוהה). במעגלים עמוקים מאוד עם הרבה קיוביטים, שגיאות שערים ורעש שאינו קשור לשגיאות מדידה יביאו לרוב למצב עם אנטרופיה גבוהה. במקרים כאלה M3 פועלת על מרחב מצבים גדול למדי. יש שלוש גישות אפשריות לכך:
(1) לקבל שזו מגבלה של M3.
(2) שימו לב שהחסם העליון על המרחב של המטריצה ש-M3 בונה הוא num_shots num_shots, ולא , כשהראשון קטן בהרבה עבור מספר גדול של קיוביטים .
(3) רק בזהירות רבה, להסיר מחרוזות ביטים בעלות הסתברות נמוכה מאוד מהספירות הגולמיות שמוזנות ל-M3. זה עלול להכניס הטיה, וצמצום התומך של המצבים שלכם עלול להפריע להתכנסות בגישות כמו שיטת Krylov. כדאי לעשות את זה רק כשאתם יודעים בדיוק למה אתם עושים את זה ויכולים לצפות את כל ההשפעות שלו. זו הסיבה שגזימה כזאת אינה תכונה מובנית של M3.
למידע נוסף על תוסף ה-Qiskit בשם mthree, אפשר לראות דוגמאות, הוראות התקנה, רקע והפניות ל-API בתיעוד שלו.
הכחדת שגיאות קריאה עם twirling (TREX)
הכחדת שגיאות קריאה עם twirling (TREX) היא טכניקה להפחתת שגיאות מדידה שמשמשת במחשבים קוונטיים מודרניים. המטרה שלה היא להסיר הטיה שנגרמת משגיאות קריאה קלאסיות, בלי לדרוש אפיון מלא או היפוך של מטריצת הקצאת המדידה.
TREX אינה תיקון שגיאות ואינה משפרת את ה-fidelity של המצב. במקום זה היא מבטיחה שאומדני ערכי התוחלת חסרי הטיה ביחס לרעש הקריאה, עד כדי שגיאה סטטיסטית, באמצעות ממוצע על בסיסי מדידה אקראיים וסקיילינג מחדש. בחומרה של IBM Quantum, TREX היא שיטת ההפחתה ברירת המחדל להערכת ערכי תוחלת, והיא מתאימה ל-resilience_level = 1 בפרימיטיב Estimator של IBM Quantum.
טבעם של שגיאות קריאה בחומרה מוליכת-על
בקיוביטים מוליכי-על של IBM, שגיאות הקריאה נשלטות על ידי:
-
הסתברויות היפוך ביט א-סימטריות (למשל, בתדירות גבוהה יותר מהכיוון ההפוך)
-
הרפיה התלויה במצב במהלך המדידה עצמה
-
crosstalk מתון אך לא זניח בין מהודים של קריאה סמוכים
חשוב לציין שאפשר לרוב למדל את השגיאות האלה כתהליך סטוכסטי קלאסי שפועל על תוצאות המדידה. TREX מנצלת רעיון סטנדרטי מהתאמת רעש: הגרלה (twirling) של הליך המדידה. TREX מתקדמת בדרך כלל בשני שלבים:
-
twirling ו"ביטול twirling" קלאסי
-
סקיילינג מחדש של ערכי תוחלת בעזרת מעגלי כיול
נניח שערך תוחלת של אובזרבבל קשור לאומדנים רועשים כך:
כאשר הוא גורם קבוע שמשנה את קנה המידה של האומדן ו- הוא הטיה מהמקורות שתוארו למעלה. אנחנו משתמשים כאן ב- כתזכורת לכך שאנחנו מטפלים כאן רק בשגיאת קריאה; עדיין יש שגיאות שערים שצריך לשקול.
ממש לפני המדידה, כל קיוביט עובר צמידה אקראית באופרטור Pauli (כמו I או X). תוצאות המדידה עוברות ביטול twirling קלאסי לאחר מכן.
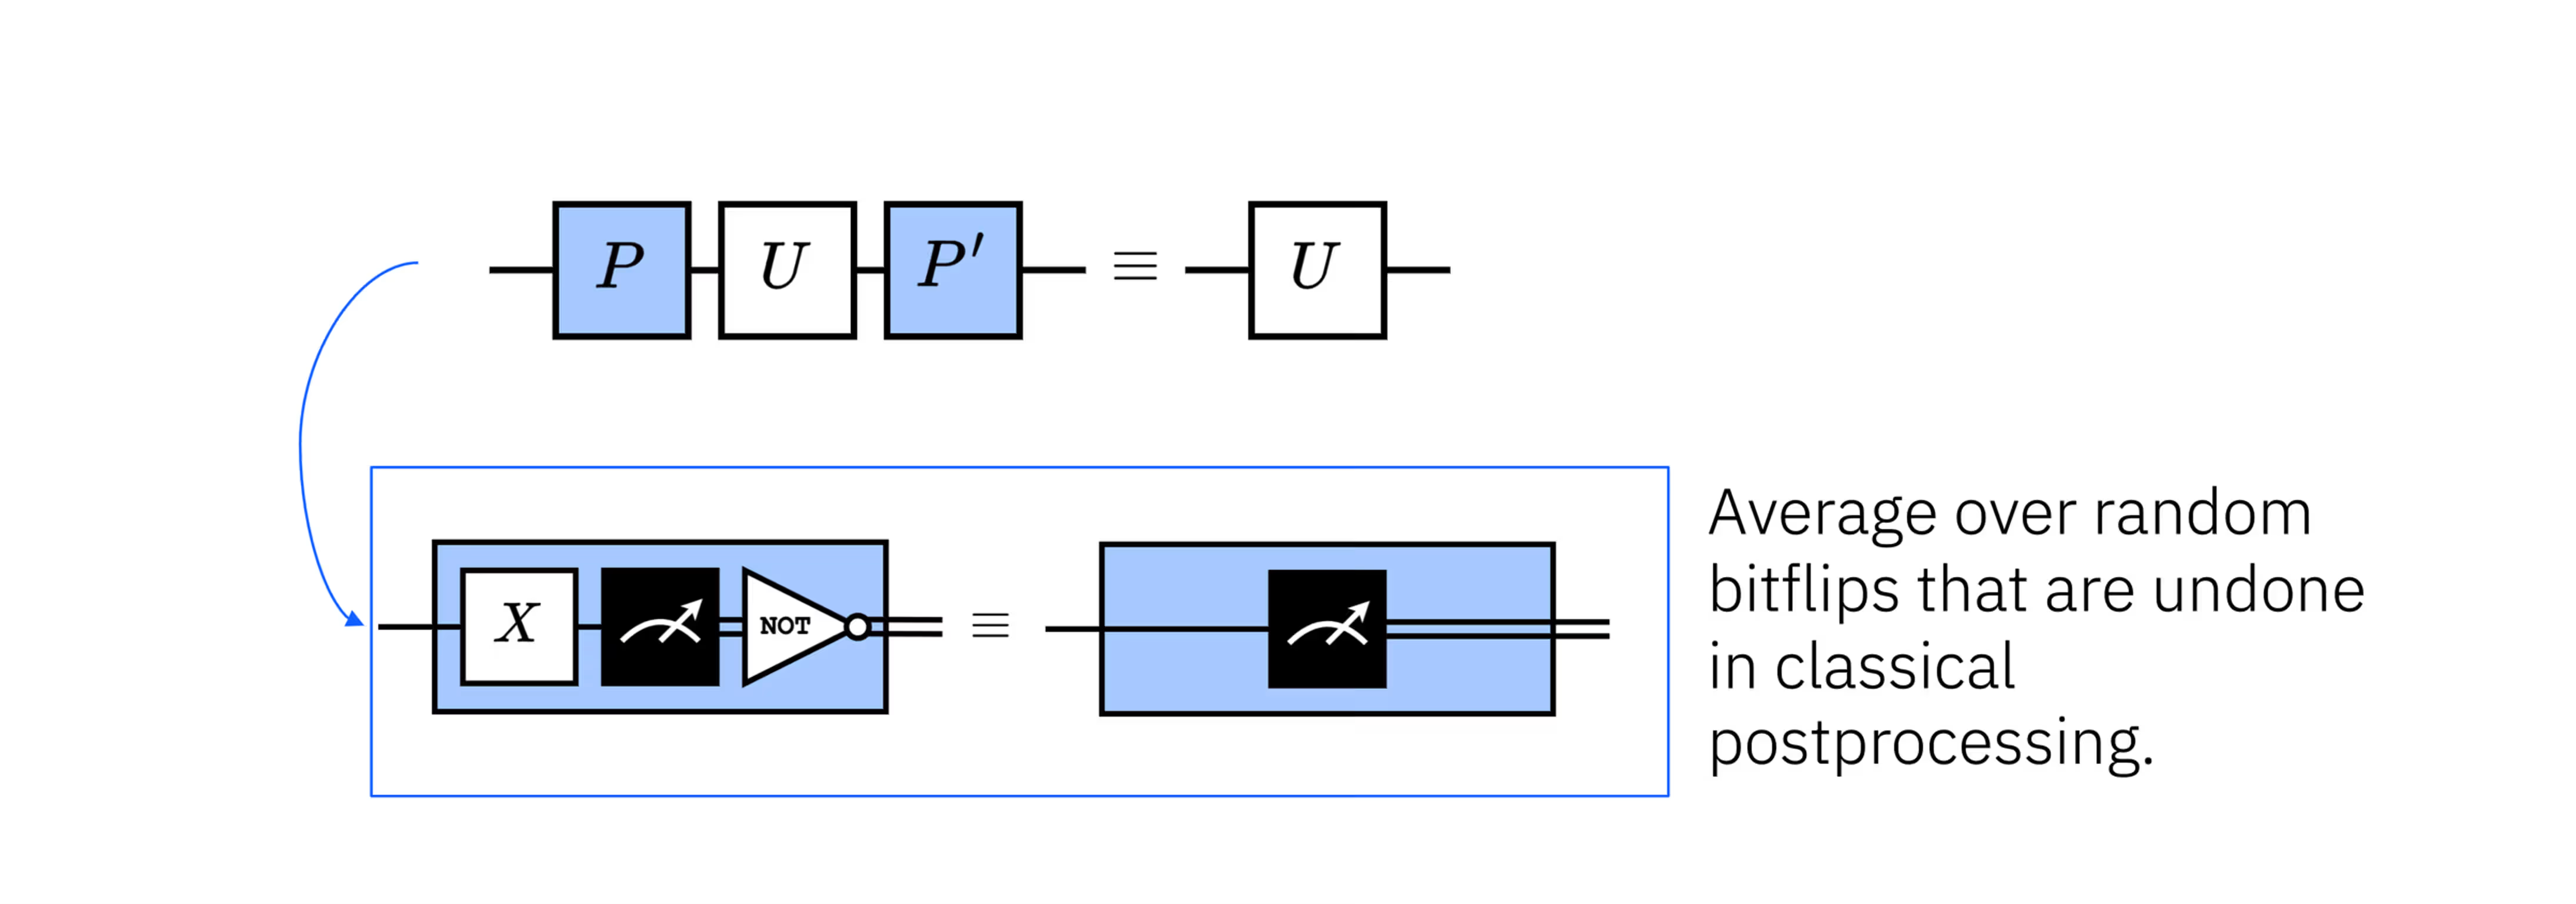
ממוצע על ההגרלות האלה מסדר את ערוץ הקריאה באופן סימטרי. כתוצאה מכך, א-סימטריות שיטתיות בתהליך הקריאה הופכות לערוץ שגיאה סימטרי יותר, שאת ההשפעה שנשארה ממנו אפשר לטפל באמצעות כיול וסקיילינג מחדש. במילים פשוטות, אם למשל הייתה הטיה לכיוון המצב , היינו מפספסים חלק מהמדידות של . על ידי twirling סביב המדידה, אנחנו מחליפים באופן אקראי איזו תוצאה לוגית משויכת לתהליך הקריאה הפיזי, ואז מבטלים את ההחלפה הזאת באופן קלאסי אחר כך. ממוצע על הרבה מדידות אקראיות כאלה מסיר את ההעדפה השיטתית של תוצאה מדווחת אחת על פני השנייה. זה מסיר את הטיית המדידה הדומיננטית תחת ההנחות של מודל TREX, כך שמתקבל:
עם זאת, ייתכן שעדיין צריך לבצע סקיילינג מחדש של ערכי התוחלת. השלב השני הוא שימוש במעגלי כיול (מעגלים עם תוצאות ידועות) כדי להעריך את גורם הסקיילינג . אפשר אז להשתמש בו כדי לקבל אומדן משופר מאוד.
ערכי התוחלת של אובזרבבלי Pauli הופכים לאומדנים חסרי הטיה של ערכיהם האידיאליים. לא לומדים או הופכים שום מודל רעש מפורש, ולכן TREX יציבה מבחינה נומרית וזולה. שוב, שגיאות שערים לא טופלו כאן.
בהערכת ערך תוחלת של אובזרבבל , עשויה להיות שונות בגלל דגימה סופית, עשויים להיות סוגים רבים של שגיאות לא קוהרנטיות וקוהרנטיות, ועשויה להיות גם הטיה, , בגלל שגיאת קריאה. ההטיה הזאת נובעת ממקורות כמו המעברים הא-סימטריים שדנו בהם. בפועל, אפשר בדרך כלל למדל היטב את ההטיה הזאת כערוץ סטוכסטי קלאסי שפועל אחרי ההתפתחות הקוונטית. TREX משנה את ערוץ המדידה האפקטיבי כך שהאומדן של חסר הטיה ביחס לשגיאת קריאה. קל יחסית לראות את זה בעזרת הדוגמה הפשוטה ביותר של שערי twirling: X. אם יש א-סימטריה בין לבין , אבל אנחנו מחליפים באקראי איזה מצב נקרא (והופכים בחזרה אחר כך, באופן קלאסי), אז ברור שזה מסיר את הא-סימטריה השיטתית (אם כי דגימה סופית עדיין אומרת שייתכן שתישאר א-סימטריה סטוכסטית קלה במדידה). בפועל, שערי twirling עבור TREX אינם מוגבלים ל-I ול-X, אבל זה מספיק להסבר.
TREX מאפשרת לנו לקבל אומדן של ערך תוחלת שנקי מהטיה בגלל שגיאת קריאה. עדיין עשויה להיות הטיה ממקור אחר (כמו סיבוב יתר קוהרנטי); TREX מטפלת רק בקריאה. מכיוון ש-TREX מחליפה הטיה שיטתית בסימטריזציה אקראית, היא בדרך כלל ממירה הטיה לשונות סטוכסטית נוספת, ובכך מגדילה את השונות של האומדן בעלות דגימה קבועה.
בדקו את ההבנה שלכם
נניח שאנחנו משתמשים ב-estimator על מעגל שהכין את המצב בהערכת . נניח עוד ששגיאות מדידה גורמות לכך שתוצאות שמתאימות ל- מדווחות כ- ב-10% מהמקרים, בעוד שתוצאות שמתאימות ל- מדווחות כ- רק ב-1% מהמקרים. האי-סימטריה בין שגיאות הדיווח האלה מכניסה הטיית מדידה.
(א) בהיעדר שגיאות מדידה כאלה, מהו ערך התוחלת האידיאלי של האובזרבבל ?
(ב) עם שגיאות המדידה או הקריאה הא-סימטריות, מהו ערך התוחלת של האובזרבבל ?
(ג) נבחן קבוצה מוגבלת של שערי twirling של Pauli: I ו-X. נניח ש-I ו-X מופעלים באקראי בהסתברות של 50% בכמה shots. שיעורי שגיאות המדידה זהים לקודם. לאחר מכן שער ה-Pauli (I או X) מבוטל באופן קלאסי. בנו טבלה של כל התוצאות האפשריות וההסתברויות שלהן, בהתחשב בסופרפוזיציה ההתחלתית, בשגיאות המדידה הא-סימטריות ובשערי ה-Pauli שהוקצו באקראי.
(ד) השתמשו בטבלה כדי לקבוע את ערך התוחלת בעזרת אסטרטגיית ה-twirling.
(ה) השוו בין ערכי התוחלת: האידיאלי, בלי twirling ועם twirling.
(ו) מה הושמט מהטיפול הזה ומופיע ביישום מלא של TREX?
תשובה
(א) אפשר פשוט להשתמש באינטואיציה ובסימטריה ולומר ש-. כדי להראות זאת במפורש:
(ב) המצב יכול לקרוס ל- או ל- בעת המדידה, כל אחד בסיכוי של 50%. אבל מתוך ה-50% שקורסים למצב , 1% מהם (או 0.5% מכל המקרים) ידווחו בטעות כ-. מתוך ה-50% שקורסים ל-, 10% (או 5% מכל המקרים) ידווחו בטעות כ-. זה משאיר אותנו עם:
- 54.5%
- 45.5% אם נתעלם מכל סוגי השגיאות האפשריים האחרים, נקבל אומדן של
(c)
| Pauli | תוצאת מדידה אידיאלית | תוצאה אחרי Pauli | שגיאת קריאה | ביטול Pauli | התוצאה הסופית שדווחה | הסתברות |
|---|---|---|---|---|---|---|
| I | 0 | 0 | אין | I | 0 | 50% 50% 99% = 24.75% |
| I | 0 | 0 | I | 1 | 50% 50% 1% = 0.25% | |
| I | 1 | 1 | אין | I | 1 | 50% 50% 90% = 22.5% |
| I | 1 | 1 | I | 0 | 50% 50% 10% = 2.5% | |
| X | 0 | 1 | אין | X | 0 | 50% 50% 90% = 22.5% |
| X | 0 | 1 | X | 1 | 50% 50% 10% = 2.5% | |
| X | 1 | 0 | אין | X | 1 | 50% 50% 99% = 24.75% |
| X | 1 | 0 | X | 0 | 50% 50% 1% = 0.25% |
(ד) מהחלקים הקודמים אנחנו יודעים מהם ערכי התוחלת של Z בכל אחד מהמצבים הסופיים. צריך רק לחשב את הממוצע המשוקלל:
(ה) במקרה הפשוט מאוד הזה, ה-twirling שלנו שחזר בדיוק את ערך התוחלת האידיאלי. זה לא טיפוסי. מה שטיפוסי הוא ש-twirling מבטל הטיות כמו אלה שנגרמות ממעברים א-סימטריים, ומחזיר ערך תוחלת קרוב יותר לאידיאלי.
(ו) זה יישום של מודל צעצוע. ייתכן שחסרים כמה דברים. בפרט, לא הרצנו כאן מעגלי כיול כדי להעריך גורם סקיילינג . בדרך כלל זה הכרחי.
פרטי מימוש
TREX מופעלת אוטומטית כשמשתמשים בפרימיטיב EstimatorV2 עם resilience_level = 1 (ברירת המחדל). שימו לב שהיא לא מופעלת אוטומטית בפרימיטיב Sampler, כי Sampler מחזיר התפלגויות הסתברות מלאות ולא ערכי תוחלת.
כש-TREX מופעלת, ה-runtime יוצר וריאנטים של המעגל עם twirling למדידה, על ידי הוספת שערי Pauli אקראיים של קיוביט יחיד מיד לפני המדידה. העיבוד הקלאסי שאחרי המדידה הופך את שערי ה-Pauli האלה. הווריאנטים של המעגל אקראיים בין shots שונים וגם בין קיוביטים שונים בתוך shot. כל וריאנטי המעגל משולבים אחר כך לאומד יחיד.
TREX ניתנת להרחבה היטב. היא דורשת מעגלי כיול נוספים, כך שתקורת הדגימה היא בדרך כלל גורם קבוע קטן (לרוב פי 2-4). אבל ההפחתה ספציפית לאובזרבבל, ואינה משמרת את ההתפלגות.
TREX מתוכננת להשתלב בצורה נקייה עם שיטות רבות לדיכוי שגיאות ולהפחתת שגיאות, כולל:
-
Dynamical decoupling (DD) - פועל בזמני סרק, ואורתוגונלי להפחתת שגיאות קריאה.
-
twirling של שערים או של Pauli - לרוב משלים; TREX כבר מסתמכת על twirling אבל מטפלת רק ברעש קריאה.
-
אקסטרפולציה לרעש אפס (ZNE) - ZNE מטפלת ברעש שערים, ואילו TREX מטפלת בהטיית מדידה. השילוב הזה משמש ברמת resilience 2.
-
הגברת שגיאות הסתברותית וביטול שגיאות הסתברותי בתהליכי עבודה של Estimator.
עם זאת, יש שיטות שאי אפשר (או לא כדאי) לשלב עם TREX:
-
תיקון הסתברויות ברמת Sampler: TREX אינה מחזירה הסתברויות מתוקנות של מחרוזות ביטים.
-
הפחתה בדיעבד על נתוני TREX שכבר עברו הפחתה: תיקון כפול עלול להחזיר את ההטיה.
שילוב של TREX עם הפחתת שגיאות קריאה מבוססת מטריצת הקצאה כמו M3 הוא עניין מסובך. M3 מניח ערוץ מדידה קבוע. TREX מבצע רנדומיזציה מכוונת של המדידה, ובכך פוגע בהנחה ש-M3 נשען עליה. במובן הזה, אי אפשר פשוט לשלב בין הטכניקות. עם זאת, אם מפעילים twirling של המדידה בזמן הכיול שמשמש את M3, אולי אפשר לנצל גם גישה דמוית מטריצת הקצאה וגם גישת הפחתה מבוססת twirling בו-זמנית (אף שגישת ה-twirling הזו אינה בדיוק כמו TREX). זה נושא שחוזר שוב ושוב בשילוב טכניקות הפחתה והדחקה: הוספה עיוורת של טכניקות נכשלת; הוספה זהירה, כך שהן "מודעות" זו לזו, יכולה לעבוד ולהיות מועילה מאוד.
TREX מבטיח רק ערכי תוחלת נטולי הטיה הנובעת משגיאות קריאה; הוא לא מקטין שונות, וגם לא מגן מפני סוגים אחרים של הטיה. ברור שהוא לא מתקן את כל השגיאות. ובכל זאת, זה לרוב שיפור משמעותי, ואפשר להשיג אותו בתקורה נמוכה בהרבה משיטות אחרות שדורשות ללמוד מודלי רעש מלאים. TREX היא לרוב הפחתת שגיאות הקריאה הזולה והעמידה ביותר שקיימת, ולכן היא ברירת מחדל מצוינת בניסויים.
TREX עם Qiskit
כאן אנחנו יוצרים מעגל פשוט של שני קיוביטים, ומשתמשים ב-Estimator כדי להעריך את ערך התוחלת של אובזרבבל פשוט מאוד, ZX. ערך התוחלת האידיאלי הוא 1. נשווה בין ערכי התוחלת עם TREX ובלעדיו.
# Import packages needed for using real quantum computers

from qiskit import QuantumCircuit
from qiskit.quantum_info import SparsePauliOp
from qiskit_ibm_runtime import QiskitRuntimeService, EstimatorV2, Session
import numpy as np

# --------- Configuration ----------

backend = service.backend("ibm_fez")  # adjust if needed
יוצרים את המעגל הקוונטי הפשוט.
qc = QuantumCircuit(2)
qc.x(0)
qc.h(0)
qc.cx(0, 1)
qc.h(0)
qc.barrier()
qc.draw("mpl")

מבצעים טרנספילציה של המעגל באמצעות pass manager.
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

pass_manager = generate_preset_pass_manager(optimization_level=1, backend=backend)

qc_t = pass_manager.run(qc)
מחילים על האובזרבבל את אותו layout שהתקבל מהטרנספילציה.
# Observable: X on qubit 0, Z on qubit 1, ideal expectation value is 1.0.
observable = SparsePauliOp("ZX")
observable_t = observable.apply_layout(qc_t.layout)
מריצים את הניסוי על מחשב קוונטי אמיתי. קודם נמשיך עם reslience_level = 1; זו ברירת המחדל, אבל הגדרנו אותה במפורש כדי להבחין בין שני המקרים.
# First, we run this on an ideal simulator to confirm the ideal expectation value.

from qiskit.primitives import StatevectorEstimator as Estimator

estimator = Estimator()

job = estimator.run(pubs=[(qc, observable)])

res = job.result()
val = res[0].data.evs

print("⟨ZX⟩ ideal:", val)
⟨Z₀⟩ ideal: 0.9999999999999996
# This took 27 sec on ibm_fez. Your runtime might differ.

with Session(backend=backend) as session:
    estimator = EstimatorV2(
        mode=session,
        options={
            "resilience_level": 1,  # TREX
            "default_precision": 0.005,
        },
    )

    job = estimator.run(pubs=[(qc_t, observable_t)])

    res = job.result()
    val = res[0].data.evs

print("⟨ZX⟩ with TREX:", val)
⟨Z₀⟩ with TREX: 0.9520029143897996
עכשיו נגדיר את resilience_level ל-0 כדי להריץ בלי TREX.
# This took 12 sec on ibm_fez. Your runtime might differ.
with Session(backend=backend) as session:
    estimator = EstimatorV2(
        mode=session,
        options={
            "resilience_level": 0,  # TREX off
            "default_precision": 0.005,
        },
    )

    job = estimator.run(pubs=[(qc_t, observable_t)])

    res = job.result()
    val = res[0].data.evs

print("⟨ZX⟩ without TREX:", val)
⟨Z₀⟩ without TREX: 0.8651
ערך התוחלת קרוב משמעותית יותר לערך האידיאלי (1) עם TREX, כצפוי. כמובן, זה היה ערך תוחלת יחיד על קיוביט יחיד. עכשיו נכין מעגל שמשתמש בשערים שאינם קליפורד ובהרבה קיוביטים, כדי לבדוק אם השיפור של TREX נשאר יציב בהקשר אחר.
import numpy as np

num_qubits = 20
qc = QuantumCircuit(num_qubits)
for i in range(num_qubits):
    qc.rx(np.pi * 7 / 8, i)
qc.barrier()
CircuitInstruction(operation=Instruction(name='barrier', num_qubits=20, num_clbits=0, params=[]), qubits=(<Qubit register=(20, "q"), index=0>, <Qubit register=(20, "q"), index=1>, <Qubit register=(20, "q"), index=2>, <Qubit register=(20, "q"), index=3>, <Qubit register=(20, "q"), index=4>, <Qubit register=(20, "q"), index=5>, <Qubit register=(20, "q"), index=6>, <Qubit register=(20, "q"), index=7>, <Qubit register=(20, "q"), index=8>, <Qubit register=(20, "q"), index=9>, <Qubit register=(20, "q"), index=10>, <Qubit register=(20, "q"), index=11>, <Qubit register=(20, "q"), index=12>, <Qubit register=(20, "q"), index=13>, <Qubit register=(20, "q"), index=14>, <Qubit register=(20, "q"), index=15>, <Qubit register=(20, "q"), index=16>, <Qubit register=(20, "q"), index=17>, <Qubit register=(20, "q"), index=18>, <Qubit register=(20, "q"), index=19>), clbits=())
כאן אין שום דבר מיוחד בזווית הסיבוב . פשוט בחרנו סופרפוזיציה לא שווה כלשהי של ו- כדי לבחון את ההשפעות של מעברים שגויים לא סימטריים ואת האופן שבו TREX מטפל בהם. בהינתן המצב הזה, ערך התוחלת האידיאלי של Z על כל קיוביט, בהיעדר שגיאות כלשהן (קריאה או אחרות), יהיה:
לכן אנחנו מקווים לקבל ערכי תוחלת קרובים ל-0.924- בכל הקיוביטים. נראה אם TREX משפר כל ערך תוחלת בנפרד, וגם אם הוא משפר את הממוצע על פני כל הקיוביטים.
בדקו את ההבנה שלכם
אמתו את ערך התוחלת שלמעלה באמצעות חישוב ישיר.
תשובה
אנחנו מבצעים טרנספילציה באמצעות pass manager.
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

pass_manager = generate_preset_pass_manager(optimization_level=1, backend=backend_real)

qc_t = pass_manager.run(qc)
עכשיו נבנה אובזרבבל אחד לכל קיוביט, כדי שנוכל להעריך את כל עשרים ערכי התוחלת בזרימת עבודה אחת. כלומר, עבור הקיוביט ה- אנחנו רוצים אובזרבבל שכולו identities מסוג , חוץ מהמיקום ה-, שבו אנחנו רוצים . זכרו להחיל את ה-layout אחרי הטרנספילציה גם על האובזרבבלים.
# Observables: Z on qubit i for all i.
observables = []
for i in range(num_qubits):
    obs_string = "I" * i + "Z" + "I" * (num_qubits - i - 1)
    obs = SparsePauliOp(obs_string)
    observables.append(obs)
observables_t = [obs.apply_layout(qc_t.layout) for obs in observables]
עכשיו אפשר להריץ. תא הקוד שלמטה משתמש ב-session mode; אם אין לכם גישה ל-Sessions, אפשר להחליף אותו ב-batch mode כדי להריץ את אותה זרימת עבודה, אבל עם זמני תור אפשריים בין המעגלים.
# This took 20 sec on ibm_fez. Your runtime might differ.

with Session(backend=backend_real) as session:
    estimator = EstimatorV2(
        mode=session,
        options={
            "resilience_level": 0,  # TREX turned off
            "default_precision": 0.005,
        },
    )

    job = estimator.run(pubs=[(qc_t, observables_t)])

    res_no_trex = job.result()
    val_no_trex = res_no_trex[0].data.evs

print("⟨Z_i⟩ without TREX:", val_no_trex)
⟨Z_i⟩ without TREX: [-0.90645 -0.89755 -0.89125 -0.9165  -0.87655 -0.91035 -0.8757  -0.87905
 -0.66035 -0.8876  -0.87125 -0.89975 -0.83745 -0.89755 -0.82645 -0.90325
 -0.84385 -0.90195 -0.85865 -0.8884 ]
# This took 36 sec on ibm_fez. Your runtime might differ.

with Session(backend=backend_real) as session:
    estimator = EstimatorV2(
        mode=session,
        options={
            "resilience_level": 1,  # TREX
            "default_precision": 0.005,
        },
    )

    job = estimator.run(pubs=[(qc_t, observables_t)])

    res_trex = job.result()
    val_trex = res_trex[0].data.evs

print("⟨Z_i⟩ with TREX:", val_trex)
⟨Z_i⟩ with TREX: [-0.92086303 -0.90253698 -0.91688854 -0.93308327 -0.91273953 -0.9221892
 -0.903782   -0.93046052 -0.90348934 -0.90284174 -0.89499677 -0.91630959
 -0.89508481 -0.92233292 -0.90497141 -0.91867138 -0.91421506 -0.91646851
 -0.9268364  -0.91669818]
כאן אנחנו משווים את השגיאות המוחלטות הממוצעות עם TREX ובלעדיו.
ideal = np.cos(7 * np.pi / 8)

mean_abs_error_no_trex = np.mean(np.abs(val_no_trex - ideal))
mean_abs_error_trex = np.mean(np.abs(val_trex - ideal))

print("The mean absolute error without TREX is: ", mean_abs_error_no_trex)
print("The mean absolute error with TREX is: ", mean_abs_error_trex)
The mean absolute error without TREX is:  0.05238453251128674
The mean absolute error with TREX is:  0.011980732757900719
zx = list(range(num_qubits))
import matplotlib.pyplot as plt

fig, ax = plt.subplots()

# Add values with no DD
ax.scatter(zx, val_no_trex, c="blue", linestyle="-", label="No TREX", alpha=0.7)

## Add values with DD
ax.scatter(zx, val_trex, c="red", linestyle="-", label="With TREX", alpha=0.7)

# Add ideal reference line
ax.axhline(y=-0.924, color="black", linestyle="--", linewidth=2, label="Ideal ⟨Z⟩")

# Add labels and plot
ax.set_xlabel("Qubits")
ax.set_ylabel("<Z>")
ax.legend()
ax.set_title("<Z> in RX(7pi/8)|0> state with and without TREX")
ax.grid(True)

plt.show()
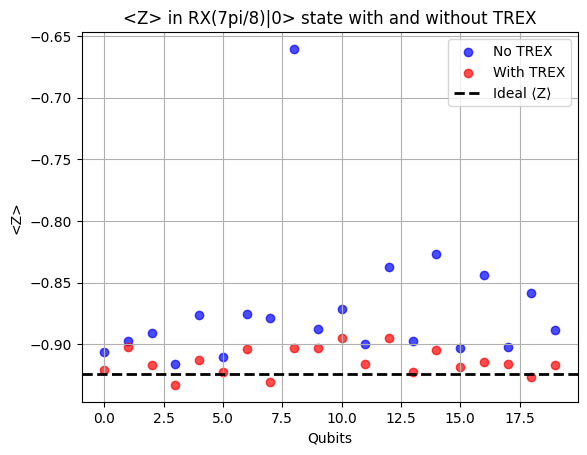
נראה ש-TREX בהחלט עזר. ערך התוחלת בכל קיוביט השתפר, למעט יוצא מן הכלל אחד: קיוביט 16. חריג כזה צפוי. אפשר לכמת את ההשפעה הכוללת של TREX על המעגל באמצעות חישוב הערכים הממוצעים.
mean_no_trex = sum(val_no_trex) / num_qubits
mean_trex = sum(val_trex) / num_qubits

print("Mean without TREX", mean_no_trex)
print("Mean with TREX", mean_trex)
Mean without TREX -0.8714950000000001
Mean with TREX -0.9137729590315635
בממוצע, TREX קירב את התוצאות שלנו בכ-2.9% לתוצאות האידיאליות, והותיר אותנו עם תוצאה שנבדלת בממוצע מהאידיאל התיאורטי ב-0.4% בלבד. זה מעולה, והשיפור הזה בתקורה נמוכה הוא בדיוק הסיבה ש-TREX היא הפחתת השגיאות המוגדרת כברירת מחדל ב-Estimator. אבל חשוב להדגיש שוב ש-TREX מסירה הטיה בשגיאת הקריאה, ולא מתקנת את כל השגיאות שלנו. בחרנו מצב התחלתי שהיה בסיכוי טוב להיות מושפע מאי-סימטריה בקריאה. ההשפעה הייתה שונה אילו הכנו כל קיוביט במצב אחר. כדי להבין בקלות למה זה חייב להיות כך, חשבו מה היה קורה אילו השארנו כל קיוביט במצב היסוד . לא הייתה לנו שום הזדמנות לראות (או לתקן) אי-סימטריה בשגיאת הקריאה בין המצבים ו-.
אקסטרפולציה לרעש אפס (ZNE)
אקסטרפולציה לרעש אפס (ZNE) היא אחת מטכניקות הפחתת השגיאות הנפוצות ביותר. גם האסטרטגיה הכללית קלה להבנה, אף שפרטי המימוש מורכבים. ZNE פועל כך:
-
הרצת מעגל המטרה ב"רמות רעש" שונות — שינויים במעגל שגורמים לרעש שלו לגדול בדרכים צפויות
-
הערכת האובזרבבל המבוקש עבור כל קנה מידה של רעש.
-
אקסטרפולציה חזרה לרעש אפס באמצעות מודל התאמה (לינארי, פולינומי, מעריכי וכן הלאה).
התוצאה היא הערכה של הערך שהאובזרבבל היה מקבל בגבול של רעש אפס, כפי שמשתמע ממודל האקסטרפולציה.
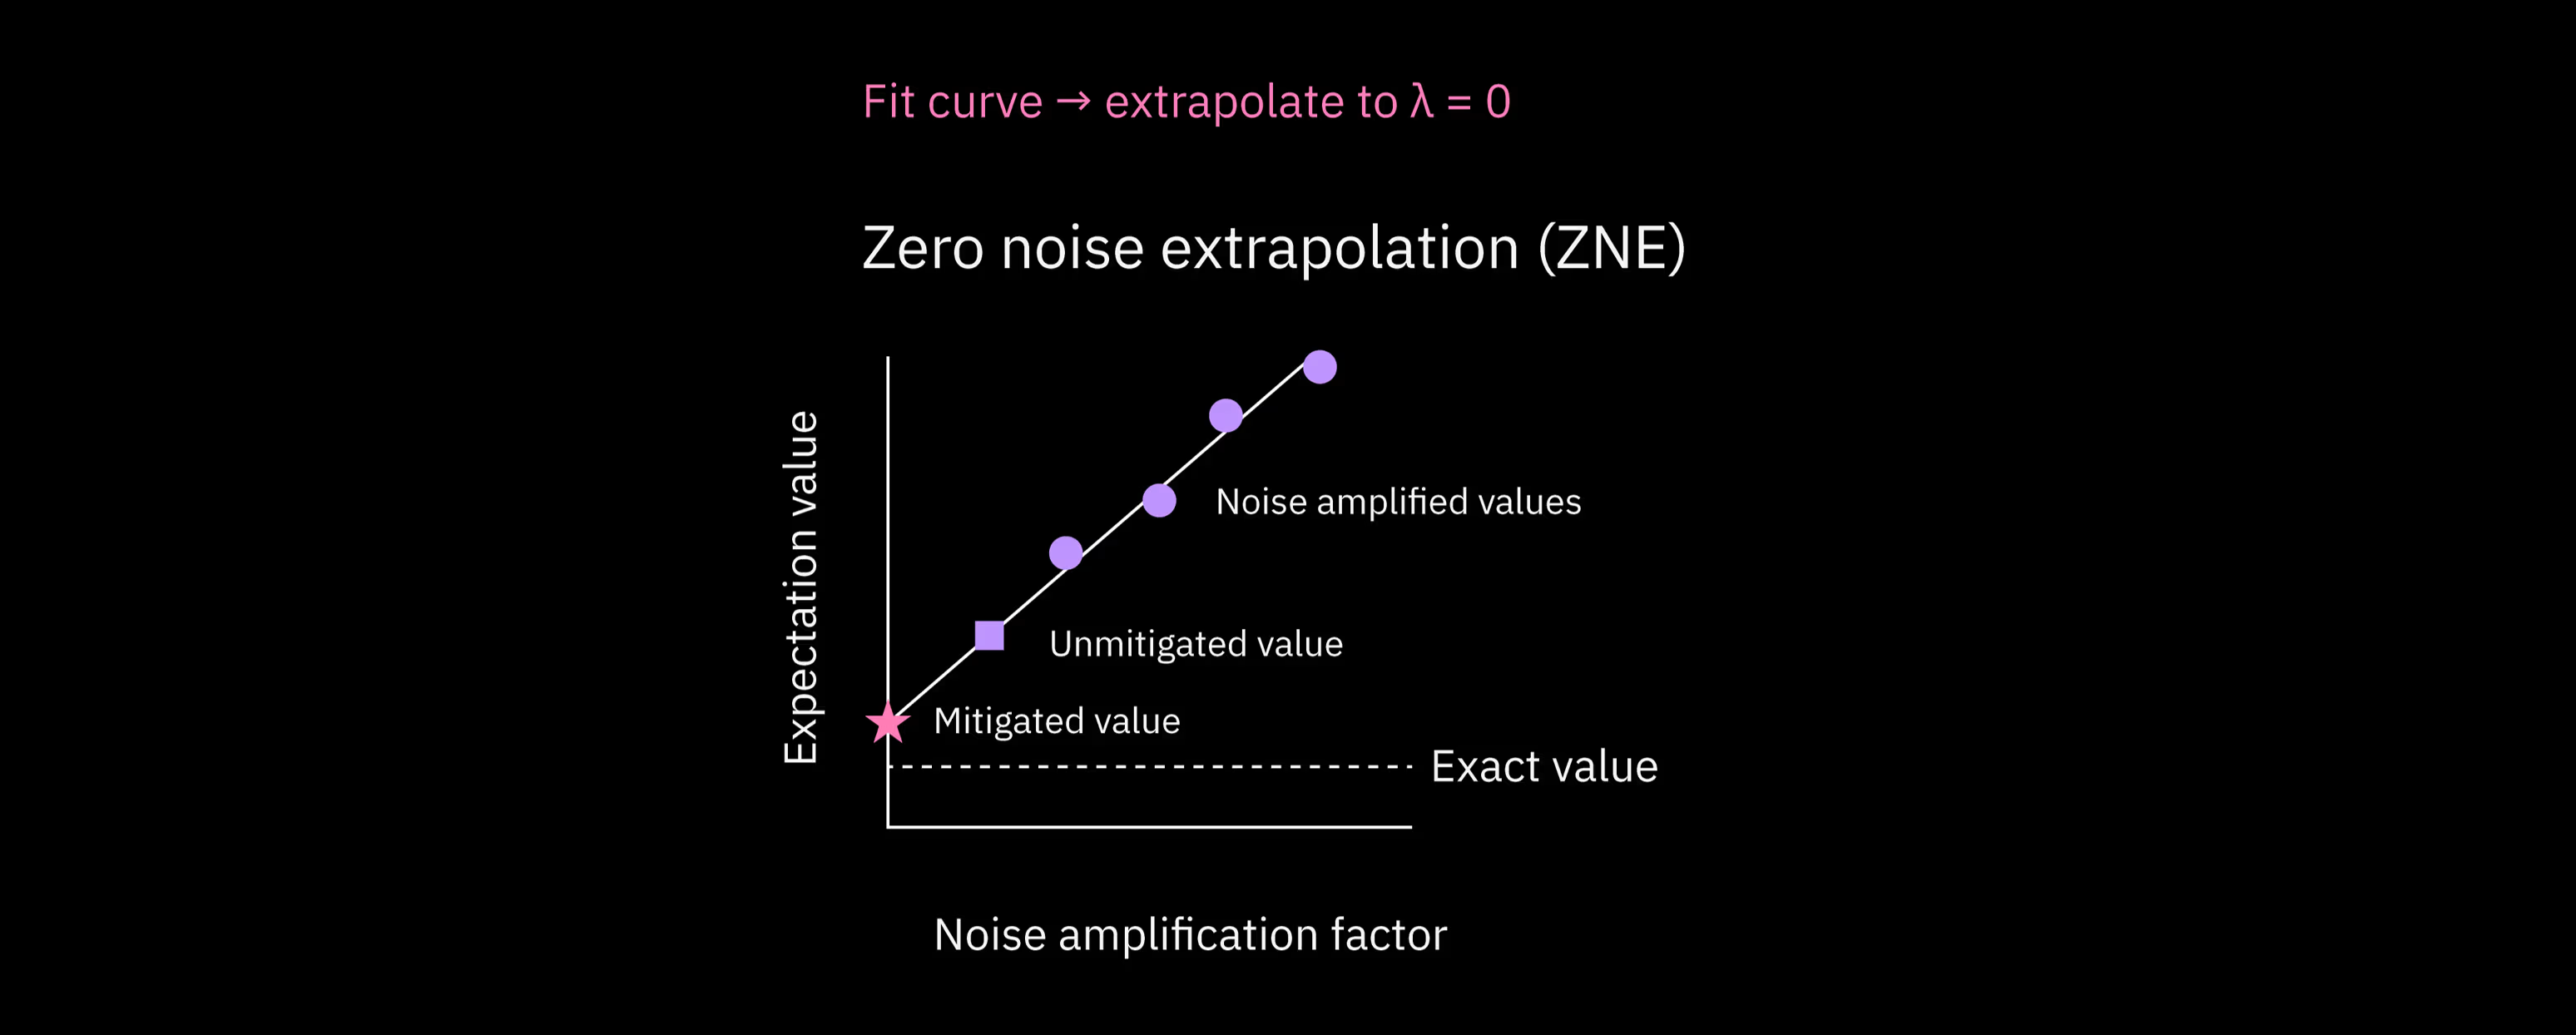
ZNE לא מבטיח שהרעש יגדל באופן חלק או לינארי כשאנחנו משנים מעגלים. במקום זאת, הוא מניח שהגדלת הרעש מתנהגת יפה מספיק כדי לאפשר אקסטרפולציה. המורכבות ב-ZNE היא באופן שבו משנים מעגלים כדי לעמוד בהנחה הזו כמה שיותר טוב. נבחן כמה גישות בשיעור הזה.
קנה מידה של משאבים ב-ZNE
ב-ZNE התקורה היא בעיקר תקורה קוונטית. כלומר, כדי לקבל ערכי תוחלת ב- רמות רעש, צריך להריץ את הניסוי על מעגלים, כל אחד עם הרבה shots. כדי לשמור על דיוק סטטיסטי קבוע, מספר הדגימות הכולל בדרך כלל גדל ככל שמוסיפים מעגלים עם רעש מוגדל.
מספר רמות הרעש שבוחנים, , תלוי בשיטה שמשמשת להגדלת הרעש. בטכניקה פשוטה אחת להגדלת רעש (שנקראת "gate-folding" ונדון בה בהמשך), הוא בדרך כלל בין 3 ל-5. שיטה אחרת (הגברת רעש הסתברותית, PNA) מאפשרת גורמי רעש שאינם שלמים, ובדרך כלל מביאה לרמות רעש נמוכות יותר מאשר gate-folding. התקורה הכוללת גדלה בערך כך:
כאשר הוא מספר ה-shots הבסיסי. דבר נוסף שכדאי לזכור הוא שאם הגדלת הרעש כוללת שערים חוזרים, עומק המעגל עשוי לגדול בגורם שפרופורציוני לערך הגדלת הרעש. הגדלת הרעש שמגיעה עם העומק המוגדל היא בדיוק המטרה, אבל כדאי לזכור את העומק הכולל.
ZNE מתאים היטב לבעיות שבהן הנקודות הבאות מתקיימות:
-
צריך שיטת הפחתה כללית שיעילה על סוגים רבים של שגיאות.
-
עומק המעגל אינו גדול מדי; ZNE נכשל כשהמעגל המוגדל רועש מדי מכדי לבצע אקסטרפולציה.
-
אפשר להסכים לתקורת זמן ריצה מתונה תמורת דיוק משופר.
בפועל, זה הופך את ZNE למתאים למעגלים וריאציוניים רבים, להערכת ערכי תוחלת ולאלגוריתמים קוונטיים אחרים לטווח הקרוב. הוא ממומש ב-Estimator באמצעות resilience_level = 2. שימו לב ש-ZNE מבצע אקסטרפולציה במרחב שיש בו תוצאה יחידה כפונקציה של הרעש לאורך המעגל כולו. המשמעות היא שהוא מתאים לבעיות הערכה, אבל לא לבעיות דגימה. הוא לא תוכנן לעבוד על התפלגויות של מחרוזות ביטים.
גורמי רעש
איך בדיוק אפשר להגדיל את רמת הרעש במעגל? יש שתי דרכים עיקריות, אף שקיימות וריאציות רבות.
-
מחליפים שער או בלוק שערים ב-. מכיוון שהשערים במחשבים קוונטיים הם אוניטריים, אנחנו יודעים ש-, ולכן מבחינה לוגית: . עם זאת, כל חזרה על או על מוסיפה שגיאה דומה או זהה, ובכך מאפשרת להגדיל את רמות הרעש/שגיאה. שימו לב שההחלפה שלמעלה מעבירה אותנו מהרעש המקורי של השער (רמת רעש 1) לפי שלוש מרמת הרעש הזו ב- (רמת רעש 3). בפועל, אפשר לחזור על שני השערים האחרונים פעמים: כדי לקבל רמת רעש . זה נקרא gate folding, והיא טכניקה נפוצה מאוד להגדלת רעש.
-
יש שיטות אחרות להגדלת רמת הרעש, כמו הגברת שגיאות הסתברותית (PEA). ב-PEA, קודם לומדים מודל רעש מתאים למעגל, שבדרך כלל מבוטא כערוץ פאולי. אחר כך הרעש מוגבר באמצעות דגימה מגרסה מוקטנת או מוגדלת של ערוץ הרעש שנלמד. על ידי כוונון הדגימה, אפשר להגדיל באופן רציף את עוצמת הרעש האפקטיבית, כולל לערכים שאינם שלמים.
בפועל, gate folding יכול להגדיל שגיאות באופן אמין מאוד, אבל הוא יכול גם להוביל למעגלים עמוקים מאוד. אם צריך רק שלוש רמות רעש (1, 3 ו-5), המשמעות היא הגדלת עומק המעגל בפי 5 ועדיין קבלת תוצאות סבירות. לכן, אם למעגל המטרה שלכם יש עומק דו-קיוביטי של 60 ומעלה אחרי טרנספילציה, סביר ש-PEA מתאים יותר מ-gate-folding.
אפשר לבצע folding של שערים באופן מקומי (כלומר, חוזרים על עבור כל שער דו-קיוביטי מיד כשהוא מופיע), או לקבץ אותם לבלוק שערים ולחזור על הבלוק (כמו בשערים ). לרוב folding מקומי עדיף מבחינת ההנחות ש-ZNE עושה, אבל שתי האפשרויות אפשריות.
הרבה ניואנסים נכנסים לטיפול הסטטיסטי בתוצאות עם רעש מוגדל ב-ZNE. לדוגמה, ברמת רעש גבוהה פי חמישה התוצאות שלכם ודאי יהיו בעלות שונות גבוהה יותר ופחות אמינות. האם צריך להתייחס אליהן באותו משקל כמו לנקודות נתונים עם פחות רעש? לא. עם זאת, לצורך הצגת ZNE בפעולה, נתעלם מחלק מהמורכבות הזו בניסוי צעצוע, שבו נבנה מעגלים עם folding ידנית, ונבצע אקסטרפולציה נאיבית עם משקלים שווים כדי להמחיש את השלבים המרכזיים. אבל אחר כך נבצע ניסוי באמצעות פונקציונליות ה-ZNE המובנית ב-Qiskit, ונראה שהיא מטפלת במורכבות שדילגנו עליה טוב יותר באופן משמעותי.
ZNE ידני
נתחיל בבחירת מעגל קוונטי ואובזרבבל שאפשר לחשב עבורם את ערך התוחלת האידיאלי בהיעדר רעש ושגיאות. אנחנו בוחרים מצב GHZ , עם מספר זוגי של קיוביטים. האובזרבבל שלנו הוא . בחרנו בו מכמה סיבות:
- ערך התוחלת קל לחישוב במקרה האידיאלי. מכיוון שמספר הקיוביטים זוגי, אנחנו מקבלים או
1מכל , כשהם מוכפלים יחד, או-1מכל , כשהם מוכפלים יחד מספר זוגי של פעמים. - הוא יהיה רגיש למדי לשגיאות ולרעש, כי שגיאה אחת בקיוביט אחד יכולה להפוך את התוצאה הכוללת של אותו shot מ-+1 ל-1-.
- ערך התוחלת רחוק מ-0. ZNE עלול להיתקל בקשיים כשערך התוחלת האידיאלי קרוב מאוד לאפס, כי רמות רעש גבוהות נוטות לבצע רנדומיזציה של התוצאות, כך שהן חיוביות לעיתים קרובות כמו שהן שליליות. התוצאה היא שערכי רעש גבוהים יניבו בסוף ערכים קרובים לאידיאל; זה יכול להפוך את האקסטרפולציה למסובכת מאוד.
עם המוטיבציה הזו בראש, בואו נבנה את המעגלים שלנו.
from qiskit import QuantumCircuit
from qiskit.quantum_info import SparsePauliOp
from qiskit.transpiler import generate_preset_pass_manager

from qiskit_ibm_runtime import (
    QiskitRuntimeService,
    Estimator,
    EstimatorOptions,
)
num_qubits = 10  # must be even

# # Noise amplification factors used for folding (2* integer +1 for gate folding)
noise_steps = [1, 3, 5]
ghz_amp = []

for j in noise_steps:
    qc = QuantumCircuit(num_qubits)
    qc.h(0)
    # Since CX^2 = I, odd repetitions implement folded versions of the gate.
    for i in range(num_qubits - 1):
        for gates in range(j):
            qc.cx(i, i + 1)
    qc.barrier()
    ghz_amp.append(qc)
שימו לב לעדינות: כאן . למרות ש-gate folding הוצג כמורכב מאופרטורים מהצורה , כאן אותו מבנה נראה כמו CNOT CNOT CNOT.
בואו נוודא שהמעגל ה- שלנו הוא אכן מעגל ה-GHZ הרגיל:
ghz_amp[0].draw("mpl")
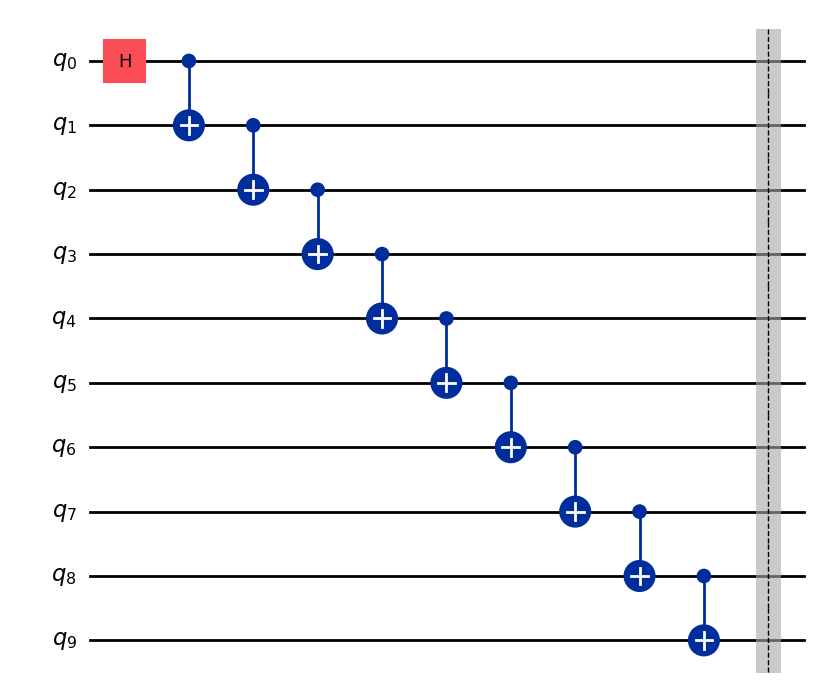
אפשר להסתכל על שאר המעגלים כדי לוודא שיש להם את המבנה הצפוי.
עכשיו נבנה את האובזרבבלים שלנו.
pauli_string = "Z" * num_qubits
observable = SparsePauliOp(pauli_string)
observables = []
for j in range(len(noise_steps)):
    observables.append(observable)
אנחנו בונים pass manager ומחילים אותו על המעגלים שלנו. אחר כך לוקחים את ה-layouts ומחילים אותם על האובזרבבלים.
pm = generate_preset_pass_manager(
    backend=backend_real,
    optimization_level=0,
)

qcs_transpiled = []
obs_transpiled = []

for j in range(len(ghz_amp)):
    # Transpile the circuit
    qc_pm = pm.run(ghz_amp[j])
    qcs_transpiled.append(qc_pm)
    # Extract the final layout
    layout = qc_pm.layout
    # Apply the layout to the observable
    obs_transpiled.append(observable.apply_layout(layout))
מעצבים את ה-pubs.
pubs = [(qc, obs) for qc, obs in zip(qcs_transpiled, obs_transpiled)]
עכשיו נריץ את Estimator. היינו רוצים להתמקד בתפקיד של ZNE, ולכן אולי נרצה להגדיר resilience_level = 0 כדי לא לערבב בין ההשפעות של twirling להשפעה של ZNE. עם זאת, אנחנו רוצים גם להשוות בין ה-ZNE "הידני" שלנו להגדרות ה-ZNE המובנות ב-Qiskit, שכוללות twirling. לכן אנחנו מגדירים כאן resilience_level = 1. הגדרת resilience_level = 2 מפעילה את הגדרות ה-ZNE של Qiskit, שבהן נשתמש בקרוב.
# This took 21 sec on ibm_fez. Your actual runtime might vary.
options = EstimatorOptions(resilience_level=1)

estimator = Estimator(
    mode=backend_real,
    options=options,
)

job = estimator.run(pubs)

res = job.result()
עכשיו נדפיס את רמות הרעש וערכי התוחלת.
# We save this for later comparisons
value_no_zne = res[0].data.evs

# Print all values used for extrapolation
print("Noise level 1: ", res[0].data.evs)
print("Noise level 3: ", res[1].data.evs)
print("Noise level 5: ", res[2].data.evs)
Noise level 1:  0.8327970939283861
Noise level 3:  0.5612869745718734
Noise level 5:  0.3130254281266217
זה החלק שבו אנחנו הכי מרשלנים: אנחנו מבצעים התאמה לינארית לנתונים האלה בלי להתחשב בשונות של כל ערך שקיבלנו, ובלי לנסות לחזות תיאורטית אם ההתאמה צריכה להיות לינארית. שוב, ה-ZNE המובנה עושה עבודה טובה בהרבה ממה שאנחנו עושים ידנית.
# Data
noise_factors = np.array([1, 3, 5])
values = np.array([res[0].data.evs, res[1].data.evs, res[2].data.evs])

# Linear fit: E(lambda) = m * lambda + b
coeffs = np.polyfit(noise_factors, values, deg=1)
slope, intercept = coeffs

print(f"Best-fit slope: {slope}")
print(f"Zero-noise extrapolated value: {intercept}")
Best-fit slope: -0.12994291645044112
Zero-noise extrapolated value: 0.9588652482269501
ממשיכים ומציירים גרף של זה לפני הפירוש.
import matplotlib.pyplot as plt

x_fit = np.linspace(0, 5.5, 100)
y_fit = slope * x_fit + intercept
y_ideal = 1.0

plt.figure()
plt.plot(noise_factors, values, "o", label="Measured data")
plt.plot(x_fit, y_fit, "-", label="Linear fit")
plt.axhline(y_ideal, linestyle="--", label="Ideal")
plt.axvline(0, linestyle="--", color="gray")
plt.scatter(0, intercept, color="red", zorder=3, label="Zero-noise estimate")

plt.xlabel("Noise amplification factor")
plt.ylabel(r"$\langle Z^{\otimes N} \rangle$")
plt.legend()
plt.show()
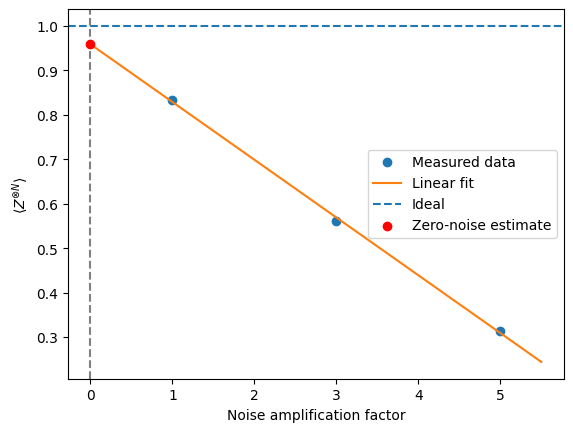
בזמן כתיבת השיעור הזה, מהאקסטרפולציה למקרה של רעש אפס קיבלנו ערך תוחלת של 0.959. ייתכן שהערכים שלכם יהיו שונים. זה טוב משמעותית מערך התוחלת של המעגל הגולמי, 0.83, וקרוב בכ-13% לערך האידיאלי. אבל אפשר גם לראות שאנחנו משתמשים בנקודת נתונים אחת שבה ערך התוחלת ירד ל-0.31. ברור שנקודת הנתונים הזו באיכות נמוכה יותר. אילו נקודת הנתונים הזו קיבלה משקל נמוך יותר בקירוב הלינארי שלנו, והישר היה מותאם יותר לשתי נקודות הנתונים הראשונות, אפשר לראות שההערכה באקסטרפולציה לאפס הייתה גבוהה יותר (קרובה יותר לערך האידיאלי). שיקול מהסוג הזה מטופל אוטומטית ב-ZNE המובנה ב-Estimator.
ZNE מובנה ב-Estimator
עכשיו נראה מה קורה כשמשתמשים בפונקציונליות ה-ZNE המובנית ב-Estimator. נתחיל בהגדרת מעגל GHZ פשוט, בלי gate folding.
num_qubits = 10  # must be even

qc = QuantumCircuit(num_qubits)
qc.h(0)

for i in range(num_qubits - 1):
    qc.cx(i, i + 1)

qc.barrier()
CircuitInstruction(operation=Instruction(name='barrier', num_qubits=10, num_clbits=0, params=[]), qubits=(<Qubit register=(10, "q"), index=0>, <Qubit register=(10, "q"), index=1>, <Qubit register=(10, "q"), index=2>, <Qubit register=(10, "q"), index=3>, <Qubit register=(10, "q"), index=4>, <Qubit register=(10, "q"), index=5>, <Qubit register=(10, "q"), index=6>, <Qubit register=(10, "q"), index=7>, <Qubit register=(10, "q"), index=8>, <Qubit register=(10, "q"), index=9>), clbits=())
אנחנו מגדירים את אותו אובזרבבל כמו קודם.
pauli_string = "Z" * num_qubits
observable = SparsePauliOp(pauli_string)
אנחנו שוב מגדירים pass manager, עם optimization_level = 1. נחזור לבחירה הזו בהמשך.
pm = generate_preset_pass_manager(
    backend=backend_real,
    optimization_level=1,
)
מבצעים טרנספילציה של המעגל ומחילים את ה-layout על האובזרבבלים.
# Transpile the circuit
qc_transpiled = pm.run(qc)

# Extract the final layout
layout = qc_transpiled.layout

# Apply the layout to the observable
obs_transpiled = observable.apply_layout(layout)
אנחנו מריצים את Estimator עם ZNE ו-twirling, ומשווים את התוצאות למימוש ה-ZNE הידני שלנו. בפרט, משווים אותן לתוצאה בלי ZNE (value_no_zne).
# This used 18 sec on ibm_fez. Your actual QPU time might vary.

options_zne = {
    "resilience_level": 2,
    "resilience": {
        "zne": {
            "noise_factors": [1, 3, 5],
        }
    },
    "twirling": {
        "enable_gates": True,
        "enable_measure": True,
        "num_randomizations": "auto",
    },
}

estimator_zne = Estimator(
    mode=backend_real,
    options=options_zne,
)

job_zne = estimator_zne.run([(qc_transpiled, obs_transpiled)])

value_zne = job_zne.result()[0].data.evs
אפשר לשלוף את הערכים בכל גורם רעש באמצעות התחביר job_zne.result()[0].data.evs_noise_factors. כמו קודם, אפשר היה להשתמש בתוצאות האלה באופן נאיבי כדי לקבל התאמה לינארית ולבצע אקסטרפולציה למקרה של רעש אפס, אבל ה-estimator עם resilience_level = 2 כבר עשה עבודה טובה יותר, תוך התחשבות בשונות ובשיקולים נוספים. למטה אנחנו מראים מה הייתה מניבה אקסטרפולציה לינארית, ומה בפועל הניב ה-ZNE המובנה.
# Data
noise_factors = np.array([1, 3, 5])
values_qiskit_zne = np.array(job_zne.result()[0].data.evs_noise_factors)

# Linear fit: E(lambda) = m * lambda + b
coeffs = np.polyfit(noise_factors, values_qiskit_zne, deg=1)
slope, intercept = coeffs

print(f"Best-fit slope: {slope}")
print(f"Zero-noise extrapolated value: {intercept}")
Best-fit slope: -0.11745451044574956
Zero-noise extrapolated value: 0.9045922788100509
print("Exp val ideal: 1.0")
print("Exp val with no ZNE: ", value_no_zne)
print("Exp val with ZNE: ", value_zne)
print("Fractional improvement: ", (value_zne - value_no_zne) * 100 / 1.0, "%")
Exp val ideal: 1.0
Exp val with no ZNE:  0.8327970939283861
Exp val with ZNE:  0.9877508802932561
Fractional improvement:  15.495378636487 %
import matplotlib.pyplot as plt

x_fit = np.linspace(0, 5.5, 100)
y_fit = slope * x_fit + intercept
y_ideal = 1.0

plt.figure()
plt.plot(noise_factors, values, "o", label="Measured data")
plt.plot(x_fit, y_fit, "-", label="Linear fit")
plt.axhline(y_ideal, linestyle="--", label="Ideal")
plt.axvline(0, linestyle="--", color="gray")
plt.scatter(0, intercept, color="red", zorder=3, label="Linear")
plt.scatter(0, value_zne, color="black", zorder=3, label="Proper ZNE")

plt.xlabel("Noise amplification factor")
plt.ylabel(r"$\langle Z^{\otimes N} \rangle$")
plt.legend()
plt.show()
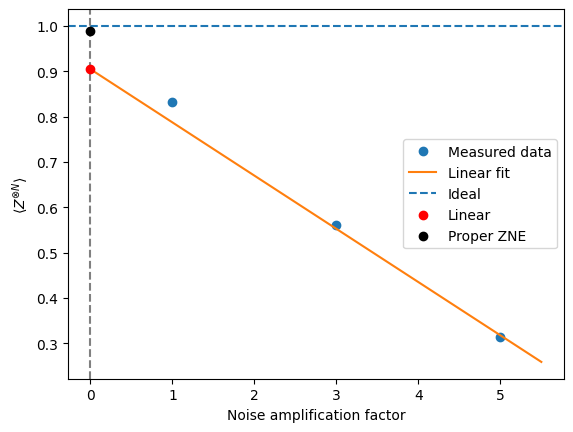
אנחנו רואים שה-ZNE המובנה שיפר את ההערכה שלנו ביותר מ-15%, ועבד טוב יותר בצורה ניכרת מהניסיון הידני שלנו.
לפני שממשיכים, שימו לב שלאורך כל חקירת ה-ZNE הזו הגדרנו optimization_level = 1 ב-pass manager. רמות אופטימיזציה גבוהות יותר מפחיתות שגיאות, ולפעמים הפחתת השגיאות יכולה לגרום לשגיאות לגדול פחות צפוי. כמו בהרבה מקרים, יש כאן איזון: להפחית שגיאות, אלא כשמגדילים אותן בכוונה בגורם ידוע.
שילוב שיטות
ZNE נשען על הדברים הבאים:
-
פרמטר מוגדר היטב להגדלת הרעש
-
התנהגות חלקה וצפויה מספיק של ערכי התוחלת כפונקציה של
-
אותו ערוץ רעש אפקטיבי, בעוצמות שונות
-
לא מוכנסת הטיה שאינה גדלה עם
ZNE משתלב היטב עם טכניקות שמסירות הטיות שאינן גדלות (כמו M3) או שהופכות את הרעש לסדיר יותר (כמו twirling), אבל מתנגש עם טכניקות שמנסות לבטל את הרעש לגמרי (PEC) או לעצב אותו מחדש באופן דינמי (DD).
בפרט, M3 מטפל רק בשגיאות מדידה/קריאה, שבפועל אפשר להתייחס אליהן כנפרדות משגיאות שערים (שהן המוקד של תהליכי הגדלת השגיאות ב-ZNE). M3 כמעט בלתי תלוי ב-gate folding; אפשר לשלב אותו עם ZNE בצורה נקייה. TREX דומה מאוד, וגם אותו אפשר לשלב עם ZNE.
Pauli twirling כן מתמקד בשערים, בניגוד ל-M3 ול-TREX. עם זאת, זכרו ש-Pauli twirling לא מפחית ישירות שגיאה/רעש; הוא משנה אותם כדי להפוך אותם לצפויים יותר. ייתכן ש-Pauli twirling דווקא יועיל לתהליך ה-ZNE, כי הוא גורם לשגיאות השערים לגדול בצורה לינארית יותר, ובכך הופך את האקסטרפולציה למדויקת יותר.
Dynamical decoupling (DD) מורכב יותר. DD משנה באופן דינמי את התנהגות הרעש באמצעות ביטול חלקי של שגיאות מסוימות על ידי הוספת רצפי שערים. אם אפשר לבנות מעגלים כך ש-DD מתנהג באותו אופן גם כשמבצעים folding לשערים או לבלוקים, אז באופן עקרוני אפשר לשלב ZNE ו-DD, אבל בפועל DD לפעמים מפריע להגדלת הרעש. אם רוצים לשלב אותם, כדאי לשקול את הדברים הבאים:
- האם DD מוחל באופן עקבי בכל רמות הרעש?
- האם ה-folding משמר את מבנה ה-DD?
- האם הגדלת הרעש המתקבלת עדיין מתנהגת באופן מונוטוני?
שיטת מיתון השגיאות האחרונה שנדון בה כגישה עצמאית אינה תואמת ל-ZNE: ביטול שגיאות הסתברותי.
ביטול שגיאות הסתברותי (PEC)
בניגוד ל-ZNE או למיתון מדידה, PEC מנסה לבטל רעש ברמת השער על ידי שחזור הערוץ האידיאלי בתוחלת. ביטול שגיאות הסתברותי (PEC) הוא טכניקת מיתון השגיאות החזקה והיקרה ביותר מבין אלה שמכוסות בשיעור הזה. PEC בנוי סביב היפוך מפורש של ערוץ הרעש, שמתבצע סטטיסטית ולא פיזית. PEC פועל כך:
-
אפיון מודל הרעש באמצעות בסיס של "פעולות שגיאה".
-
ביטוי ההופכי של ערוץ הרעש כהתפלגות מעין-הסתברותית על פעולות פיזיות.
-
דגימה מההתפלגות הזו בזמן הרצת המעגל, כדי לבנות סטטיסטית הערכה חסרת הטיה של החישוב האידיאלי.
מבחינה מושגית, PEC הוא כמו תיקון שגיאות וירטואלי — הוא "מבטל" רעש על ידי שילוב פעולות רועשות בדפוסים אקראיים בעלי משקל מחושב בקפידה. מבחינה פרוצדורלית, לעומת זאת, PEC אינו קשור קשר הדוק לקוד תיקון או איתור שגיאות. ההערכה חסרת ההטיה של PEC לערך התוחלת האידיאלי נטול הרעש באה במחיר של תקורת דגימה גדולה מאוד ותלות חזקה באפיון מדויק של הרעש.
במחשבים קוונטיים של IBM, PEC נתפס בצורה הטובה ביותר ככלי דיוק ולא כשכבת מיתון כללית: הוא מתאים ביותר למעגלים קטנים או לחלקים קטנים של מעגלים גדולים יותר, למשימות benchmarking ולמחקרים שדורשים דיוק גבוה ושבהם תקורה קוונטית גבוהה מקובלת.
אפיון ערוץ הרעש
ב-PEC, כל שער אידיאלי במעגל קוונטי מדומה כערוץ אוניטרי אידיאלי שאחריו תהליך רעש. נסמן ב- את מטריצת הצפיפות של המצב הקוונטי. השער האידיאלי מיוצג על ידי מטריצה אוניטרית , שמשרה ערוץ קוונטי:
בחומרה אמיתית, האבולוציה האידיאלית הזו מושחתת על ידי רעש. אנחנו מדמים את המימוש הפיזי של השער כערוץ רועש אפקטיבי:
כאשר הוא ערוץ רעש שמתאר את השגיאות הסטוכסטיות הקשורות לשער. לאורך הדיון הזה, , ו- הם העתקות לינאריות הפועלות על אופרטורי צפיפות. הערוץ האידיאלי הוא אוניטרי והפיך, ואילו ערוץ הרעש (ולכן גם ) הוא העתקה חיובית לחלוטין ששומרת עקבה (CPTP).
PEC מניח שערוץ הרעש ידוע או ידוע בקירוב. בחומרה של IBM Quantum, המידע הזה מתקבל בדרך כלל מנתוני כיול של המכשיר, משיעורי שגיאה שמוסקים מניסויי benchmarking, ומודלי רעש מפושטים כמו קירובי Pauli או דה-פולריזציה עבור קבוצות קטנות של שערים. אף ש-PEC לא דורש מודל רעש מדויק לחלוטין, הביצועים שלו יורדים במהירות ככל שערוץ הרעש המונח מתרחק מהתנהגות החומרה האמיתית.
פירוק מעין-הסתברותי של ערוץ הרעש ההופכי
הרעיון המרכזי של PEC הוא לבטל את השפעת הרעש בתוחלת על ידי בניית קירוב סטוכסטי להופכי של ערוץ הרעש. באופן פורמלי, המטרה היא להחיל העתקה לינארית שמבטלת בקירוב את , כך ש:
בתוחלת על פני הרצות רבות של המעגל.
ההופכי מוגדר כאן כהופכי האלגברי של כשהוא נחשב לסופר-אופרטור לינארי הפועל על אופרטורים. ההופכי הזה קיים רק אם הוא בדרגה מלאה; תהליכי רעש שאינם הפיכים אי אפשר למתן במדויק באמצעות PEC.
כשההיפוך אפשרי, PEC מבטא את ערוץ הרעש ההופכי כצירוף לינארי של פעולות שאפשר לממש פיזית:
כאן, כל היא פעולה רועשת שאפשר להריץ בחומרה (בדרך כלל שערים מקוריים או רצפים קצרים של שערים), והמקדמים הממשיים יוצרים התפלגות מעין-הסתברותית. בניגוד להסתברויות רגילות, המקדמים עשויים להיות שליליים או לחרוג מ-1.
הנורמה המעין-הסתברותית:
מכמתת את עלות היפוך הרעש. עבור כל ערוץ רעש לא טריוויאלי, . בחומרה של IBM Quantum, הפירוק הזה מתבצע בדרך כלל:
- לכל שער או לכל קבוצה קטנה של שערים,
- תוך הנחת מודלי רעש מוגבלים (לרוב קירובים אלכסוניים בבסיס Pauli),
- תוך שימוש בפעולות מקוריות הייחודיות ל-Backend ובאילוצי תזמון.
שחזור מונטה קרלו של המעגל האידיאלי
כדי להעריך את ערך התוחלת של אובזרבבל , PEC משתמש בדגימת מונטה קרלו המבוססת על הפירוק שלמעלה. לכל הופעה של שער רועש במעגל, מתבצע ההליך הבא:
-
בוחרים באקראי פעולה בהסתברות:
-
מקצים משקל קלאסי:
-
מריצים את המעגל הרועש האקראי שהתקבל על ה-Backend הקוונטי.
-
מכפילים את התוצאה הנמדדת במכפלה של כל המשקלים שנצברו.
-
מחשבים ממוצע של התוצאות המשוקללות על פני הרצות רבות של המעגל.
האמידה שמתקבלת מקיימת
בתנאי שמודל הרעש מתאר במדויק את החומרה. לכן PEC מכניס אפס הטיה שיטתית בתוחלת, אבל מחליף את ההטיה בשונות סטטיסטית גדולה. כל הרצה מפיקה הערכה רועשת אבל משוקללת; רק אחרי חישוב ממוצע של הרבה הרצות כאלה מתגלה ערך התוחלת האידיאלי.
פירוש מושגי
לפעמים מתארים את PEC כתיקון שגיאות וירטואלי. אף שהניסוח הזה אינו שגוי לגמרי, אסור לבלבל אותו עם תיקון שגיאות קוונטי אמיתי. ב-PEC אין קידוד לוגי, אין חילוץ סינדרום ואין משוב בזמן אמת. שגיאות אינן נמנעות ואינן מתוקנות במהלך הרצת המעגל.
במקום זאת, PEC מבטל רעש סטטיסטית, על ידי שילוב של מימושים רבים של מעגלים רועשים עם משקלים קלאסיים בעלי סימן, כך שהשגיאות מתבטלות רק בעיבוד קלאסי לאחר המדידות. המידע אינו מוגן במהלך ההרצה; התוצאות האידיאליות משוחזרות בדיעבד.
קנה מידה של משאבים ועלות
העלות הדומיננטית של PEC נובעת מהגברת שונות. השונות של אמידת PEC גדלה כך:
כלומר:
קנה המידה הזה הוא יסודי ואי אפשר לשפר אותו באמצעות עיבוד קלאסי לאחר מכן.
במעגלים שמכילים הרבה שערים רועשים, כל שער תורם גורם , וכתוצאה מכך הנורמה המעין-הסתברותית הכוללת גדלה בקירוב באופן כפלי:
כאשר הוא עומק המעגל. בחומרה של IBM Quantum, זה מוביל בדרך כלל לגידול מעריכי בעלות הדגימה עם עומק המעגל, עם רגישות חזקה במיוחד לשגיאות של שערים דו-Qubit. קנה המידה הזה מציב מגבלות מעשיות על היישומיות של PEC.
PEC מעשי כיום רק כאשר אחד התנאים הבאים או כולם מתקיימים:
-
המעגלים קטנים מאוד או רדודים (לעיתים קרובות שערים),
-
מודלי הרעש פשוטים ומאומתים היטב (לדוגמה, רעש Pauli),
-
עלות סטטיסטית גבוהה מקובלת,
-
המטרה היא דיוק ולא תפוקה.
מסיבה זו, PEC מוחל לעיתים קרובות על:
-
תת-מעגלים מבודדים בתוך זרימות עבודה גדולות יותר,
-
צעדי אבולוציה קצרי זמן,
-
שגרות הכנת מצב או מדידה,
-
ניסויי benchmarking ואימות.
ערימת התוכנה של IBM (IBM Quantum Compute וכלי מיתון השגיאות) משקפת זאת בכך שהיא מתייחסת ל-PEC כאל אפשרות ייעודית, ולא כאל שכבת מיתון המוגדרת כברירת מחדל.
מקרי שימוש אופייניים ל-PEC כוללים:
-
בנצ'מרקינג מדויק של חומרה קוונטית,
-
אימות של אלגוריתמים קוונטיים קטנים,
-
כימיה קוונטית בדיוק גבוה על מערכות מצומצמות,
-
בדיקה צולבת של ZNE או של שיטות מיתון אחרות.
היחס של PEC לשיטות מיתון אחרות
שיטות מיתון רבות אחרות מחליפות דיוק בסקלביליות; PEC עושה בדיוק את ההפך, ומתמקדת בדיוק מעל לכול.
מכיוון ש-PEC עשויה לשמש רק על תת-מעגל, חשוב במיוחד לשאול כאן אילו שיטות מיתון אחרות אפשר לשלב איתה. כדי לחשוב בבהירות על תאימות ל-PEC, כדאי לסווג את הטכניקות לפי מה שהן עושות לרעש. נתבונן בקטגוריות הכלליות האלה:
-
ביטול רעש - ניסיון להפוך את ערוצי השגיאה
-
קנה מידה של רעש - הגברה מכוונת של הרעש לצורך אקסטרפולציה
-
עיצוב מחדש של רעש - שינוי המבנה או הספקטרום של הרעש
-
הסרת הטיה - תיקון שגיאות שאינן גדלות עם רעש השערים
PEC נמצאת בבירור בקטגוריה (1). כל שיטה ששינה או משנה את קנה המידה של ערוץ הרעש צריכה בדיקה קפדנית.
טבלת סיכום (ברמה גבוהה)
| טכניקה | תואמת ל-PEC | הערות |
|---|---|---|
| ZNE | לא | ביטול לעומת קנה מידה, ולפעמים התאמה של השגיאה |
| Pauli twirling | כן (בזהירות) | משפיע על התנהגות השגיאה, אבל עשוי להקל על הלמידה שלה |
| TREX | כן | אין חפיפה בתהליך העבודה. תואמת לגמרי. |
| Dynamical decoupling | בדרך כלל לא | משנה את ערוץ השגיאה |
PEC ו-ZNE מטפלות באותם מקורות שגיאה (שגיאות שערים) דרך הנחות או תהליכי עבודה שאינם תואמים זה לזה, או שניהם. לדוגמה, ב-ZNE אנחנו מניחים שאפשר לפתח את השגיאה לפי פרמטר :
ושאפשר לשנות את קנה המידה של השגיאה באופן יעיל כדי לדמות את הפיתוח הזה. PEC תבטל בדיוק את השגיאה שעליה אנחנו מסתמכים לצורך שינוי קנה המידה. הפרמטר יהפוך חסר משמעות. דרך נוספת לחשוב על זה:
-
הפעלת ZNE לפני PEC משנה את ערוץ הרעש שאתם מנסים להפוך.
-
הפעלת PEC לפני ZNE מסירה בדיוק את הרעש ש-ZNE מסתמכת עליו לצורך אקסטרפולציה.
יש לראות ב-PEC וב-ZNE פרדיגמות חלופיות של מיתון שגיאות, ולא שכבות שאפשר להרכיב יחד. השוואה ביניהן זו לצד זו מלמדת, ואילו שילוב שלהן אינו מלמד.
PEC ו-Pauli twirling תואמות בדרך כלל ולעיתים קרובות מועילות. ה-twirling עשוי לעזור ל-PEC כיוון שהוא ממיר שגיאות קוהרנטיות לשגיאות Pauli סטוכסטיות. כך ערוץ הרעש נעשה פשוט יותר, וקל יותר לייצג אותו ולהפוך אותו. עבור PEC זה בעל ערך רב, מהסיבות הבאות:
-
פירוקי קוואזי-הסתברות פשוטים בהרבה עבור ערוצי Pauli
-
הנורמה של הקוואזי-הסתברות קטנה לעיתים קרובות באופן משמעותי
-
שונות הדגימה קטנה
הדגמות רבות של PEC מניחות או מובנות עם רעש שעבר Pauli twirling. חשוב להבהיר ש-Pauli twirling אינו ממתן שגיאות בעצמו; הוא מעצב מחדש את הרעש לצורה ש-probabilistic error cancellation יכולה לטפל בה ביעילות רבה יותר.
אפשר, וכדאי, לשלב את PEC עם TREX. הגישות האלה תואמות לגמרי ומשחקות תפקידים אורתוגונליים. TREX פועלת רק במדידה, מסירה הטיית קריאה באמצעות twirls אקראיים של ערוץ המדידה, ואינה משפיעה על רעש השערים או על דינמיקת המעגל. PEC פועלת על רעש השערים. מכיוון ששגיאת מדידה היא חיבורית ולא הרכבתית, היא בלתי תלויה ברצפי השערים. בטוח, ולעיתים קרובות רצוי, להפעיל את TREX לצד PEC.
סדר השיטות הללו הוא כפי שאפשר לצפות:
- מריצים את המעגל האקראי של PEC
- מפעילים את TREX כדי למתן שגיאת קריאה
- מפעילים את שקלול PEC ואת הממוצע
PEC ו-DD אינן תואמות בדרך כלל, אלא אם אפיון הרעש המשמש את PEC מבוצע כשה-DD פעיל. PEC מניחה ש- הוא סטציונרי, ניתן לחזרה וניתן לאפיון מדויק. DD מעצבת מחדש במפורש את ערוץ הרעש בזמן על ידי אפנון אינטראקציות בין המערכת לסביבה והכנסת השפעות תזמון פולסים לא טריוויאליות. כתוצאה מכך, הרעש האפקטיבי עם DD אינו אותו ערוץ כמו בלי DD. העניין מסתבך עוד יותר בגלל שערוץ הרעש יכול להיות תלוי מאוד בתזמון המעגל. התוצאה היא שהיפוך הרעש נעשה לא מוגדר היטב או לא תקף.
תיאורטית אפשר לאפיין את הרעש כשה-DD פעיל ולבנות מודל PEC בהתאם, אבל זה מתקדם מאוד ואינו תהליך עבודה מומלץ כרגע.
הפעלת PEC ידנית
PEC מורכבת, ומומלץ שלא לממש אותה ידנית. עם זאת, אנחנו רוצים לעבור על המתמטיקה של יישום בסיסי על Qubit יחיד כדי להבין אילו שלבים התהליך כולל. בחרנו מצב מעורב אך לא טריוויאלי כדי שנוכל לראות את ההשפעות המספריות בבירור.
ניקח Qubit שאמור להיות במצב הטהור
מטריצת הצפיפות האידיאלית היא:
בחרנו במטריצת הצפיפות הזו כי היא אינה אלכסונית ומתייחסת ל-Qubit יחיד בלבד, כך שאפשר לבחון אותה "ידנית".
עכשיו נפעיל מודל רעש פשוט מאוד אך ריאליסטי: ערוץ depolarizing של Qubit יחיד, עם עוצמה קטנה .
כדי לשמור על חשבון נוח, ניקח . ערוץ זה חיובי לחלוטין ושומר עקבה (CPTP), כמו שצריך. זהו ערוץ רעש ריאליסטי עבור חומרה אמיתית, או לפחות ריאליסטי לתיאור חלק מהרעש. בנוסף, ערוץ הרעש הזה הפיך אנליטית, כמפה לינארית. במילים אחרות, קיימת מטריצה הופכית, אבל זה לא אומר שהמטריצה מתאימה לערוץ פיזיקלי מסוג CPTP, וודאי שאינה מתאימה לאופרטור אוניטרי שאפשר לממש בחומרה.
עכשיו נפעיל את ערוץ ה-depolarizing שלנו על מטריצת הצפיפות של ה-Qubit היחיד ונקבל:
עם : ו-.
So:
בהפעלה על המצב שלנו:
נחשב במפורש:
זו עדיין מטריצת צפיפות פיזיקלית, ועדיין יש לה עקבה אחת — אבל עכשיו היא מעורבת יותר.
עכשיו נחשב את הערוץ ההופכי האידיאלי, אבל נהיה מוכנים היטב לאפשרות שהוא אינו פיזיקלי. נבדוק אם הוא כזה. מתמטית, המפה הלינארית ההופכית היא:
אילו הפעולה ההופכית הייתה בעצמה ערוץ פיזיקלי תקף, היינו מתפתים לנסות לממש אותה במדויק. כמובן, עדיין היינו צריכים להבין איך לממש אותה באמצעות פעולות אוניטריות וצעדים קלאסיים, אבל המימוש הזה היה המטרה. עם זאת, מתברר שהיא אינה CPTP, ובדרך כלל אין שום ערובה שמיפויים הופכיים כאלה יהיו CPTP. זה קריטי לדיון הנוכחי, כי זו הסיבה לקיומה של PEC.
אולי תוכלו לראות שהיא אינה CPTP רק מעיון בה. בדיקה בטוחה היא להפעיל אותה על מטריצת צפיפות ולראות אם היא מחזירה תוצאות פיזיקליות. זה נשאר כתרגיל לבדיקת ההבנה שלכם.
בדקו את ההבנה שלכם
בדקו אם המיפוי ההופכי מלמעלה הוא CPTP על ידי הפעלתו על מטריצת צפיפות חדשה:
פרשו את התוצאות כפיזיקליות או כלא פיזיקליות.
תשובה
כמטריצת צפיפות פיזיקלית, היא מתאימה להסתברות קלאסית גדולה מ-1 שהמערכת נמצאת במצב , ולהסתברות שלילית להיות במצב . ברור שהמיפוי הזה יכול להניב מטריצות צפיפות חסרות היגיון. בנוסף, בעיון אפשר לראות שהערכים העצמיים של מטריצת הצפיפות המתקבלת הם 1.0625 ו--0.0625, כלומר לא כל הערכים העצמיים חיוביים. לכן המיפוי אינו "חיובי לחלוטין", ה-"CP" ב-CPTP.
בדקו את ההבנה שלכם
בדקו בחישוב מפורש שהפעולה ההופכית שלמעלה מבטלת את ערוץ הרעש ומחזירה את המצב נטול הרעש.
תשובה
נפעיל אותה על המצב הרועש:
זהו בדיוק המצב המקורי (עד כדי עיגול).
נחזור ונאמר כדי להיות ברורים לגמרי: אי אפשר להפוך את ערוץ הרעש במדויק; ההופכי אינו CPTP, וגם אינו ערוץ פיזיקלי תקף. עם זאת, אפשר להפוך את הערוץ באופן אפקטיבי כצירוף לינארי של ערוצים פיזיקליים.
עבור ערוץ ה-depolarizing:
כאשר: וכן הלאה.
את ההופכי אפשר לכתוב כך:
with:
-
= ערוצי Clifford הניתנים למימוש פיזיקלי
-
= קוואזי-הסתברויות
-
Some
זהו הרעיון המרכזי מאחורי PEC:
-
דוגמים ערוצים לפי ∣
-
מצמידים סימנים לתוצאות המדידה
-
ערכי התוחלת מתכנסים לערך נטול הרעש
נפעיל את PEC "ידנית" על הערכת באמצעות מטריצת הצפיפות ונראה אם אפשר לשחזר את התוצאות של . עבור אנחנו מצפים ל:
שימו לב גם שעבור מטריצת הצפיפות הרועשת אנחנו מקבלים:
זו סדרת הגודל הנכונה, אבל רחוקה משמעותית מהמקרה האידיאלי.
עכשיו נעבור שלב אחר שלב על האופן שבו, בתהליך PEC, אפשר לשחזר את ערך התוחלת חסר ההטיה ממטריצת הצפיפות הרועשת. בתהליכי עבודה אמיתיים זה הסתברותי ויהיה אוטומטי. בתהליך "הידני" הזה נבחר ערכים הסתברותיים ריאליסטיים, אך אולי נוחים להצגה שלנו. אין לראות בכך טענה ש-PEC מושלמת. זה רק כדי להראות לכם תרחיש סביר שיכול לקרות בתוך חבילות ה-PEC.
נזכיר שערוץ הרעש שלנו הוא מהצורה:
את ההופכי אפשר לכתוב (במדויק):
based on symmetry of the transformation and the completeness of the Pauli operators. Inverting the noise channel somehow in the estimation process should yield an estimator that is unbiased and normalized. To do this, we must at least determine the coefficents and and then think about how to implement the inverse transformation. When done by a noise learner, the inversion of this noise channel would be done at the channel level, independent of a specific case like our density matrix. The coefficients and would come from this inversion.
במבוא הזה פשוט יותר להתמקד בהשפעת הערוץ על מטריצת הצפיפות שלנו. כך אפשר לעבוד עם אובייקטים מוכרים כמו מטריצות צפיפות וערכי תוחלת. לשם כך, נבחן מה חייב להתקיים בהשפעות של הפעולה ההופכית הזו על תהליך ההערכה שלנו: האומד שמפיקה PEC חייב להיות מנורמל וחסר הטיה. זה מתאים לשני תנאים:
-
נרמול: כדי להבטיח שהפעולה הזו אינה משנה את קנה המידה של ה-observable, נדרוש ש-. כדי להבין למה זה כך, אפשר לשקול את פעולת ההופכי על מטריצת צפיפות, או את פעולתו על ערך התוחלת של משהו טריוויאלי כמו עצמו.
-
כיול: בתהליך עבודה אמיתי אנחנו משתמשים במעגלי כיול כדי ללמוד את התנהגות הרעש ברמת השער. לאחר מכן אנחנו משתמשים בידע ברמת השער על התנהגות הרעש, ובליניאריות של ערכי תוחלת, כדי להחיל את מודל הרעש שנלמד על המעגל הגדול יותר. במקרה שלנו התחלנו מידע מלאכותי שערך התוחלת האידיאלי הוא . אבל קל מאוד להמציא מצב שעבורו אנחנו יודעים תיאורטית שזה הערך האידיאלי, ואז להשתמש במדידות אמיתיות לצורך כיול. נקודה חשובה היא ש-ב-PEC בדרך כלל לא לומדים מודל רעש מלא של המעגל כולו. במקום זאת לומדים מודלי רעש מקומיים עבור שערים בודדים או שכבות מעגל בודדות, ומשתמשים בהם לבניית פירוק הקוואזי-הסתברות.
אנחנו משתמשים בתנאים האלה כדי לקבוע את ו-. נתבונן בצורה המוצעת (ansatz)
and apply it to an arbitrary single-qubit density matrix .
נזכיר שערוצי Pauli פועלים באמצעות צמידה:
הפעלת על נותנת:
אם ניקח את העקבה, נקבל:
כל אופרטור Pauli הוא אוניטרי, ולכן צמידה שומרת על העקבה:
Therefore,
כדי שאומד ה-PEC יהיה מנורמל, המפה ההופכית האפקטיבית חייבת לשמור על העקבה של כל מטריצות הצפיפות. כלומר, אנחנו דורשים:
מכאן נובע אילוץ הנרמול:
אבל במקרה שלנו, זה נותן את התנאי:
עכשיו אנחנו משתמשים במידע הכיול כדי לקשר בין ערך התוחלת שנצפה לבין הערך האידיאלי הידוע.
Or equivalently,
אחרי פתרון שני התנאים שלנו עבור ו-, נקבל:
המקדמים האלה מסתכמים ל-1, אבל אחד מהם שלילי.
אפשר לשחזר את ערך התוחלת האידיאלי על ידי שינוי אקראי של המעגל, מדידה, הכפלת התוצאה במשקל מסומן, ולקיחת ממוצע. בפרט, לא משחזרים אף מטריצת צפיפות ולא מממשים פיזית אף ערוץ הופכי.
שלב המפתח: זו PEC
עבור עוצמת הרעש שלנו , אפשר לכתוב את הערוץ ההופכי כך:
עובדות חשובות:
-
המקדמים מסתכמים ל-1
-
מקדם אחד שלילי
-
כל איבר ניתן למימוש פיזי
-
השליליות עוברת לעיבוד קלאסי לאחר המדידה
אנחנו יוצרים התפלגות דגימה מהערכים המוחלטים של המשקלים:
(עבור כל אחד מ-X, Y, Z)
משקל כולל:
כדי לקבל הסתברויות דגימה, מחלקים ב-W.
| פעולה | הסתברות | סימן |
|---|---|---|
| לא עושים דבר () | 1.1875 / 1.375 ≈ 0.864 | + |
| מפעילים X | 0.0625 / 1.375 ≈ 0.045 | - |
| מפעילים Y | 0.0625 / 1.375 ≈ 0.045 | - |
| מפעילים Z | 0.0625 / 1.375 ≈ 0.045 | - |
הסימן נובע מהמקדם המקורי, לא מההסתברות.
כל shot מורכב מהצעדים הבאים:
-
מכינים את המצב
-
נותנים לחומרה להפעיל את המעגל הרועש
-
בוחרים באקראי פעולה מהטבלה שלמעלה לפי ההסתברויות המתאימות
-
Apply it
-
מודדים ומקבלים
-
מכפילים את התוצאה ב-
-
רושמים את המספר הזה
עכשיו נעבור על דוגמאות של כמה shots.
Shot 1 (מקרה הזהות)
נניח שהפעולה שנבחרה באקראי היא הזהות (או באופן שקול: לא עושים דבר). לפי הטיעונים והטבלה שלמעלה, זה יקרה ב-86.4% מהמקרים. מכיוון שהמקדם של בהופכי של ערוץ הרעש חיובי, אנחנו בוחרים בסימן . מדידת Z שלנו יכולה בקלות להניב . נניח שהיא מניבה .
התרומה המתוקנת ב-PEC מה-shot הזה תהיה:
Shot 2 (שוב הזהות)
נניח שוב שקיבלנו את כפעולה האקראית (כך שסימן האיבר עדיין בהתחלה), אבל הפעם מדידת Z מניבה . הפעם התרומה היא:
Shot 3 (נבחרה X)
הפעם הפעולה האקראית שלנו היא X. האיבר הזה בהופכי שלילי, ולכן אנחנו שומרים על סימן . מפעילים X ואז מודדים Z. שוב, אפשר לקבל כל אחד מהערכים העצמיים; נניח שקיבלנו . התרומה מהאיבר הזה היא:
Shot 4 (נבחרה Z)
הפעולה האקראית היא Z. זה נותן לנו סימן מהטבלה. נניח שמדדנו Z וקיבלנו . התרומה היא:
Shot 5 (נבחרה Y)
הפעולה האקראית היא Y. זה נותן לנו סימן מהטבלה. נניח שמדדנו Z וקיבלנו . התרומה היא:
חישוב ממוצע של התוצאות
נדמיין שאספנו הרבה תוצאות כאלה בשקלול PEC:
מעצם הבנייה, אנחנו מפעילים את הזהות ב-86.4% מהמקרים. כל אחד מהשערים האחרים מופעל ב-4.5% מהמקרים. בתהליך עבודה אמיתי איננו יודעים את המצבים הבסיסיים המדויקים, וגם לא את ערוץ הרעש כולו. אבל אנחנו כן יודעים את גורם השקלול מלמעלה, ואת ההסתברות היחסית שבה אנחנו מפעילים כל פעולה. בתהליך עבודה אמיתי אנחנו מסתמכים על מטריצת הצפיפות הלא ידועה שתיתן לנו תוצאות מדידה. נוודא כאן שהתהליך הזה אכן ייתן את התוצאות הנכונות.
אנחנו רוצים לחשב את הממוצע של כל המדידות המשוקללות והמסומנות, כולל הפעלות של אופרטורי Pauli לפני המדידה. נסמן את המספר הכולל של כל ה-shots ב-. נסמן ב- את קבוצת כל ה-shots שבהם הופעל Pauli , ונשתמש ב- כדי לאנדקס את ה-shots האלה. נסמן ב- את תוצאת המדידה של ה-shot ה- תחת הפעלת ה-Pauli ה-. אפשר לכתוב את הממוצע הזה כך:
אופרטור Pauli מופעל באופן הסתברותי בהסתברות . בגבול של מספר גדול של shots,
אפשר להשתמש בזה כדי לכתוב:
כאשר הוא ערך התוחלת של Z רק על פני אנסמבל ה-shots שבהם הופעל . זה שימושי כי אנחנו יודעים מהי ערך התוחלת הזה בכל מקרה ממטריצת הצפיפות. שוב, בתהליך עבודה אמיתי זה היה עולה מהמדידה, ולא ממטריצת צפיפות ידועה.
בדקו את ההבנה שלכם
אמתו את ערכי התוחלת שלמעלה באמצעות חישוב או הסקה לוגית.
תשובה
Y ו-Z מתנהגים בדיוק כמו למעלה.
עכשיו אפשר לכתוב מחדש את ערך התוחלת הכולל כך:
אם אנחנו מכירים את הפרמטרים ו- של רעש השערים שלנו (או פרמטרים נוספים עבור ערוצי רעש מורכבים יותר), זה מספיק כדי לקבוע (1) את גורם המשקל הכולל, ו-(2) את ההסתברויות שבהן צריך להפעיל את אופרטורי Pauli. מה שהתוצאה שלמעלה מראה הוא שאם נעשה זאת, נצמצם את הרעש ונשחזר ערכי תוחלת חסרי הטיה. הממוצע על פני כל ה-shots התכנס ל-, למרות ש:
-
shots בודדים תורמים ערכים גדולים מ-±1
-
לחלק מה-shots יש משקל סטטיסטי שלילי
-
כל פעולה קוונטית הייתה פיזיקלית
סקירה של תהליך העבודה של PEC
ב-PEC, כל השלבים במחשב הקוונטי הם:
-
למידת הרעש
-
הכנת מצב עבור המעגל שלכם
-
הפעלת שערי פאולי באופן הסתברותי, כמתואר למעלה
-
Measurement
מפת הרעש ההופכית האפקטיבית ממומשת באופן סטטיסטי בעיבוד קלאסי שאחרי המדידה. זה מאפשר היפוך כללי יותר של ערוצי רעש, שבלעדיו היו נדרשים צעדים לא פיזיקליים כמו הסתברויות שליליות.
המחיר שאנחנו משלמים על כך הוא שונות. קודם, לכל shot הייתה "עוצמה" השווה לעוצמות תוצאות המדידה האפשריות . לאחר שינוי קנה המידה בגורם המשקל , העוצמה שלו היא (1.375 בדוגמה שלמעלה).
זה המקור לתקורת הדגימה של PEC.
PEC מובנה
עכשיו נשתמש ב-PEC כפי שהוא מובנה בפרימיטיבים של IBM Quantum. חשוב כאן להבחין בין PEC מלא ברמת השער לבין מודל למידת רעש מקומי עבור PEC ברי-הרחבה יותר, שבו משתמשים הפרימיטיבים של IBM Quantum. התקורה של PEC מלא הייתה מגבילה את השימוש בו למעגלים קטנים. זה בסדר, אבל שימושי יותר להשתמש בכלי שיכול להתרחב לגודל שבו מחשוב קוונטי הופך לבעל ערך עבור בעיות מהעולם האמיתי. מסיבה זו, הפרימיטיבים של IBM Quantum משתמשים ב-PEC שכבתי המבוסס על מודל רעש Pauli-Lindblad נלמד, עם אמצעי הגנה נחרצים לטובת יכולת הרחבה. במימוש הזה של PEC, הרעש נלמד לכל שכבת מעגל חוזרת ולא לכל מופע של שער, ומודל הרעש הוא Pauli-twirled, מקומי ומרקובי. שערי Clifford נבלעים במודל הרעש, בעוד ששערים שאינם Clifford הם שקובעים את עלות ההפחתה. תקורת הדגימה מוגבלת בתקרה כדי למנוע התפוצצות אקספוננציאלית.
נפעיל את ה-PEC המובנה בפרימיטיבים של IBM Quantum בשני קני מידה: קטן (שישה qubit) ובינוני (30 qubit), כדי לראות איך העלות נשמרת בשליטה בגרסה הזו של PEC. בכל ניסוי בגודל נתון נשווה במפורש גם את התוצאות של PEC לאלה ללא הפחתת שגיאות, עם ZNE, ולערך האידיאלי.
נתחיל בייבוא של כמה חבילות הכרחיות.
import numpy as np

from qiskit import QuantumCircuit
from qiskit.quantum_info import SparsePauliOp, Statevector

# from qiskit_aer import AerSimulator
from qiskit.transpiler import generate_preset_pass_manager

from qiskit_ibm_runtime import (
    # QiskitRuntimeService,
    Estimator,
    EstimatorOptions,
)
אנחנו בוחרים אובזרבבל להערכה. האובזרבבל שלמטה הוא ההמילטוניאן של שרשרת ספינים מסוג Ising, עם צימוד בין שכנים קרובים בלבד ברכיב של האינטראקציה ביניהם, ועם איבר חד-qubit ב-, כאילו נובע משדה חיצוני ב-.
אין סיבה מיוחדת לבחירת ההמילטוניאן הזה. אנחנו פשוט צריכים שילוב של אובזרבבל ומעגל שאינו טריוויאלי, כדי שהפחתת שגיאות תוכל לעשות את עבודתה. אנחנו מקנים את ההמילטוניאן במפורש (באמצעות המקדמים), ומחלקים במספר ה-qubit כך שהאנרגיה תישאר באותו סדר גודל כשנגדיל את מספר ה-qubit. נתחיל עם שישה בלבד.
# This cell builds the observable

num_qubits = 6

terms = []
coeffs = []

# XX interactions
for i in range(num_qubits - 1):
    pauli = ["I"] * num_qubits
    pauli[i] = "X"
    pauli[i + 1] = "X"
    terms.append("".join(pauli))
    coeffs.append(1.0 / (num_qubits - 1))

# Z fields
for i in range(num_qubits):
    pauli = ["I"] * num_qubits
    pauli[i] = "Z"
    terms.append("".join(pauli))
    coeffs.append(0.5 / num_qubits)

observable = SparsePauliOp(terms, coeffs)
כמו בבחירת ההמילטוניאן, גם המעגל להכנת המצב שלמטה לא נבחר מסיבות פיזיקליות. הוא נבחר כך שיהיה לו עומק דו-qubit מספיק ומספר רב מספיק של שערים שאינם Clifford, כדי ש-PEC יהיה שימושי. אין סיבה לחשוב שהמעגל הזה מקרב היטב, למשל, את מצב היסוד של שרשרת הספינים הזו.
qc = QuantumCircuit(num_qubits)

# Clifford preparation
for i in range(num_qubits):
    #    qc.h(i)
    qc.ry(0.5, i)

# Clifford entanglement
for i in range(num_qubits - 1):
    qc.cx(i, i + 1)

# --- Non-Clifford "probe" ---
# Small-angle rotation (RZ(pi/8) ~= T gate)
qc.rz(3.141592653589793 / 8, 2)

# More Clifford mixing
for i in reversed(range(num_qubits - 1)):
    qc.cx(i, i + 1)

qc.barrier()

qc.draw("mpl")
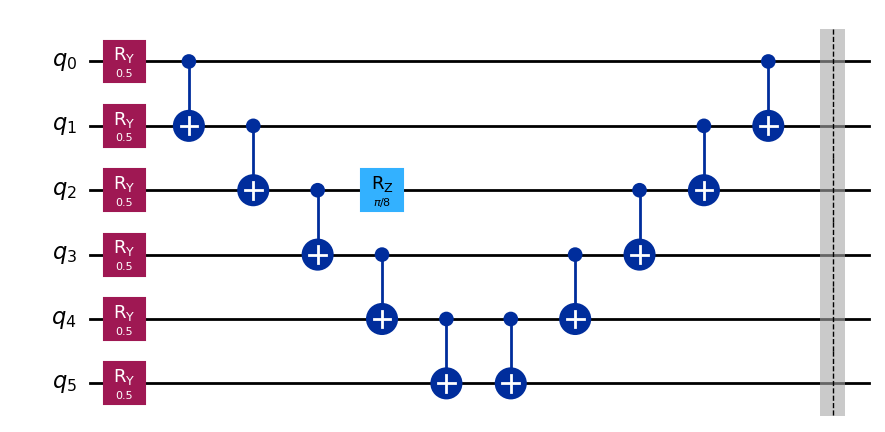
אנחנו מבצעים transpile למעגל ומחילים את ה-layout שהתקבל על האובזרבבלים שלנו.
# service = QiskitRuntimeService()

# backend = service.least_busy(
##    operational=True,
#   simulator=False,
#   min_num_qubits=num_qubits,
# )

pm = generate_preset_pass_manager(
    backend=backend_real,
    optimization_level=1,
)

qc_transpiled = pm.run(qc)

layout = qc_transpiled.layout
obs_transpiled = observable.apply_layout(layout)
אנחנו מקבלים את ערך התצפית האידיאלי באמצעות הסימולטור Statevector.
# Compute the ideal final state
state = Statevector.from_instruction(qc)

# Compute expectation value
ideal_value = np.real(state.expectation_value(observable))

print("Ideal (noiseless) expectation value:")
print(ideal_value)
Ideal (noiseless) expectation value:
0.6651408876730361
אנו מצפים שערכים אידיאליים אחרים יהיו דומים בגודלם. עכשיו נריץ את זה על מחשב קוונטי אמיתי של IBM, ללא הפחתת שגיאות.
# This took 3 sec on ibm_fez. Your actual runtime might vary.

options_none = EstimatorOptions(resilience_level=0)

estimator_none = Estimator(
    mode=backend_real,
    options=options_none,
)

job_none = estimator_none.run([(qc_transpiled, obs_transpiled)])

value_none = job_none.result()[0].data.evs
print("No mitigation:", value_none)
No mitigation: 0.569677734375
עכשיו נחיל ZNE על אותה בעיה.
# This took 17 sec on ibm_fez. Your actual runtime might vary.

options_zne = EstimatorOptions(resilience_level=2)

estimator_zne = Estimator(
    mode=backend_real,
    options=options_zne,
)

job_zne = estimator_zne.run([(qc_transpiled, obs_transpiled)])

value_zne = job_zne.result()[0].data.evs
print("ZNE:", value_zne)
ZNE: 0.6573718927156127
לבסוף, נחיל PEC.
# This took 17 sec on ibm_fez. Your actual runtime might vary.

from qiskit_ibm_runtime.options import EstimatorOptions

options = EstimatorOptions()

# One does not use ZNE with PEC
options.resilience.zne_mitigation = False
options.resilience.pec_mitigation = True
options.resilience.pec.max_overhead = 100

estimator_pec = Estimator(
    mode=backend_real,
    options=options,
)

job_pec = estimator_pec.run([(qc_transpiled, obs_transpiled)])

result = job_pec.result()
value_pec = result[0].data.evs

print("PEC:", value_pec)
PEC: 0.6666196849843695
למטה אנחנו מציירים את התוצאות ומשווים.
import matplotlib.pyplot as plt

methods = ["No mitigation", "ZNE", "PEC"]
values = [value_none, value_zne, value_pec]

ideal = ideal_value  # from Aer statevector

plt.figure(figsize=(6, 4))

plt.plot(methods, values, "o", label="Measured", markersize=8)
plt.axhline(ideal, color="black", linestyle="--", label="Ideal (Aer)")

plt.ylabel("Expectation value")
plt.title("Error mitigation comparison")
plt.legend()
plt.grid(axis="y", alpha=0.3)

plt.tight_layout()
plt.show()
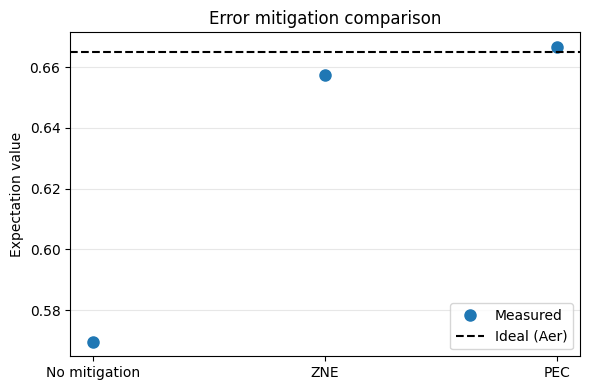
זה עבד טוב מאוד. ההערכה שלנו באמצעות PEC רחוקה מהערך האידיאלי ב-0.2% בלבד.
אבל זכרו שהתקורה הקוונטית גדלה אקספוננציאלית. אכפנו תקורה מקסימלית של max_overhead = 100. לפי הזמן ואיכות התוצאות, נראה שאולי לא הגענו למקסימום הזה. עם זאת, אם נגדיל את החישוב ונשאיר את המקסימום במקומו, נגיע אליו, והתוצאות שלנו יפגעו.
אפשר לראות מה קורה כשמגדילים את המעגל ל-30 qubit. מעניין לציין שבמחשבים ניידים רבים הסימולטור Statevector יתחיל להגיע ל-timeout סביב 24-28 qubit. אפשר היה למצוא דרכים חישוביות לעקוף את זה. אבל במקום זאת, בואו נאמץ את העובדה שמחשבים קוונטיים יוכלו לפתור בעיות מסוימות בקנה מידה שמחשבים קלאסיים לא יצליחו לעמוד בו. זו הנקודה. אז מה אפשר לעשות כדי לאמת את תוצאות המחשוב הקוונטי שלנו במקרים כאלה? יש כמה תשובות אפשריות:
- יש בעיות שקשה לפתור אבל קל לבדוק (כמו פירוק לגורמים ראשוניים באלגוריתם של Shor).
- לחלק מהבעיות יש תחומי פרמטרים או גרסאות שמורכבותם נמוכה יותר, ואפשר לפתור אותם באופן קלאסי, ואפילו אנליטי, כדי להשוות כמה נקודות. במקרה שלנו, בחרנו המילטוניאן אינטרינזי (חילקנו במספר ה-qubit). ערך התצפית האידיאלי אמור להיות יציב למדי. בואו נראה איך ערך התצפית האידיאלי משתנה עם מספר ה-qubit, ונבדוק אם אפשר לבצע תחזיות קלאסיות לגבי הערך ב-30 qubit.
import numpy as np
import matplotlib.pyplot as plt

from qiskit import QuantumCircuit
from qiskit.quantum_info import Statevector, SparsePauliOp

num_qubits_max = 24

qubits = [4, 8, 12, 16, 20, 24]
exp_vals = []
for num_qubits in qubits:
    qc = QuantumCircuit(num_qubits)

    for i in range(num_qubits):
        qc.ry(0.7, i)
    for i in range(num_qubits - 1):
        qc.cx(i, i + 1)
    for i in range(num_qubits):
        qc.rz(np.pi / 5, i)
    for i in reversed(range(num_qubits - 1)):
        qc.cx(i, i + 1)
    qc.barrier()

    terms = []
    coeffs = []

    # XX interactions
    for i in range(num_qubits - 1):
        pauli = ["I"] * num_qubits
        pauli[i] = "X"
        pauli[i + 1] = "X"
        terms.append("".join(pauli))
        coeffs.append(1.0 / (num_qubits - 1))

    # Z fields
    for i in range(num_qubits):
        pauli = ["I"] * num_qubits
        pauli[i] = "Z"
        terms.append("".join(pauli))
        coeffs.append(0.5 / num_qubits)

    observable = SparsePauliOp(terms, coeffs)

    # Compute the ideal final state
    state = Statevector.from_instruction(qc)

    # Compute expectation value
    ideal_value = np.real(state.expectation_value(observable))
    exp_vals.append(ideal_value)

print(exp_vals)

plt.figure()
plt.plot(qubits, exp_vals, "o", label="Statevector")
plt.xlabel("Number of qubits")
plt.ylabel(r"$\langle O^{\otimes N} \rangle$")
plt.legend()
plt.show()
[np.float64(0.7181764372838925), np.float64(0.7181764372838922), np.float64(0.7181764372838931), np.float64(0.7181764372838906), np.float64(0.7181764372838907), np.float64(0.7181764372838709)]
ואכן, אנחנו רואים שבחרנו המילטוניאן ומצב שאינם משתנים עם מספר ה-qubit. זה שימוש גרוע מאוד ליישום מחקרי של מחשוב קוונטי, אבל מצוין להשוואת ביצועים של טכניקות הפחתת שגיאות. אפשר להשתמש בביטחון בערך תצפית קבוע זה כתוצאה האידיאלית, גם כשמגדילים את מספר ה-qubit לצורך בדיקת הפחתת השגיאות.
num_qubits = 30

qc = QuantumCircuit(num_qubits)

# Clifford preparation
for i in range(num_qubits):
    #    qc.h(i)
    qc.ry(0.7, i)

# Clifford entanglement
for i in range(num_qubits - 1):
    qc.cx(i, i + 1)

# --- Non-Clifford "probe" ---
# Small-angle rotation (RZ(pi/8) ~= T gate)

for i in range(num_qubits):
    qc.rz(np.pi / 5, i)

# More Clifford mixing
for i in reversed(range(num_qubits - 1)):
    qc.cx(i, i + 1)

qc.barrier()

qc.draw("mpl")

# This cell builds the observable

terms = []
coeffs = []

# XX interactions
for i in range(num_qubits - 1):
    pauli = ["I"] * num_qubits
    pauli[i] = "X"
    pauli[i + 1] = "X"
    terms.append("".join(pauli))
    coeffs.append(1.0 / (num_qubits - 1))

# Z fields
for i in range(num_qubits):
    pauli = ["I"] * num_qubits
    pauli[i] = "Z"
    terms.append("".join(pauli))
    coeffs.append(0.5 / num_qubits)

observable = SparsePauliOp(terms, coeffs)

# service = QiskitRuntimeService()

# backend = service.least_busy(
##    operational=True,
#   simulator=False,
#   min_num_qubits=num_qubits,
# )

pm = generate_preset_pass_manager(
    backend=backend_real,
    optimization_level=1,
)

qc_transpiled = pm.run(qc)

layout = qc_transpiled.layout
obs_transpiled = observable.apply_layout(layout)

# Compute the ideal final state
# This might time out above about 26 qubits. The Hamiltonian has been "normalized".
# The same expectation value calculated on the smaller example above is still valid.
# state = Statevector.from_instruction(qc)

# Compute expectation value
# ideal_value = np.real(state.expectation_value(observable))

print("Ideal (noiseless) expectation value:")
print(ideal_value)
Ideal (noiseless) expectation value:
0.7181764372838709
# This took 5 sec on ibm_fez. Your actual runtime might vary.

options_none = EstimatorOptions(resilience_level=0)

estimator_none = Estimator(
    mode=backend_real,
    options=options_none,
)

job_none = estimator_none.run([(qc_transpiled, obs_transpiled)])

value_none = job_none.result()[0].data.evs
print("No mitigation:", value_none)
No mitigation: 0.5869884271731322
עכשיו נריץ את המעגל הגדול יותר עם ZNE.
# This took 17 sec on ibm_fez. Your actual runtime might vary.

options_zne = EstimatorOptions(resilience_level=2)

estimator_zne = Estimator(
    mode=backend_real,
    options=options_zne,
)

job_zne = estimator_zne.run([(qc_transpiled, obs_transpiled)])

value_zne = job_zne.result()[0].data.evs
print("ZNE:", value_zne)
ZNE: 0.7096089981595511
לבסוף, נריץ את דוגמת ה-30 qubit עם PEC.
# This took 4 min 57 sec on ibm_fez. Your actual runtime might vary.

options = EstimatorOptions()

# One does not use ZNE with PEC
options.resilience.zne_mitigation = False
options.resilience.pec_mitigation = True
options.resilience.pec.max_overhead = 100

estimator_pec = Estimator(
    mode=backend_real,
    options=options,
)

job_pec = estimator_pec.run([(qc_transpiled, obs_transpiled)])

value_pec = job_pec.result()[0].data.evs
print("PEC:", value_pec)
PEC: 0.3481257778627795
job_id_none = job_none.job_id()
job_id_zne = job_zne.job_id()
job_id_pec = job_pec.job_id()
print("job number with no mitigation:  ", job_id_none)
print("job number with ZNE  ", job_id_zne)
print("job number with PEC  ", job_id_pec)
job number with no mitigation:   d7uc79back5s73be1cv0
job number with ZNE   d7uc7c3ack5s73be1d40
job number with PEC   d7uc9k4inasc738smhu0
import matplotlib.pyplot as plt

methods = ["No mitigation", "ZNE", "PEC"]
values = [value_none, value_zne, value_pec]

ideal = ideal_value  # from Aer statevector

plt.figure(figsize=(6, 4))

plt.plot(methods, values, "o", label="Measured", markersize=8)
plt.axhline(ideal, color="black", linestyle="--", label="Ideal (Aer)")

plt.ylabel("Expectation value")
plt.title("Error mitigation comparison")
plt.legend()
plt.grid(axis="y", alpha=0.3)

plt.tight_layout()
plt.show()
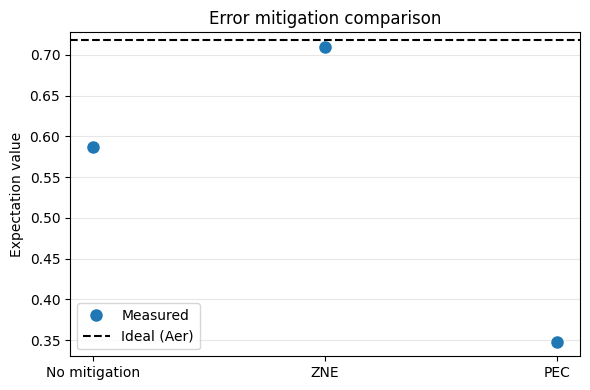
PEC לא רק לקח הרבה יותר זמן מהאפשרויות האחרות, אלא שברור שהגענו לסף התקורה המקסימלי שלנו. תוצאות PEC שילמו את מחיר התקורה, אבל תקרת התקורה מנעה ביטול מדויק מספיק של מודל הרעש הנלמד. זה קריטי. בשישה qubit הצלחנו לנצל את PEC ולקבל תוצאות טובות יותר עם עלייה צנועה בלבד בתקורה הקוונטית (בערך פי 5). ב-30 qubit שילמנו מחיר גבוה בהרבה (בערך פי 60) והתוצאות היו אפילו גרועות מההערכה ללא הפחתת שגיאות. זה לא אומר ש-PEC לעולם לא יעבוד עם 30 qubit; ייתכן שזה תלוי במעגל. המסר הוא פשוט שהגידול האקספוננציאלי בתקורה הקוונטית מקשה על הרצה עבור מעגלים גדולים.
נקודות עיקריות:
-
הפחתת שגיאות מדידה לרוב עוזר ובדרך כלל כרוכה בתקורה נמוכה: היא מסירה הטיה שאינה גדלה עם עומק המעגל, והיא משתלבת היטב כמעט עם כל דבר.
-
אי אפשר לשלב טכניקות מסוימות. גם כשאפשר, יש לוודא שמשלבים אותן באופן עקבי, כך שאחת לא מבטלת את השנייה. דוגמה טובה היא הקפדה על twirling פעיל בזמן הכיול של M3, אם רוצים לשלב את השיטות האלה.
-
יש לחשוב על PEC ועל ZNE כעל חלופות זו לזו. הן פותרות את אותה בעיה עם פשרות הפוכות:
-
PEC: מניב ערכי תצפית חסרי הטיה במחיר של שונות אקספוננציאלית.
-
ZNE בדרך כלל מניב הטיה שיורית התלויה במודל האקסטרפולציה, אך בעלות מתונה.
-
-
DD יכול לעזור בתקופות ממושכות של חוסר פעילות, אך הוא משנה את מבנה מודל הרעש ועלול לפסול הנחות של אקסטרפולציה או היפוך.
-
Pauli twirling לא מפחית רעש. הוא משנה את מבנהו ולעיתים קרובות מאפשר לטכניקות אחרות לעבוד טוב יותר (ZNE ו-PEC).