סיווג סיכון אשראי עם Rimay Quantum Feature Extraction של Kipu Quantum
Qiskit Functions הן תכונה ניסיונית הזמינה רק למשתמשי IBM Quantum® Premium Plan, Flex Plan ו-On-Prem (דרך IBM Quantum Platform API) Plan. הן בסטטוס גרסת תצוגה מקדימה ועשויות להשתנות.
הערכת שימוש: 2 דקות על מעבד Nighthawk r2. (הערה: זו הערכה בלבד. זמן הריצה שלכם עשוי להשתנות.)
תוצאות למידה
-
הכינו נתונים טבלאיים עם עמודות קטגוריאליות ומספריות עבור Rimay Qiskit Function.
-
התאימו מיפוי מאפיינים קוונטי על נתוני אימון ומפו את נתוני הבדיקה באותה הרצה.
-
אמנו מודלים קלאסיים על מאפיינים שעברו טרנספורמציה קוונטית, לבדם ובשילוב עם המאפיינים המקוריים.
-
השוו את התוצאות מול בסיס השוואה קלאסי לחלוטין.
דרישות מקדימות
לפני שמתחילים את המדריך הזה, כדאי להכיר את הנושאים הבאים:
-
סיווג מונחה (supervised classification) עם scikit-learn
רקע
הרבה בעיות למידת מכונה בתעשייה עוסקות במערכי נתונים טבלאיים קטנים או בינוניים, שבהם אי אפשר להוסיף עוד נתונים ודיוק המודל מגיע לרמה שלא עולה מעבר לה. דירוג סיכון אשראי הוא דוגמה אופיינית. מלווה משתמש בכמה עשרות מאפיינים כדי להחליט אם המבקש צפוי להחזיר את האשראי.
Rimay, פונקציית Qiskit Function של Kipu Quantum, מוסיפה לצינור כזה שלב עיבוד מקדים קוונטי. היא מממשת את אלגוריתם חילוץ המאפיינים הקוונטי הדיגיטלי הקונטרא-דיאבטי [1]. כל מאפיין קלט ממופה ל-qubit אחד. ערכי המאפיינים והמידע ההדדי בין המאפיינים קובעים את השדות המקומיים והצימודים של המילטוניאן של זכוכית ספין. הדינמיקה הקונטרא-דיאבטית מקדמת את המערכת הקוונטית אל מצבי האנרגיה הנמוכה שלה, וערכי התצפית החד-גופיים והדו-גופיים שנמדדים בסוף הופכים למאפיינים החדשים שעברו טרנספורמציה קוונטית. המאפיינים האלה לוכדים מתאמים לא-ליניאריים בין הקלטים, ואפשר להזין אותם לכל מודל קלאסי.
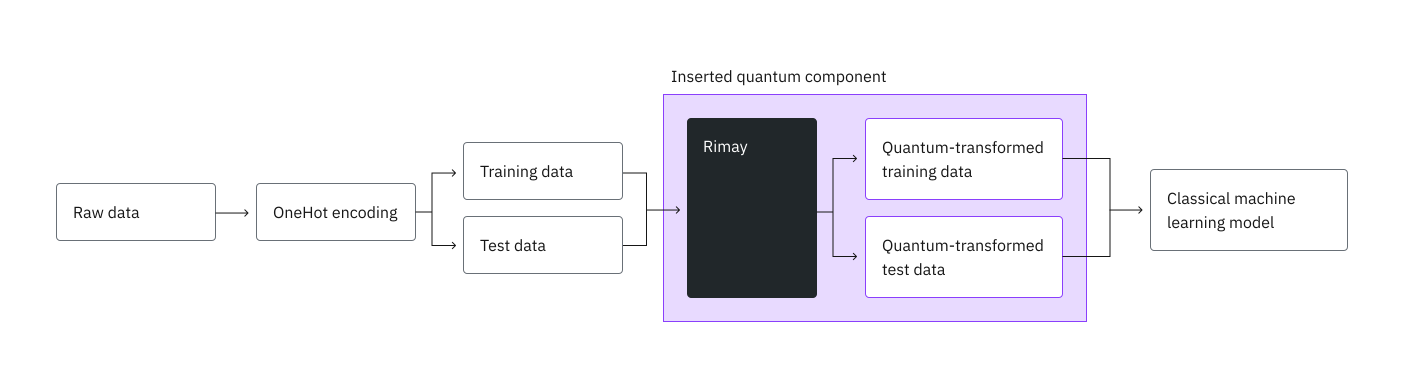
המדריך הזה משתמש במערך הנתונים German credit מ-OpenML [2], עם 1000 מבקשים ו-20 מאפיינים, כדי לאמן מסווג יער אקראי. קודם מגדירים קו בסיס קלאסי, אחר כך שולחים את הנתונים ל-Rimay, ולבסוף מאמנים את אותו סוג מודל על המאפיינים שעברו טרנספורמציה קוונטית, גם לבדם וגם בשילוב עם המאפיינים המקוריים.
דרישות
לפני שמתחילים את המדריך הזה, ודאו שהחבילות הבאות מותקנות:
-
לקוח IBM Quantum Compute (
pip install qiskit-ibm-runtime) -
Qiskit Functions (
pip install qiskit-ibm-catalog) -
scikit-learn (
pip install scikit-learn) -
pandas (
pip install pandas) -
Matplotlib (
pip install matplotlib)
בנוסף, צריך גישה לפונקציית Rimay מתוך Qiskit Functions Catalog.
הגדרה
מייבאים את החבילות ומגדירים שני עוזרים: אחד שמאמן יער אקראי, ואחד שמחשב את המדדים שבהם משתמשים לאורך המדריך.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"matplotlib": "matplotlib", "numpy": "numpy", "pandas": "pandas", "qiskit_ibm_catalog": "qiskit-ibm-catalog", "sklearn": "scikit-learn"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
import matplotlib.pyplot as plt
import numpy as np
import pandas as pd
from qiskit_ibm_catalog import QiskitFunctionsCatalog
from sklearn.datasets import fetch_openml
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import (
    accuracy_score,
    f1_score,
    precision_score,
    recall_score,
    roc_auc_score,
)
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import OneHotEncoder

def train_random_forest(x, y, n_estimators, max_depth):
    """Train a random forest classifier with fixed hyperparameters."""
    model = RandomForestClassifier(
        n_estimators=n_estimators,
        max_depth=max_depth,
        min_samples_split=5,
        min_samples_leaf=1,
        max_features="sqrt",
        random_state=42,
        n_jobs=-1,
    )
    return model.fit(x, y)

def evaluate(model, x, y):
    """Return the classification metrics of a trained model on a test set."""
    y_pred = model.predict(x)
    y_proba = model.predict_proba(x)[:, 1]
    return {
        "Accuracy": accuracy_score(y, y_pred),
        "AUC": roc_auc_score(y, y_proba),
        "F1 score": f1_score(y, y_pred),
        "Precision": precision_score(y, y_pred),
        "Recall": recall_score(y, y_pred),
    }
הגדרת האישורים של IBM Quantum
מתחברים עם מפתח ה-API של IBM Quantum Platform, טוענים את פונקציית Rimay, ובוחרים את מעבד הקוונטים הכי פנוי שזמין למופע שלכם.
catalog = QiskitFunctionsCatalog(channel="ibm_quantum_platform")
rimay = catalog.load("kipu-quantum/rimay")

backend = catalog.least_busy(operational=True, simulator=False)
print(backend.name, backend.num_qubits)
ibm_fez 156
שלב 1: מיפוי קלטים קלאסיים לבעיה קוונטית
Rimay ממפה כל מאפיין קלט מספרי ל-qubit אחד, ולכן הצעד הראשון הוא להפוך את הטבלה הגולמית למאפיינים מספריים.
טעינת מערך הנתונים
טוענים את מערך הנתונים German credit ישירות מ-OpenML. העמודה class מכילה את התווית: good למבקשים שהחזירו את האשראי שלהם ו-bad לאלה שלא.
df = fetch_openml(data_id=31, as_frame=True).frame
print(df.shape)
df.head()
(1000, 21)
checking_status  duration                  credit_history  \
0              <0         6  critical/other existing credit
1        0<=X<200        48                   existing paid
2     no checking        12  critical/other existing credit
3              <0        42                   existing paid
4              <0        24              delayed previously

               purpose  credit_amount    savings_status employment  \
0             radio/tv           1169  no known savings        >=7
1             radio/tv           5951              <100     1<=X<4
2            education           2096              <100     4<=X<7
3  furniture/equipment           7882              <100     4<=X<7
4              new car           4870              <100     1<=X<4

   installment_commitment     personal_status other_parties  ...  \
0                       4         male single          none  ...
1                       2  female div/dep/mar          none  ...
2                       2         male single          none  ...
3                       2         male single     guarantor  ...
4                       3         male single          none  ...

   property_magnitude age  other_payment_plans   housing existing_credits  \
0         real estate  67                 none       own                2
1         real estate  22                 none       own                1
2         real estate  49                 none       own                1
3      life insurance  45                 none  for free                1
4   no known property  53                 none  for free                2

                  job num_dependents  own_telephone foreign_worker class
0             skilled              1            yes            yes  good
1             skilled              1           none            yes   bad
2  unskilled resident              2           none            yes  good
3             skilled              2           none            yes  good
4             skilled              2           none            yes   bad

[5 rows x 21 columns]
קידוד המאפיינים
ממירים את התווית לערך בינארי, ומבצעים קידוד one-hot ל-13 העמודות הקטגוריאליות. הקוד מוריד את הקטגוריה הראשונה של כל עמודה כדי להימנע ממאפיינים מיותרים, וכך מתקבלים 48 מאפיינים מספריים.
y = (df["class"] == "good").astype(int)

features = df.drop(columns="class")
categorical_cols = [
    col for col in features.columns if features[col].dtype.name == "category"
]
encoder = OneHotEncoder(
    sparse_output=False, handle_unknown="ignore", drop="first"
)
encoded = pd.DataFrame(
    encoder.fit_transform(features[categorical_cols]),
    columns=encoder.get_feature_names_out(categorical_cols),
    index=features.index,
)
x = pd.concat([features.drop(columns=categorical_cols), encoded], axis=1)
print(f"{x.shape[1]} features")
48 features
פיצול לקבוצות אימון ובדיקה
שומרים 20% מהמבקשים בצד כקבוצת בדיקה. פיצול מרובד (stratified) שומר על אותו חלק של אשראי טוב ורע בשתי הקבוצות.
x_train, x_test, y_train, y_test = train_test_split(
    x, y, test_size=0.2, random_state=42, stratify=y
)
print(f"Training set: {x_train.shape}, test set: {x_test.shape}")
Training set: (800, 48), test set: (200, 48)
הגדרת קו בסיס קלאסי
מאמנים יער אקראי על המאפיינים הקלאסיים. בשלב 4 משווים את המאפיינים שעברו טרנספורמציה קוונטית למדדים שלו.
baseline = train_random_forest(
    x_train, y_train, n_estimators=500, max_depth=12
)
results = {"Classical": evaluate(baseline, x_test, y_test)}
pd.DataFrame(results).T
Accuracy       AUC  F1 score  Precision    Recall
Classical     0.765  0.781071  0.845902   0.781818  0.921429
העלאת הנתונים ל-Rimay
Rimay קוראת את הקלטים שלה מקובצי CSV שמעלים לפונקציה. המאפיינים והתוויות נכנסים לקבצים נפרדים. מעלים גם את קבוצת הבדיקה, כדי ש-Rimay תמפה אותה באותו מיפוי שהותאם על קבוצת האימון.
x_train.to_csv("x_train.csv", index=False)
y_train.to_csv("y_train.csv", index=False)
x_test.to_csv("x_test.csv", index=False)

for file_name in ("x_train.csv", "y_train.csv", "x_test.csv"):
    catalog.file_upload(file_name, rimay)
שלב 2: אופטימיזציה של הבעיה להרצה על חומרה קוונטית
Rimay בונה ועושה transpile למעגלים עבור המעבד שבחרתם, ולכן אין מעגל לבצע לו אופטימיזציה ידנית. מציינים את מספר ה-shots לכל מעגל, בכפוף למגבלות הבאות:
-
כל מאפיין צריך qubit אחד, ולכן במעבד חייבים להיות לפחות כמה qubits שיש מאפיינים במערך הנתונים.
-
Rimay מריצה מעגל אחד לכל שורה, שורות אימון ובדיקה יחד. משימה אחת יכולה לבקש לכל היותר 10 מיליון הרצות, ולכן מספר השורות כפול
shotsחייב להישאר בתוך התקציב הזה.
בודקים את שתי המגבלות לפני ששולחים את המשימה.
משימה חייבת גם להסתיים בתוך 24 שעות, כולל הזמן שהמעגלים שלה ממתינים בתור, אחרת היא נעצרת בלי תוצאה.
shots = 5000

n_rows = len(x_train) + len(x_test)
n_features = x_train.shape[1]
print(f"Qubits needed: {n_features} of {backend.num_qubits} available")
print(f"Executions: {n_rows * shots:,} of 10,000,000 allowed")
Qubits needed: 48 of 156 available
Executions: 5,000,000 of 10,000,000 allowed
חישוב גודל הפונקציה
כל משימה רצה בגודל פונקציה, S, M או L, שקובע את משאבי החישוב שעליהם היא רצה. ב-Rimay הגודל תלוי במספר השורות שהמשימה ממפה, שורות אימון ובדיקה יחד. אם מבקשים גודל קטן מדי, המשימה נכשלת עם שגיאה 4600. לגדלים ולמגבלות שלהם, ראו Function sizes במדריך של Rimay.
התא הבא מגדיר את מחשבון הגודל. הוא רץ על המחשב שלכם, קורא רק את הנתונים שמעבירים אליו, ולא שולח כלום.
from os import PathLike
from typing import Any, Literal, Sequence, Sized

Size = Literal["S", "M", "L"]

# Upper bounds (inclusive) in samples.
_SMALL = 2_999
_MEDIUM = 9_999

FIT_TRANSFORM, TRANSFORM, DELETE = "fit-transform", "transform", "delete"

# Which positions of input_file hold samples, per mode. The labels in
# y_train submit no circuits of their own, so they are not counted.
SAMPLE_POSITIONS = {FIT_TRANSFORM: (0, 2), TRANSFORM: (0,)}

def calculate_function_size(problem: Sequence[Sized], **kwargs: Any) -> Size:
    """Return the size ("S", "M" or "L") required to run the function."""
    metrics = _measure(problem, **kwargs)
    if _is_small(metrics):
        return "S"
    if _is_medium(metrics):
        return "M"
    return "L"

def _measure(problem: Sequence[Sized], **kwargs: Any) -> dict:
    """The samples the job submits."""
    return {"samples": count_samples(problem, kwargs.get("mode"))}

def count_samples(problem: Sequence[Sized], mode: Any) -> int:
    """Rows across the data sets of ``problem`` that carry samples."""
    if mode == DELETE:
        return 0
    if mode not in SAMPLE_POSITIONS:
        raise ValueError(f"cannot size mode {mode!r}")
    if _is_name(problem) or (
        isinstance(problem, (list, tuple))
        and any(_is_name(data) for data in problem)
    ):
        raise TypeError(
            "pass the data, not the file name: read each input_file, e.g. with "
            "pandas.read_csv, and pass the data sets in input_file order"
        )
    if not isinstance(problem, (list, tuple)):
        raise TypeError(
            "pass a list of data sets in input_file order, e.g. [x_train, y_train], "
            f"not a single {type(problem).__name__}"
        )
    return sum(
        len(problem[i]) for i in SAMPLE_POSITIONS[mode] if i < len(problem)
    )

def _is_name(value: Any) -> bool:
    """A file name or path rather than data."""
    return isinstance(value, (str, bytes, PathLike))

def _is_small(metrics: dict) -> bool:
    """Determine if the metrics fit T-size 'S'."""
    return metrics["samples"] <= _SMALL

def _is_medium(metrics: dict) -> bool:
    """Determine if the metrics fit T-size 'M'."""
    return metrics["samples"] <= _MEDIUM
מעבירים את מערכי הנתונים באותו סדר כמו הקבצים ב-input_file, יחד עם מצב ההרצה:
size = calculate_function_size(
    [x_train, y_train, x_test], mode="fit-transform"
)
print(size)
S
שלב 3: הרצה באמצעות primitives של Qiskit
מריצים את Rimay במצב fit-transform. היא מתאימה מיפוי מאפיינים קוונטי על x_train.csv ו-y_train.csv, וממפה בעזרתו גם את קבוצת האימון וגם את קבוצת הבדיקה. סדר הקבצים ב-input_file חשוב. מפרטים קודם את מאפייני האימון, אחר כך את תוויות האימון, ואז את מאפייני הבדיקה האופציונליים. מעבירים את הגודל שחישבתם בתור function_size.
job = rimay.run(
    mode="fit-transform",
    input_file=[
        "x_train.csv",
        "y_train.csv",
        "x_test.csv",
    ],  # This order matters
    backend_name=backend.name,
    shots=shots,
    function_size=size,
)
print(job.job_id)
de5094df-bb17-4924-9605-d6196a4aa999
מעקב אחרי המשימה
בודקים את סטטוס המשימה בזמן שהיא רצה. job.result() חוסם עד שהמשימה מסתיימת.
print(job.status())
INITIALIZING
result = job.result()
print(result["output_files"])
['de5094df-bb17-4924-9605-d6196a4aa999_xq_train.csv', 'de5094df-bb17-4924-9605-d6196a4aa999_xq_test.csv']
התוצאה כוללת mapping_id, שמזהה את המיפוי שההרצה הזאת התאימה. אתם לא צריכים אותו במדריך הזה, כי קבוצת הבדיקה מופתה באותה הרצה. שמרו את המזהה הזה אם אתם רוצים למפות שורות חדשות מאוחר יותר עם mode="transform". זו הדרך היחידה לגשת למיפוי שהותאם, ובלעדיו תצטרכו להתאים ולשלם על מיפוי חדש. המיפוי נבנה לפריסת ה-qubits של המעבד הזה, ולכן הרצת transform מאוחרת יותר חייבת להעביר את אותו backend_name.
mapping_id = result["mapping_id"]
שלב 4: עיבוד לאחר והחזרת התוצאה בפורמט הקלאסי הרצוי
הורדת המאפיינים שעברו טרנספורמציה קוונטית
מורידים את הקבצים שהמשימה כתבה, לפי השמות ב-output_files. כל שם מתחיל במזהה המשימה, כך שהקבצים של ההרצה הזאת נשארים זמינים גם אחרי הרצות מאוחרות יותר. מעבירים target_name כדי שכל קובץ יישמר בשם שלו.
train_file, test_file = result["output_files"]
for file_name in (train_file, test_file):
    catalog.file_download(file_name, rimay, target_name=file_name)

xq_train = pd.read_csv(train_file).to_numpy()
xq_test = pd.read_csv(test_file).to_numpy()
print(f"Quantum-transformed features: {xq_train.shape[1]}")
586kiB [00:00, 1.13MiB/s]
147kiB [00:00, 336kiB/s]
Quantum-transformed features: 99
אימון על המאפיינים שעברו טרנספורמציה קוונטית
מאמנים יער אקראי על המאפיינים שעברו טרנספורמציה קוונטית בלבד.
quantum = train_random_forest(
    xq_train, y_train, n_estimators=900, max_depth=15
)
results["Quantum"] = evaluate(quantum, xq_test, y_test)
אימון על מאפיינים קלאסיים וקוונטיים יחד
מחברים את המאפיינים המקוריים ואת אלה שעברו טרנספורמציה קוונטית, ומאמנים את אותו מודל על השילוב.
xh_train = np.hstack([x_train.to_numpy(), xq_train])
xh_test = np.hstack([x_test.to_numpy(), xq_test])

hybrid = train_random_forest(
    xh_train, y_train, n_estimators=900, max_depth=15
)
results["Hybrid"] = evaluate(hybrid, xh_test, y_test)
השוואת התוצאות
משווים את שלושת המודלים על קבוצת הבדיקה.
comparison = pd.DataFrame(results).T
print(comparison.round(3))

comparison[["Accuracy", "AUC", "F1 score"]].T.plot.bar(rot=0, figsize=(8, 4))
plt.ylim(0.5, 1.0)
plt.ylabel("Score on the test set")
plt.title("Random forest on classical, quantum, and hybrid features")
plt.show()
Accuracy    AUC  F1 score  Precision  Recall
Classical     0.765  0.781     0.846      0.782   0.921
Quantum       0.730  0.784     0.827      0.750   0.921
Hybrid        0.730  0.791     0.825      0.756   0.907

ה-AUC מודד כמה טוב המודל מדרג אשראי טוב מעל אשראי רע, בלי תלות בסף החלטה, ולכן הוא המדד המאפיין ביותר במערך נתונים לא מאוזן כזה (70% אשראי טוב). בבנצ'מרקים של Kipu Quantum, המאפיינים שעברו טרנספורמציה קוונטית הגיעו לבדם ל-AUC דומה לקו הבסיס הקלאסי, והמודל ההיברידי, ששילב את שניהם, הגיע ל-AUC ולציון F1 הגבוהים ביותר. כלומר, המאפיינים שעברו טרנספורמציה קוונטית מוסיפים מידע שהמאפיינים הקלאסיים לא מספקים לבדם.
ניקוי (אופציונלי)
מיפוי שהותאם נשאר זמין עד שמוחקים אותו. אם אתם לא רוצים למפות איתו נתונים נוספים, מחקו אותו. מחיקה לא מבצעת עבודה קוונטית, לא משתמשת בזמן QPU, ואי אפשר לבטל אותה.
# rimay.run(mode="delete", mapping_id=mapping_id).result()
{'output_files': [],
 'mode': 'delete',
 'deleted': True,
 'mapping_id': 'eUCy4EnZM7G9jYo5b2Pu-TuCXK7zX_wPTT67g9J1dVE',
 'metadata': {'version': '0.6.0', 'resource_usage': {}}}
סיכום
מה השגתם
במדריך הזה השגתם את הדברים הבאים:
-
הכנתם מערך נתונים אמיתי של סיכון אשראי, עם מאפיינים קטגוריאליים ומספריים, לחילוץ מאפיינים קוונטי.
-
הגדרתם קו בסיס של יער אקראי קלאסי.
-
השתמשתם ב-Rimay כדי להתאים מיפוי מאפיינים קוונטי על חומרה קוונטית ולמפות את קבוצות האימון והבדיקה בהרצה אחת.
-
אימנתם את אותו מודל על מאפיינים שעברו טרנספורמציה קוונטית ועל מאפיינים משולבים, והשוואתם אותם לקו הבסיס.
נקודות עיקריות
-
Rimay משתלבת בצינור למידת מכונה קיים כשלב עיבוד מקדים נוסף. הכנת הנתונים והמודל הקלאסי שלכם נשארים כמו שהם.
-
מספר ה-qubits מגביל את מספר מאפייני הקלט, ומספר השורות כפול
shotsמגביל את גודל משימה בודדת. -
השתמשו כברירת מחדל במאפיינים שעברו טרנספורמציה קוונטית בשילוב עם המאפיינים המקוריים, כי המודל יכול להשתמש בשניהם.
הצעדים הבאים
- קראו את המדריך של Rimay כדי להכיר את כל הקלטים, למפות נתונים חדשים עם
mode="transform"ולראות בנצ'מרקים נוספים. - קראו איך חילוץ מאפיינים קוונטי יושם בסיווג תמונות לוויין [3].
מקורות
[1] Simen, A., et al. (2025). Digitized Counterdiabatic Quantum Feature Extraction. arXiv preprint arXiv:2510.13807.
[2] Hofmann, H. (1994). Statlog (German Credit Data). OpenML dataset 31.
[3] Zhang, Q., et al. (2026). Quantum-enhanced satellite image classification. arXiv preprint arXiv:2602.18350.