Rimay Quantum Feature Extraction - Qiskit Function של Kipu Quantum
ראה את מדריך ה-API.
Qiskit Functions הן תכונה ניסיונית הזמינה רק למשתמשי תוכנית Premium, תוכנית Flex ותוכנית On-Prem (דרך IBM Quantum Platform API) של IBM Quantum®. הן נמצאות בשלב גרסת תצוגה מקדימה ועשויות להשתנות.
סקירה כללית
Rimay מעשירה צינורות למידת מכונה קלאסיים במאפיינים שנוצרים בחומרה קוונטית. הפונקציה מקבלת נתונים טבלאיים קלאסיים ומחזירה קבוצה של מאפיינים שעברו טרנספורמציה קוונטית. כשמערכת קוונטית מעבדת את הנתונים, היא מייצרת מאפיינים עשירים שלוכדים קשרים לא-ליניאריים בין הקלטים. אפשר להשתמש במאפיינים שנוצרו בפני עצמם, או בשילוב עם המאפיינים המקוריים שלך, כדי לאמן כל מודל קלאסי. במערכי נתונים קטנים ובינוניים, מאפיינים שעברו טרנספורמציה קוונטית יכולים לשפר את איכות החיזוי בהשוואה לקווי בסיס קלאסיים גרידא.
הפונקציה הזו נבנתה למשתמשים הבאים:
-
צוותי מדעי נתונים עם צינור למידת מכונה קיים על מערכי נתונים טבלאיים קטנים ובינוניים, שבהם איכות החיזוי הגיעה למישור. אתה מוסיף את Rimay כשלב עיבוד מקדים נוסף, בלי לבנות בעצמך שום מעגלים קוונטיים.
-
חוקרים שבוחנים שיטות קוונטיות למשימות למידת מכונה.
תיאור
אלגוריתם חילוץ המאפיינים הקוונטי [1] משלב שני עקרונות של למידת מכונה קוונטית. הראשון הוא מפות מאפיינים קוונטיות (quantum feature maps), שמשכנות נתונים במרחב הילברט בעל ממד גבוה ולכן יוצרות ייצוגים עשירים יותר. השני הוא חישוב מאגר קוונטי (quantum reservoir computing), שמשתמש בדינמיקה של מערכת קוונטית מרובת גופים כהמרה לא ליניארית של הקלט.
Rimay מקודד את ערכי המאפיינים ואת האינפורמציה ההדדית בין המאפיינים לתוך השדות המקומיים ומקדמי הצימוד של המילטוניאן של זכוכית ספין. דינמיקה קוונטית קונטרה-אדיאבטית מובילה את המערכת אל מצבי האנרגיה הנמוכה שלה, שמכילים תערובות לא ליניאריות של המתאמים בנתוני הקלט. Rimay מחלץ את המתאמים האלה באמצעות מדידת ערכי תצפית של גוף אחד ושל שני גופים. ערכי התצפית הם המאפיינים שעברו המרה קוונטית, ואותם מזינים למודל למידת המכונה שלכם.
תהליך העבודה
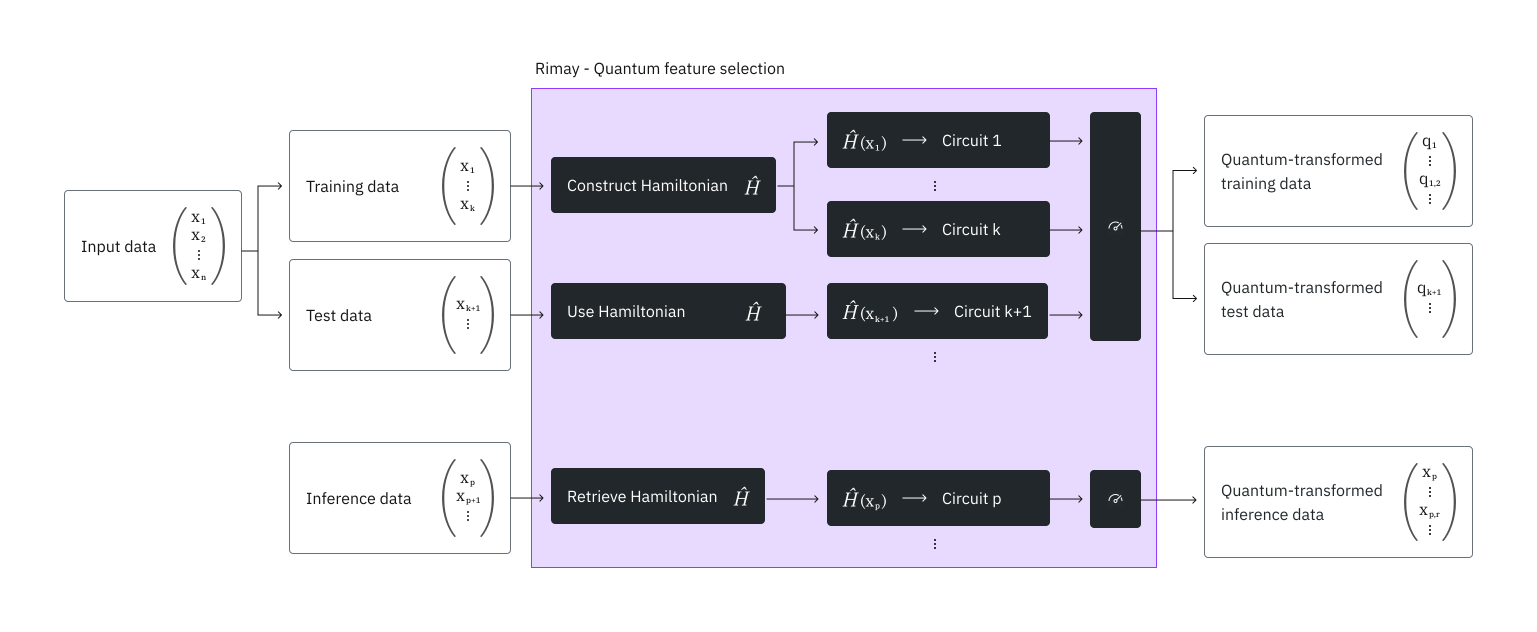
-
עבדו את הנתונים הטבלאיים מראש כמו בלמידת מכונה קלאסית. Rimay דורש מאפיינים מספריים, אז המירו מאפיינים קטגוריאליים למספריים, למשל באמצעות
OneHotEncoderשל scikit-learn. -
חלקו את הנתונים לקבוצת אימון ולקבוצת בדיקה, והעלו את שתיהן לפונקציה, כפי שמוצג בסעיף דוגמה.
-
Rimay משתמש בנתוני האימון כדי לבנות את ההמילטוניאן שמייצג את הנתונים. כל מאפיין מתאים ל-qubit אחד, וקבוצת האימון המלאה קובעת אילו מאפיינים, ולכן אילו qubits, מקיימים אינטראקציה. Rimay שומר את המבנה הזה כדי למפות את נתוני הבדיקה ונתוני ההסקה המאוחרים באמצעות אותו המילטוניאן.
-
לכל דגימה, ערכי המאפיינים קובעים את השדות המקומיים של ההמילטוניאן, והאינפורמציה ההדדית בין המאפיינים קובעת את מקדמי הצימוד של המבנה משלב 3. Rimay הופך את ההתפתחות הקונטרה-אדיאבטית של ההמילטוניאן הזה למעגל דיגיטלי, ומריץ את המעגלים על ה-QPU.
-
Rimay מודד את מחרוזות הביטים שהתקבלו, ואז מחשב את ערכי התצפית של גוף אחד ואת ערכי התצפית של שני גופים עבור qubits שמצומדים פיזית.
-
אתם מורידים את ערכי התצפית בצורה שאפשר להזין ישירות למודל שלכם, או לשלב עם המאפיינים המקוריים.
בגלל המבנה הזה, מספר ה-qubits שהרצה צריכה שווה למספר המאפיינים, ומספר המעגלים שהיא שולחת שווה למספר הדגימות.
אחרי שהתאמתם מיפוי, אפשר למפות דרכו נתונים חדשים, למשל לצורך הסקה. Rimay אז שולף את ההמילטוניאן שיצר בזמן ההתאמה ובונה ממנו את המעגלים עבור הדגימות החדשות.
שילוב Rimay בצינור למידת המכונה שלכם
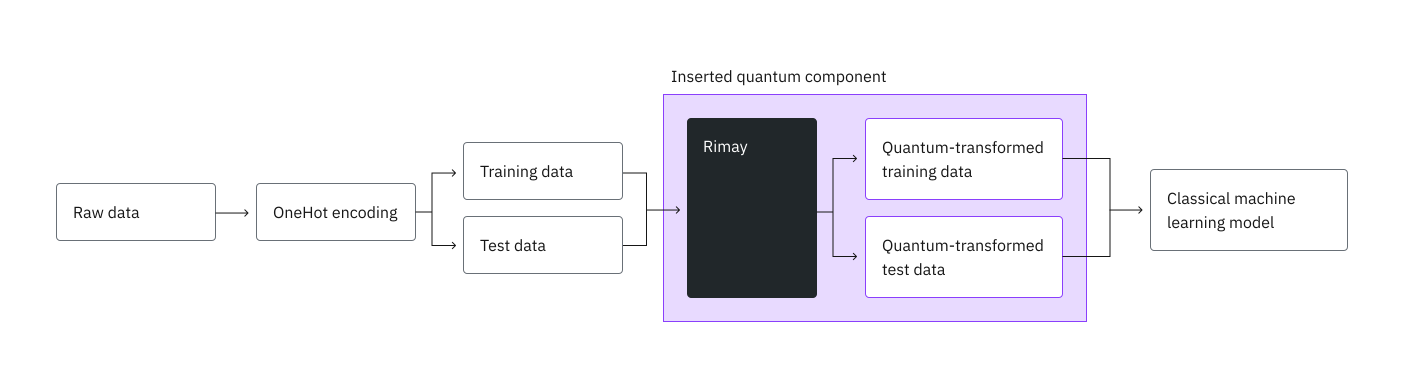
כמו בצינור קלאסי, מתחילים בעיבוד מקדים של נתוני הגלם, למשל קידוד one-hot של המאפיינים הקטגוריאליים, ומחלקים אותם לקבוצת אימון ולקבוצת בדיקה. במקום להזין את שתי הקבוצות ישירות למודל, מזינים אותן קודם ל-Rimay, ומאמנים את המודל על המאפיינים שעברו המרה קוונטית.
מבחני ביצועים
Kipu Quantum בדקה את Rimay על מערך הנתונים German credit מ-OpenML [2], שמסווג 1000 מבקשי אשראי כבעלי סיכון אשראי טוב או רע. יש בו 13 תכונות קטגוריאליות ושבע תכונות מספריות. קידוד one-hot של התכונות הקטגוריאליות מניב 48 מאפיינים מספריים. במבחן הושארו בצד 20% מהדגימות כקבוצת הבדיקה.
כבסיס להשוואה אומנו כמה מודלים קלאסיים על המאפיינים הקלאסיים. עם Rimay אומן יער אקראי בשתי דרכים: על המאפיינים שעברו המרה קוונטית בלבד (Random forest Q), ועל המאפיינים שעברו המרה קוונטית בשילוב המאפיינים הקלאסיים (Random forest H, עבור היברידי). הטבלה מציגה רק את היער האקראי, כי הוא הציג את הביצועים הטובים ביותר על המאפיינים שעברו המרה קוונטית.
| מודל | מאפיינים | דיוק | AUC | ציון F1 | Precision | Recall |
|---|---|---|---|---|---|---|
| CatBoost | קלאסי | 0.775 | 0.781 | 0.850 | 0.795 | 0.914 |
| יער אקראי | קלאסי | 0.765 | 0.781 | 0.846 | 0.782 | 0.921 |
| XGBoost | קלאסי | 0.760 | 0.758 | 0.835 | 0.803 | 0.871 |
| LightGBM | קלאסי | 0.770 | 0.751 | 0.840 | 0.818 | 0.864 |
| Random forest Q | קוונטי | 0.750 | 0.793 | 0.840 | 0.762 | 0.936 |
| Random forest H | היברידי | 0.770 | 0.798 | 0.854 | 0.770 | 0.957 |
המאפיינים ההיברידיים משפרים את כל המדדים של היער האקראי חוץ מ-Precision, והיער האקראי ההיברידי מגיע ל-AUC, לציון F1 ול-Recall גבוהים יותר מ-CatBoost על המאפיינים הקלאסיים. ההשפעה הגדולה ביותר היא על ה-Recall, שעולה מ-0.921 ל-0.957. המאפיינים שעברו המרה קוונטית בלבד לא מגיעים ל-Precision של המודלים הקלאסיים.
קבוצת הבדיקה מכילה רק 200 דגימות, ולכן חיזוי נכון של דגימה אחת נוספת משנה את הדיוק ב-0.005. קראו את ההבדלים כמגמה שדורשת אימות נוסף, ולא כהשפעה מובהקת. דיוק החיזוי יכול להיות תלוי גם ברעש שמקורו בחומרה במאפיינים שחולצו. לכן השתמשו במספר מספיק של shots כך שרעש ה-shots לא יגביל את התוצאה.
במבחן נעשה שימוש במשאבים הבאים:
| דוגמה | מספר qubits | מספר דגימות | מספר shots | זמן כולל (דקות) | שימוש ב-QPU (דקות) | מעבד |
|---|---|---|---|---|---|---|
| German credit | 48 | 1000 | 5000 | 23 | 22 | ibm_boston |
| German credit | 48 | 1000 | 5000 | 3 | 2 | ibm_phoenix |
מספר הדגימות, שהוא מספר המעגלים, קובע את זמן ה-QPU. השתמשו בסוג המעבד Nighthawk r2, כי הוא מקטין מאוד את זמן ה-QPU הנדרש.
קלטים
ה-mode קובע אילו פרמטרים הרצה צריכה. לתיאור של כל פרמטר קלט, ראו את מסמך ה-API.
קובצי קלט
-
העלו כל קובץ באמצעות
catalog.file_upload()לפני שאתם מריצים את הפונקציה. -
העלאה מחליפה כל קובץ קודם באותו שם, גם עבור משימה ששלחתם אך עוד לא התחילה. כדי להריץ כמה משימות במקביל, תנו לקבצים של כל משימה שמות משלהם, למשל
run1_x_train.csvו-run2_x_train.csv. -
כל קובץ הוא קובץ CSV עם שורת כותרת. כל עמודה בקובץ מאפיינים היא מאפיין אחד, וכל ערך חייב להיות מספרי.
-
y_trainמכיל עמודה מספרית אחת בדיוק, עם תווית אחת לכל שורה שלx_train. מפו תוויות קטגוריאליות למספרים, למשל good ו-bad ל-1 ול-0. -
ל-
x_testול-x_inferenceחייבות להיות אותן עמודות כמו ל-x_train, באותו סדר.
ה-mapping_id הוא הדרך היחידה להגיע למיפוי שההתאמה שלכם יצרה, ואי אפשר לחפש או לשחזר אותו. הוא מאשר שימוש במיפוי הזה, ולכן התייחסו אליו כמו אל אישור גישה ואל תשתפו אותו. אם איבדתם אותו, תצטרכו להתאים מיפוי חדש, וזה עולה עוד הרצה על חומרה קוונטית. כמו כן שמרו את ה-backend_name של ההתאמה, כי המיפוי רץ רק על המעבד הזה.
מגבלות
-
כל מאפיין ממופה ל-qubit אחד, ולכן במעבד חייבים להיות לפחות כמה qubits שיש מאפיינים בנתונים שלכם. אם יש לכם יותר מאפיינים מזה, צמצמו אותם קודם בטכניקת בחירת מאפיינים.
-
כל דגימה הופכת למעגל אחד, והרצה סופרת יחד דגימות אימון ובדיקה. הרצה יכולה להכיל לכל היותר 15,000 דגימות.
-
משימה אחת יכולה לבקש לכל היותר 10 מיליון הרצות, ולכן מספר הדגימות כפול
shotsלא יכול לעבור 10 מיליון. -
משימה חייבת להסתיים תוך 24 שעות, כולל הזמן שהמעגלים שלה ממתינים בתור של המעבד. משימה שרצה זמן רב יותר נעצרת בלי תוצאה. במעבד עמוס, שמרו על מערכי נתונים גדולים הרחק מתחת למגבלות האלה.
פלטים
job.result() מחזיר מילון. המאפיינים שעברו המרה קוונטית עצמם נכתבים לקובצי CSV שמורידים באמצעות catalog.file_download(). לתיאור של כל מפתח במילון, ראו את מסמך ה-API. לזמן שכל שלב הרצה לקח, ראו מטא-נתוני הרצה.
כל קובץ פלט מכיל שורה אחת לכל שורת קלט, בסדר של קובץ הקלט, ועמודה אחת לכל מאפיין שעבר המרה קוונטית. העמודות ששמותיהן מתחילים ב-corr_ הן ערכי התצפית של שני גופים. בקבצים אין עמודת תוויות. התוויות של נתוני האימון נשארות בקובץ y_train שלכם.
מטא-נתוני הרצה
resource_usage מכיל רשומה אחת לכל שלב הרצה שההרצה עברה: "RUNNING: MAPPING", "RUNNING: POST_PROCESSING", וב-QPU בדרך כלל גם "RUNNING: WAITING_FOR_QPU". כל רשומה מכילה את CPU_TIME, זמן השעון של השלב בשניות, ואת QPU_TIME, זמן ה-QPU בשניות. ב-QPU, זמן ה-QPU ש-IBM חייבה עליו נרשם תחת "RUNNING: MAPPING", השלב שבו המעגלים רצו.
"RUNNING: WAITING_FOR_QPU" הוא הזמן שהמשימות שלכם המתינו בתור של IBM. ההרצה לוקחת את הזמן הזה מחותמות הזמן של המשימות ב-IBM, ולא סופרת אותו ב-"RUNNING: MAPPING". אם IBM לא מדווחת על חותמות הזמן האלה עבור כל משימה, הרשומה חסרה וההמתנה נכללת ב-"RUNNING: MAPPING".
IBM® מסיימת את חישוב השימוש זמן מה אחרי שמשימה מסתיימת. ההרצה ממתינה לו עד כדקה. שימוש שעדיין מחושב אחרי הזמן הזה לא נכלל ב-QPU_TIME, והשימוש הסופי מוצג ב-IBM Quantum Platform. אם ההרצה לא מצליחה לקרוא את השימוש מ-IBM, QPU_TIME הוא None.
לדוגמה:
"metadata": {
    "version": "0.3.0",
    "resource_usage": {
        "RUNNING: MAPPING": {"CPU_TIME": 12.4, "QPU_TIME": 6.0},
        "RUNNING: WAITING_FOR_QPU": {"CPU_TIME": 28.8, "QPU_TIME": 0.0},
        "RUNNING: POST_PROCESSING": {"CPU_TIME": 0.3, "QPU_TIME": 0.0},
    },
}
תחילת העבודה
בצעו אימות באמצעות מפתח ה-API שלכם ב-IBM Quantum Platform, ובחרו את ה-Qiskit Function כך:
הקוד הבא מניח ששמרתם את פרטי הגישה שלכם. אם לא, עקבו אחר ההוראות ב-התקנת הלקוח של Qiskit Functions Catalog כדי לשמור את החשבון שלכם עם מפתח ה-API.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"pandas": "pandas", "qiskit_ibm_catalog": "qiskit-ibm-catalog"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
from qiskit_ibm_catalog import QiskitFunctionsCatalog

catalog = QiskitFunctionsCatalog(channel="ibm_quantum_platform")

# Verify that you have access to the function
catalog.list()
[QiskitFunction(kipu-quantum/rimay)]
# Access function
rimay = catalog.load("kipu-quantum/rimay")
גדלי הפונקציה
כל משימה רצה בגודל אחד — S, M או L. אם הגודל שצוין קטן מדי, המשימה נדחית. אם הגודל גדול מהנדרש, היא רצה על פרופיל חישוב גדול ממה שהעבודה דורשת.
הגודל של משימת Rimay תלוי במספר הדגימות שהיא ממפה: השורות של x_train ו-x_test עבור fit-transform, והשורות של x_inference עבור transform. התוויות ב-y_train לא נספרות, והרצת delete לא ממפה דגימות.
| גודל | דגימות למשימה | פרופיל חישוב | vCPU | RAM |
|---|---|---|---|---|
S | עד 2,999 | 8x32 | 8 | 32 GB |
M | 3,000 עד 9,999 | 8x32 | 8 | 32 GB |
L | 10,000 עד 15,000 | 16x128 | 16 | 128 GB |
מספר הדגימות הוא הקריטריון היחיד. גודל משנה רק את פרופיל החישוב: המגבלות על מאפיינים, דגימות ו-shots זהות לכל הגדלים. S ו-M רצים על אותו פרופיל חישוב ושונים במספר הדגימות שכל אחד מכסה.
ברירת המחדל היא M, והיא משמשת כשמשימה לא מבקשת גודל. לכן משימה של יותר מ-9,999 דגימות חייבת לבקש L.
אפשר גם לקרוא את המיפוי מהפונקציה עצמה באמצעות rimay.sizes_map, ואת הגודל שבו משימה רצה כשהיא לא מבקשת גודל באמצעות rimay.default_size.
חישוב הגודל לפני השליחה
הריצו את זה על הקלטים שלכם. זה רק קורא אותם ולא עושה דבר אחר: לא נשלחת משימה ושום דבר לא נשמר, אז אפשר לקרוא לזה כמה פעמים שרוצים.
העבירו את מערכי הנתונים עצמם, לא את שמות הקבצים, באותו סדר כמו input_file, יחד עם ה-mode של ההרצה. שלב 2 בדוגמה מראה את הקריאה.
from os import PathLike
from typing import Any, Literal, Sequence, Sized

Size = Literal["S", "M", "L"]

# Upper bounds (inclusive) in samples.
_SMALL = 2_999
_MEDIUM = 9_999

FIT_TRANSFORM, TRANSFORM, DELETE = "fit-transform", "transform", "delete"

# Which positions of input_file hold samples, per mode. The labels in
# y_train submit no circuits of their own, so they are not counted.
SAMPLE_POSITIONS = {FIT_TRANSFORM: (0, 2), TRANSFORM: (0,)}

def calculate_function_size(problem: Sequence[Sized], **kwargs: Any) -> Size:
    """Return the size ("S", "M" or "L") required to run the function."""
    metrics = _measure(problem, **kwargs)
    if _is_small(metrics):
        return "S"
    if _is_medium(metrics):
        return "M"
    return "L"

def _measure(problem: Sequence[Sized], **kwargs: Any) -> dict:
    """The samples the job submits."""
    return {"samples": count_samples(problem, kwargs.get("mode"))}

def count_samples(problem: Sequence[Sized], mode: Any) -> int:
    """Rows across the data sets of ``problem`` that carry samples."""
    if mode == DELETE:
        return 0
    if mode not in SAMPLE_POSITIONS:
        raise ValueError(f"cannot size mode {mode!r}")
    if _is_name(problem) or (
        isinstance(problem, (list, tuple))
        and any(_is_name(data) for data in problem)
    ):
        raise TypeError(
            "pass the data, not the file name: read each input_file, e.g. with "
            "pandas.read_csv, and pass the data sets in input_file order"
        )
    if not isinstance(problem, (list, tuple)):
        raise TypeError(
            "pass a list of data sets in input_file order, e.g. [x_train, y_train], "
            f"not a single {type(problem).__name__}"
        )
    return sum(
        len(problem[i]) for i in SAMPLE_POSITIONS[mode] if i < len(problem)
    )

def _is_name(value: Any) -> bool:
    """A file name or path rather than data."""
    return isinstance(value, (str, bytes, PathLike))

def _is_small(metrics: dict) -> bool:
    """Determine if the metrics fit T-size 'S'."""
    return metrics["samples"] <= _SMALL

def _is_medium(metrics: dict) -> bool:
    """Determine if the metrics fit T-size 'M'."""
    return metrics["samples"] <= _MEDIUM
אם הגודל קטן מדי, המשימה נכשלת עם שגיאה 4600 וההודעה מציינת באיזה גודל להשתמש במקום. אם הוא גדול מהנדרש, המשימה רצה כרגיל ורושמת אירוע ייעוץ 4601.
דוגמה
הדוגמה הזו מראה איך להעלות נתונים, להריץ את הפונקציה ולשלוף את המאפיינים שעברו המרה קוונטית. לדוגמה מקצה לקצה שכוללת את העיבוד המקדים ואת אימון המודל הקלאסי, ראו את המדריך.
1. העלאת הנתונים
הדוגמה הזו משתמשת במערך נתונים סינתטי קטן עם ארבעה מאפיינים מספריים ותווית בינארית, כך שהרצה צריכה רק ארבעה qubits ומסתיימת מהר. התא הבא כותב אותו לארבעה קובצי CSV: מאפייני האימון, תוויות האימון, מאפייני הבדיקה והמאפיינים לשלב 4 בדוגמה הזו. כדי להשתמש בנתונים שלכם, כתבו במקום זה את קבוצות האימון והבדיקה המעובדות שלכם לקבצים באותו מבנה.
from pathlib import Path

Path("x_train.csv").write_text("""f0,f1,f2,f3
0.7227,1.3355,1.9595,2.5562
0.2731,0.5779,0.8983,1.1624
0.1139,0.1817,0.2163,0.2426
0.0341,0.1311,0.0854,0.09
0.8996,1.6951,2.497,3.3407
0.9669,1.8906,2.7705,3.6569
0.6366,1.2821,1.8793,2.4602
0.7718,1.4979,2.2223,2.933
0.5465,1.1008,1.67,2.2195
0.9475,1.9423,2.8942,3.8199
0.8829,1.6842,2.4703,3.2865
0.0675,0.0365,0.0705,0.0162
""")
Path("y_train.csv").write_text("label\n1\n0\n0\n0\n1\n1\n0\n1\n0\n1\n1\n0\n")
Path("x_test.csv").write_text("""f0,f1,f2,f3
0.543,1.0786,1.5684,2.0607
0.9928,1.9037,2.9302,3.8422
0.2269,0.3637,0.4628,0.597
0.9896,1.9511,2.8913,3.8208
""")
Path("x_inference.csv").write_text("""f0,f1,f2,f3
0.2708,0.542,0.8506,1.0897
0.3585,0.6025,0.9517,1.2609
0.8871,1.6559,2.4577,3.2992
""")
95
העלו את קובצי האימון והבדיקה. את x_inference.csv מעלים בשלב 4.
for file_name in ("x_train.csv", "y_train.csv", "x_test.csv"):
    catalog.file_upload(file_name, rimay)
2. הרצת הפונקציה
חשבו את גודל ההרצה מהנתונים שהעליתם, באמצעות המחשבון מתוך גדלי הפונקציה.
import pandas as pd

x_train = pd.read_csv("x_train.csv")
y_train = pd.read_csv("y_train.csv")
x_test = pd.read_csv("x_test.csv")

size = calculate_function_size(
    [x_train, y_train, x_test], mode="fit-transform"
)
print(size)
S
בחרו מעבד עם לפחות כמה qubits שיש מאפיינים בנתונים שלכם, והריצו את הפונקציה במצב fit-transform עם הגודל הזה. בנתוני הדוגמה יש ארבעה מאפיינים, ולכן כל מעבד של IBM Quantum יכול להריץ אותם.
backend = catalog.least_busy(operational=True, simulator=False)

job = rimay.run(
    mode="fit-transform",
    input_file=["x_train.csv", "y_train.csv", "x_test.csv"],
    backend_name=backend.name,
    shots=5000,
    function_size=size,
)
print(job.job_id)
85dabc9f-a769-4f4a-8e92-f3be73f85ca2
בדקו את הסטטוס של עומס העבודה או החזירו תוצאות כך:
# Monitor the job status
job.status()
'DONE'
result = job.result()

# Keep both: the mapping_id is the only handle on the mapping this run
# fitted, and the mapping runs only on the processor it was fitted on.
mapping_id = result["mapping_id"]
fit_backend_name = result["backend_name"]
3. שליפת התוצאות
הורידו את המאפיינים שעברו המרה קוונטית. העבירו target_name כדי שכל קובץ יישמר בשם משלו.
for file_name in result["output_files"]:
    catalog.file_download(file_name, rimay, target_name=file_name)
693iB [00:00, 171kiB/s]
254iB [00:00, 111kiB/s]
4. מיפוי נתונים חדשים
אחרי שאימנתם את המודל, מפו נתונים חדשים עם המיפוי שהותאם, למשל כדי להריץ הסקה. הדוגמה הזו ממפה את x_inference.csv, שהתא הראשון בדוגמה כתב. העבירו את ה-mapping_id שההתאמה החזירה, כדי שהשורות החדשות ימופו עם אותו מיפוי ולא עם חדש.
מיפוי נבנה עבור פריסת ה-qubits של מעבד אחד, ולכן העבירו את אותו backend_name כמו בהתאמה, שההתאמה החזירה ב-result["backend_name"]. אל תשתמשו ב-least_busy() כדי לבחור את המעבד, כי הוא עלול להחזיר מעבד אחר. Rimay דוחה כל מעבד אחר לפני ששלח משהו. גם מספר ה-shots מגיע מההתאמה.
catalog.file_upload("x_inference.csv", rimay)

x_inference = pd.read_csv("x_inference.csv")
size = calculate_function_size([x_inference], mode="transform")

job = rimay.run(
    mode="transform",
    input_file=["x_inference.csv"],
    # The processor the mapping was fitted on
    backend_name=fit_backend_name,
    shots=5000,
    mapping_id=mapping_id,
    function_size=size,
)
# Monitor the job status
job.status()
'DONE'
result = job.result()

for file_name in result["output_files"]:
    catalog.file_download(file_name, rimay, target_name=file_name)
202iB [00:00, 73.5kiB/s]
5. מחיקת מיפוי
כשאתם כבר לא צריכים מיפוי שהותאם, מחקו אותו. הרצת delete לא עושה עבודה קוונטית, ולכן היא לא צריכה מעבד, shots או גודל פונקציה. אי אפשר לבטל מחיקה. אחרי המחיקה ה-mapping_id כבר לא מפנה לשום דבר, והרצת transform איתו נכשלת.
job = rimay.run(mode="delete", mapping_id=mapping_id)
job.result()
{'output_files': [],
 'mode': 'delete',
 'deleted': True,
 'mapping_id': '30L40joyUPYfnvgwo2d7MXXSzqvHkggR-Kzn81wfIYw',
 'metadata': {'version': '0.6.0', 'resource_usage': {}}}
שליפת הודעות שגיאה
אם הסטטוס של עומס העבודה שלכם הוא ERROR, השתמשו ב-job.error_message() כדי לשלוף את הודעת השגיאה, כך:
job = rimay.run(
    mode="fit-transform",
    input_file=["x_train.csv", "y_train.csv"],
    backend_name=backend.name,
    shots=0,
)
job.error_message()
כל שגיאה ש-Rimay מדווח עליה כוללת קוד מתוך קודי השגיאה של IBM Quantum, הודעה, ופתרון שמציין את הערך שהעברתם ואת הערך המותר. הטבלה הבאה מפרטת את השגיאות הנפוצות ביותר:
| קוד | סיבה |
|---|---|
1221 | פרמטר חסר או מסוג שגוי, mode לא תקין, קובץ שמופיע ב-input_file לא הועלה, הקבצים לא תואמים זה לזה, מאפיין אינו מספרי, או שה-mapping_id לא תואם למיפוי שמור. |
1221 | הרצת "transform" מציינת backend_name שונה מזה של ההתאמה שיצרה את המיפוי שלה. |
1216 | לאינסטנס שלכם אין מעבד עם ה-backend_name שהעברתם. הפתרון מפרט את המעבדים שיש לו. |
1200 | למפתח ה-API שלכם אין גישה לאינסטנס שהמשימה רצה תחתיו. |
3200 | backend_name לא מתחיל ב-ibm_. |
4500 | בנתונים יש יותר מאפיינים מ-qubits במעבד. |
6000 | מספר הדגימות כפול shots חורג מ-10 מיליון הרצות. |
6001 | shots קטן מ-1. |
6002 | בנתונים יש יותר דגימות ממה שהרצה מאפשרת. |
מקרי שימוש
בסיווג טבלאי על מערכי נתונים קטנים ובינוניים, Kipu Quantum יישמה חילוץ מאפיינים קוונטי על הנושאים הבאים:
מעבר לנתונים טבלאיים, רשתות נוירונים קפואות יכולות להמיר תמונות למאפיינים מספריים, ואז חילוץ המאפיינים הקוונטי ממפה אותם למאפיינים שעברו המרה קוונטית:
קבלת תמיכה
לתמיכה, פנו אל support@kipu-quantum.com.
השלבים הבאים
-
בקרו במסמך ה-API של ה-Qiskit Function הזו.
-
נסו את המדריך סיווג סיכון אשראי עם חילוץ המאפיינים הקוונטי Rimay של Kipu Quantum.
מקורות
[1] Simen, A., et al. (2025). Digitized Counterdiabatic Quantum Feature Extraction. arXiv preprint arXiv:2510.13807.
[2] Hofmann, H. (1994). Statlog (German Credit Data). OpenML dataset 31.
[3] Zhang, Q., et al. (2026). Quantum-enhanced satellite image classification. arXiv preprint arXiv:2602.18350.
מידע נוסף
Rimay היא מילה בשפת הקצ'ואה שפירושה "להסביר".