Parity Twine Optimizer: פונקציית Qiskit מבית ParityQC
ראו את הפניית ה-API
Qiskit Functions הן תכונה ניסיונית הזמינה רק למשתמשי התוכניות IBM Quantum® Premium Plan, Flex Plan ו-On-Prem (דרך IBM Quantum Platform API). הן נמצאות במעמד גרסה מקדימה (preview) וכפופות לשינויים.
סקירה כללית
Parity Twine Optimizer מאפשר למשתמשים לפתור בעיות אופטימיזציה במחשבים קוונטיים באמצעות שיטת Parity Twine. גישה זו, המבוססת על ארכיטקטורת Parity, משתמשת במהדר (compiler) של ParityQC כדי למזער את מספר השערים ואת עומק המעגל הנדרשים להרצת אלגוריתם קוונטי, תוך התחשבות בקישוריות ההתקן.
צמצום משאבים זה מאפשר פתרון בעיות אופטימיזציה רלוונטיות לתעשייה בגדלים שאינם ישימים בשיטות טרנספילציה סטנדרטיות, עתירות SWAP. Parity Twine Optimizer ממכן את שלבי הטרנספילציה באופן אוטומטי וניתן להשתמש בו עם מינימום קלט מהמשתמש.
גישת Parity Twine עולה על כל שיטות ההידור (compilation) האחרות מבחינת צמצום מספר השערים ועומק המעגלים עבור אלגוריתמים קוונטיים כגון quantum approximate optimization algorithm (QAOA) ו-quantum Fourier transform (QFT). על ידי הפשטת המידע הקוונטי מה-qubits הפיזיים, מיושמות אינטראקציות לא-מקומיות ללא שערי SWAP. במקום זאת, שרשראות Parity Twine (רצפים של שערי CNOT) מפזרות באופן שיטתי מידע זוגיות (parity) לוגי בין ה-qubits.
האופטימייזר משתמש ב-QAOA כדי למזער את האנרגיה של פונקציית עלות נתונה. QAOA הוא אלגוריתם וריאציוני היברידי קוונטי-קלאסי המיועד לפתור בעיות אופטימיזציה קומבינטורית על ידי קירוב מצב היסוד של המילטוניאן עלות (). איבר ערבוב () מניע מעברים בין מצבים כדי לחקור את מרחב הפתרונות. רצף מתחלף של איברים אלו, הנשלט על ידי הפרמטרים ו-, מגדיר את האופרטור היחידתי , הפועל על המצב ההתחלתי.
קידוד האופרטור היחידתי של הבעיה, exp(), מחייב קידוד של כל אופרטורי הסיבוב הלוגיים מסדר -גופים (exp()). ניתן להשיג זאת באמצעות מחוללי -גופים (רשתות Parity Twine), המצמצמים את עומק מעגל ה-QAOA ואת מספר שערי שני ה-qubits.
תיאור
קלט ה-Parity Twine Optimizer מורכב מבעיית אופטימיזציה, מהשם של חומרת ה-IBM Quantum שנבחרה, וממשתני קלט אופציונליים נוספים להתאמת הגדרות הטרנספילציה וההרצה על החומרה. פונקציית האופטימייזר מנתבת את הגדרת הבעיה אל מהדר ה-Parity Twine (Parity Twine Compiler). איור 1 מציג סיכום של זרימת העבודה של הפונקציה.
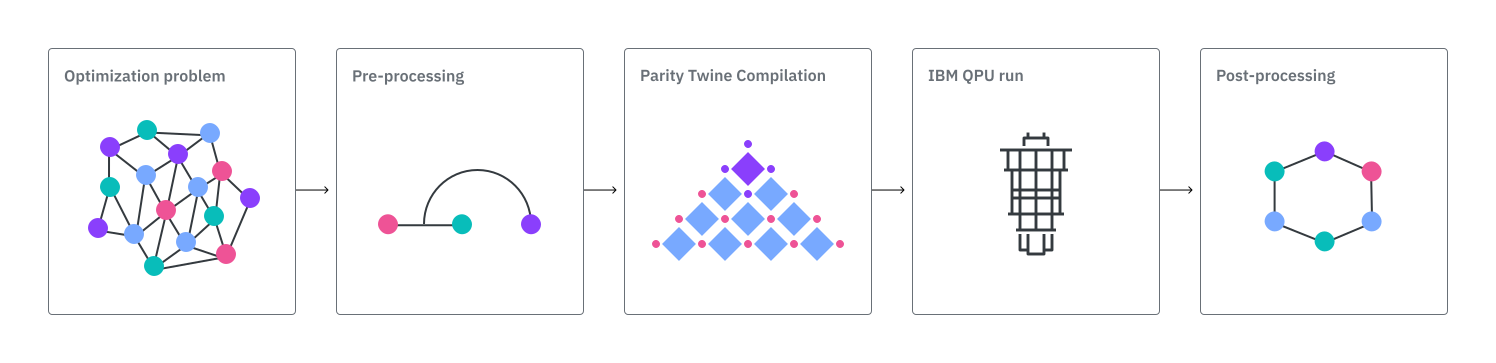
בעיית האופטימיזציה שבקלט עוברת עיבוד מקדים להמילטוניאן (מנורמל). לאחר מכן, מהדר ParityQC בונה מעגל אנזץ (ansatz) של Parity Twine עם פרמטרים, שעובר טרנספילציה (transpiled) לאנזץ לוגי התואם את סט השערים הטבעי של החומרה שנבחרה.
פרמטרי מעגל ה-QAOA מותאמים באופן קלאסי באמצעות הגישה "efficient depth one" ומוקצים למעגל שעבר טרנספילציה. מכיוון שנעשה שימוש בסיבוב יחיד של QAOA, פרמטרי ו- אופטימליים מתקבלים באמצעות חיפוש רשת (grid search) על CPU, ללא צורך באופטימיזציה איטרטיבית יקרה על פני קריאות מעגל רבות. הדבר ממזער באופן משמעותי את זמן ריצת ה-QPU הנדרש של האופטימייזר. זמן הביצוע לכל מעגל נקבע ברובו על ידי התקורה הקבועה של הרצת עבודה (job) על ה-QPU. לאחר קביעת פרמטרי המעגל, העבודה נשלחת ל-QPU של IBM® שצוין.
התוצאות הגולמיות עוברות לאחר מכן עיבוד לאחר-דגימה. שלב זה משתמש בחיפוש חמדני (greedy) מקומי, העובר באופן אקראי על מחרוזת הפתרון והופך ערכי ביטים אם הדבר מפחית את ערך פונקציית העלות.
בנצ'מרקים
הביצועים עשויים להיות תלויים הן במופע הבעיה והן בשלבי העיבוד שלאחר מכן. במקרים מסוימים, דגימות קלאסיות ודגימות שנוצרו קוונטית עשויות להשיג איכות פתרון סופית דומה לאחר עיבוד שווה-ערך. לכן, יש להעריך את זרימת העבודה המלאה של האופטימיזציה.
מודל Sherrington-Kirkpatrick
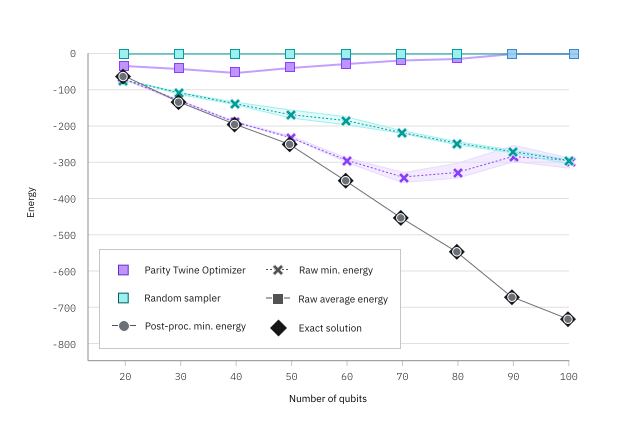
איור 2 מדגים את האפקטיביות של Parity Twine Optimizer. השוואה זו מציגה תוצאות שהתקבלו באמצעות האופטימייזר מול דגימה אקראית עבור מודל Sherrington-Kirkpatrick עם מספר qubits גדל.
עיבוד לאחר-דגימה של תוצאות הדגימה האקראית והאופטימייזר כאחד מוביל למצבי יסוד מדויקים, אך פלט האנרגיה המינימלית הגולמית מ-Twine QAOA תמיד טוב יותר מערכים אקראיים. עבור מספרי ה-qubits הגדולים ביותר שנבחנו (90 ו-100), רעש החומרה פוגע בתוצאת האופטימייזר, אשר חוזרת לערכים גולמיים התואמים דגימה אקראית.
ראו מדריך זה להיכרות עם מודל Sherrington-Kirkpatrick ולפרטים כיצד לפתור אותו באמצעות Parity Twine Optimizer.
בעיית Market Split
טבלה 1 מציגה מדדי ביצועים ספציפיים עבור Parity Twine Optimizer המוחל על מופעים שונים של בעיית Market Split (MS). מדדים אלה התקבלו מתוך QOBLIB - Quantum Optimization Benchmarking Library ומתאימים להגשות שנעשו אל הספרייה באמצעות Parity Twine Optimizer.
MS violation הוא מדד דיוק המודד עד כמה הפתרון רחוק מסיפוק כל האילוצים, ומוגדר כ-. ערכים נמוכים יותר של מדד זה מצביעים על פתרונות מדויקים יותר.
טבלה 1 מדווחת על ערכים ממוצעים עבור חמש הרצות של כל מופע באמצעות Parity Twine Optimizer, עם ההתקן ibm_boston כ-Backend ו-100,000 יריות (shots).
מדווח ה-MS violation המינימלי שהתקבל מבין ההרצות של כל מופע.
| מופע | Qubits | שערי שני qubits | עומק שני qubits | MS violation | זמן מיפוי (שניות) | זמן ריצת QPU (שניות) | זמן עיבוד לאחר-דגימה (שניות) |
|---|---|---|---|---|---|---|---|
| ms_03_050_002 | 20 | 399 | 76 | 0 | 45 | 29 | 71 |
| ms_03_100_022 | 20 | 399 | 76 | 0 | 30 | 29 | 77 |
| ms_03_200_177 | 20 | 399 | 76 | 0 | 33 | 29 | 63 |
| ms_04_050_001 | 30 | 899 | 116 | 1 | 68 | 29 | 216 |
| ms_04_100_003 | 30 | 899 | 116 | 2 | 89 | 29 | 187 |
| ms_04_200_030 | 30 | 899 | 116 | 3 | 89 | 29 | 219 |
| ms_05_100_003 | 40 | 1599 | 156 | 3 | 237 | 30 | 364 |
| ms_06_050_001 | 50 | 2499 | 196 | 4 | 499 | 30 | 464 |
| ms_07_050_001 | 60 | 3599 | 236 | 17 | 858 | 31 | 637 |
| ms_08_050_001 | 70 | 4899 | 276 | 36 | 1561 | 31 | 773 |
טבלה 1: מדדי ביצועים עבור מופעים שונים של בעיית market split. שמות המופעים תואמים לדוגמאות המקבילות בספריית הבעיות QOBLIB. כפי שצוין קודם בפרק התיאור, זמן ה-QPU מינימלי וכמעט קבוע, מכיוון שנעשה שימוש בסיבוב יחיד בלבד של QAOA עם פרמטרי מעגל אופטימליים שהתקבלו על CPU.
ראו מדריך זה להיכרות עם בעיית Market Split ולפרטים כיצד לפתור אותה באמצעות Parity Twine Optimizer.
בעיית Maximum Independent Set
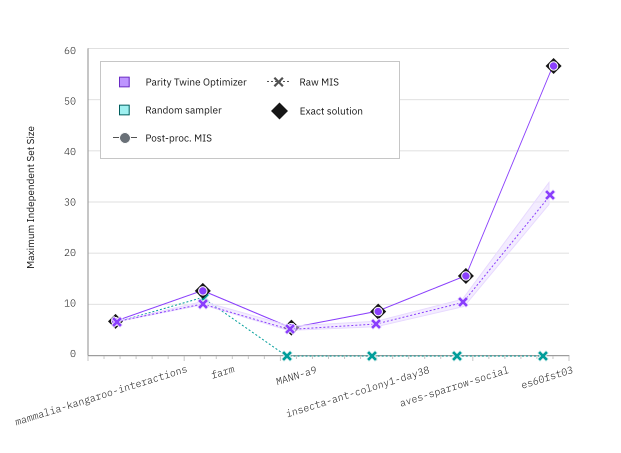
איור 3 משווה תוצאות שהתקבלו באמצעות Parity Twine Optimizer מול דגימה אקראית עבור בעיית maximum independent set, עבור מופעים נבחרים שהתקבלו מתוך QOBLIB - Quantum Optimization Benchmarking Library. אלה נעים בטווח שבין 18 (mammalia-kangaroo-interactions) ל- 114 (es60fst03) qubits.
עבור מופעים קטנים, תוצאות גודל ה-Maximum Independent Set הגולמיות מהאופטימייזר ומדגימה אקראית דומות, אך עבור מופעים גדולים יותר, האופטימייזר נותן תוצאות טובות בהרבה. עיבוד לאחר-דגימה של תוצאות הדגימה האקראית והאופטימייזר כאחד מוביל שוב לגדלי קבוצות התואמים לערכים המדויקים.
התחלת העבודה
התאמתו באמצעות ה-טוקן API של IBM Quantum Platform שלכם, ובחרו את פונקציית ה-Qiskit באופן הבא:
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"qiskit_ibm_catalog": "qiskit-ibm-catalog"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
from qiskit_ibm_catalog import QiskitFunctionsCatalog

# Authenticate and load the Qiskit Function
catalog = QiskitFunctionsCatalog(
    channel="ibm_quantum_platform",
)
function = catalog.load("parityqc/parity-twine-optimizer")
דוגמה
ניתן להחיל את Parity Twine Optimizer על דוגמת QUBO פשוטה כך. הבעיה מוגדרת תחילה באמצעות מילון (dictionary):
problem = {"()": 3, "(0,)": 1, "(0, 1)": 2, "(1, 2)": -1}
לאחר מכן, יש להגדיר את סוג המשתנה כ-binary או spin:
variable_type = "spin"
זה מגדיר את פונקציית המטרה כאשר .
בחרו Backend. לדוגמה:
backend_name = "ibm_phoenix"
השתמשו ב-catalog.backends() כדי לראות רשימה של ה-Backends הזמינים מחשבון/מופע המשתמש.
אם לא צוין Backend, ה-Backend הפחות עמוס (זה עם המספר הקטן ביותר של עבודות ממתינות) נבחר באופן אוטומטי.
לאחר טעינת האופטימייזר (ראו לעיל), ניתן להריץ אותו על הבעיה באמצעות אפשרויות ברירת המחדל:
function_job = function.run(
    problem=problem, variable_type=variable_type, backend_name=backend_name
)
print(f"Job ID: {function_job.job_id}")
בדקו את סטטוס העבודה (job) כך:
# Monitor the job status
function_job.status()
אחזרו את התוצאות כך:
# Retrieve the job result if the status is DONE
result = function_job.result()

result
הדפסת התוצאות מניבה את הפלט הבא:
{
    'solution': {'0': -1, '1': 1, '2': 1},
    'objective_value': -1.0,
    'solution_bitstring': '100',
    'metadata': {
        'circuit_metrics': {
            'depth': 20,
            'gate_count': 198,
            'two_qubit_gate_depth': 4,
            'two_qubit_gate_count': 4,
            'num_qubits': 3,
            'operations': {'delay': 158, 'rz': 17, 'sx': 14, 'cz': 4, 'measure': 3, 'x': 2}
        },
        'solver_info': {
            'variable_mapping': {'0': 0, '1': 1, '2': 2},
            'bitstring_distributions': {
                'before_postprocessing': {'100': 71760, ... },
                'after_postprocessing': {'100': 88440, '011': 11560}
            },
            'best_parameters': {
                'beta': [-0.46259546391008877],
                'gamma': [0.6181957189727373]
            }
        },
        'resource_usage': {
            'RUNNING: MAPPING': {'CPU_TIME': 42.878},
            'RUNNING: OPTIMIZING_FOR_HARDWARE': {'CPU_TIME': 0.094},
            'RUNNING: WAITING_FOR_QPU': {'CPU_TIME': 790.623},
            'RUNNING: EXECUTING_QPU': {'QPU_TIME': 28.0},
            'RUNNING: POST_PROCESSING': {'CPU_TIME': 0.828}
        }
    }
}
מילון ה-solution תואם ל-qubits המוגדרים בבעיה (, ו-) ונותן את ערכי הספין (spin) המאופטמים שלהם.
objective_value הוא העלות או האנרגיה של בעיית האופטימיזציה. הוא מכמת את איכות ה-solution.
metadata נותן מידע על הטרנספילציה (מספר/עומק שערי שני qubits, השערים בהם נעשה שימוש, ה-qubits הפעילים) ועל זמני ריצה שונים הן עבור זמן חישוב קוונטי והן קלאסי.
בנוסף, metadata מספק הצצה לפעולה הפנימית של האלגוריתם. ניתן לראות את הפרמטרים הוריאציוניים המאופטמים (beta ו-gamma) ולבחון כיצד השתפרה התפלגות מחרוזות הביטים שנמדדו לאחר שהוחל עיבוד לאחר-דגימה קלאסי על התוצאות הקוונטיות הגולמיות.
ניתן למפות את כל מחרוזות הביטים בפלט התוצאה למשתני הבעיה באמצעות variable_mapping.
לדוגמה, ניתן למפות את 'solution_bitstring': '100' יחד עם 'variable_mapping': {'0': 0, '1': 1, '2': 2} לפתרון הבינארי: {'0': 1, '1': 0, '2': 0}.
מכיוון שהבעיה נפתרת במונחי משתני ספין (spin), יש להחיל את ההמרה מבינארי לספין (0 -> 1, 1 -> -1 ).
כך מגיעים לפתרון הסופי 'solution': {'0': -1, '1': 1, '2': 1}.
עיינו בהפניית ה-API לפרטים המלאים של הקלט לפונקציית Parity Twine Optimizer והפלט ממנה.
יומן שינויים
[1.0.2] - 2026-09-15
Notes
גרסה זו מסמנת את גרסת הייצור היציבה הראשונה של פונקציית ה-Qiskit של Parity Twine Optimizer. גרסאות עתידיות צפויות להציג את הבאים:
- הידור בעיות מסדר גבוה יותר,
- אלגוריתמי אופטימיזציה נוספים, וכן
- שיפורים בעיבוד המקדים ובעיבוד לאחר-דגימה.
תכונות
- פתרון בעיות QUBO דלילות וצפופות באמצעות מהדר ה-Parity Twine היעיל.
תיעוד
- מדריך משתמש להתחלת העבודה.
- מדריכים עם דוגמאות לבעיות Market Split ו-Sherrington-Kirkpatrick.
- תיעוד API.
קבלת תמיכה
פנו אל ParityQC עם כל שאלה או בעיה.
הצעדים הבאים
- בקשו גישה לפונקציה על ידי מילוי הטופס הזה.
- בקרו בהפניית ה-API של פונקציית Qiskit הזו.
- נסו את המדריך ליישום Parity Twine Optimizer על בעיית Market Split.
- נסו את המדריך ליישום Parity Twine Optimizer על מודל Sherrington-Kirkpatrick.
- עיינו בגרסת הטרום-הדפסה ב-ArXiv Connectivity-aware Synthesis of Quantum Algorithms, Drier et al. (2025).