אלכסון קוונטי מבוסס דגימה (SQD)
אלכסון קוונטי מבוסס דגימה (SQD) משלב אלגברה לינארית קלאסית עם עוצמת המחשוב הקוונטי כדי לאלכסן המילטוניאן (מטריצה) ולחשב את הערכים העצמיים ואת הווקטורים העצמיים שלו. אלכסון מטריצות הוא פעולה מתמטית חשובה, שכן בעיות רבות במדע, במחשוב ובאופטימיזציה משתמשות בה.
הסרטון הבא נותן סקירה של SQD, מה קובע את תועלתו, ומה הופך אותו למהיר יותר מגישות רבות אחרות. הטקסט שאחריו מפרט יותר.
1. מבוא ומוטיבציה
נשתמש במשוואת ערכי האנרגיה העצמיים שהפכה מפורסמת בזכות שרדינגר כדוגמה.
הוא ההמילטוניאן של מערכת, היא פונקציית הגל (המוכרת גם כמצב עצמי), ו- הוא ערך עצמי. הערכים העצמיים של המטריצה מייצגים את רמות האנרגיה של המערכת. למשל, אם המערכת היא מולקולה, הערך העצמי הנמוך ביותר מייצג את אנרגיית מצב היסוד של המולקולה. בבעיות רבות אנחנו מתעניינים באמידת אנרגיית מצב היסוד.
על ידי שימוש בטכניקות אלכסון מדויק מאלגברה לינארית, נוכל לאלכסן את מטריצת המלאה. אולם גישה זו הופכת לכבדה חישובית (ואף בלתי אפשרית) ככל שהמטריצה גדלה. למשל, גם עבור מולקולות כימיות קטנות, יכולה להיות גדולה באופן בעייתי (לדוגמה, ההמילטוניאן של מולקולת עם בסיס cc-PVDZ הוא בעל ממד
למרבה המזל, לא תמיד נחוצים לנו כל הערכים העצמיים והווקטורים העצמיים של המילטוניאן , ולכן, במקרים מעשיים רבים אין צורך לאלכסן את המטריצה המלאה. לדוגמה, במקרה של אמידת מצב יסוד, אנחנו מתעניינים בערך העצמי הנמוך ביותר ובווקטור העצמי המתאים. זה מאפשר לנו להשתמש במושג ההיטל על תת-מרחב (שימושי).
נשקול מטריצה , , שבה למרחב הווקטורי המלא (מרחב הילברט) יש ממד ( גדול). לאחר מכן נבחר תת-מרחב () — שהוא תת-קבוצה של מרחב הילברט המלא — בעל ממד , כאשר קטן מספיק. לאחר היטל על תת-מרחב זה, המטריצה המוטלת (נקרא לה ) תהיה קטנה יותר (). ניתן לאלכסן את הקטנה יותר בשיטה מספרית קלאסית מתאימה, ולהפיק ערכים עצמיים ווקטורים עצמיים עבור אותו תת-מרחב.
שימו לב שתת-המרחב חייב להיות ב_תמיכה_ של מצב המטרה העצמי שלנו (לדוגמה, מצב יסוד). במילים אחרות, ההמילטוניאן המוטל חייב להיות בתת-מרחב הכולל את הערך העצמי הנמוך ביותר.
2. היטל ואלכסון
נניח שאנו רוצים למצוא את הערך העצמי הנמוך ביותר ואת הווקטור העצמי המתאים עבור מטריצת ההמילטוניאן בגודל הבאה.
נאלכסן את המטריצה המלאה יחד עם גרסאות מוטלות שונות () עבור תת-מרחבים שונים, כדי להדגים את מדרגיות השיטה ואת חשיבות בחירת תת-המרחב.
אנרגיית מצב היסוד (ערך עצמי מינימלי) של המטריצה היא ופונקציית הגל של מצב היסוד ה_מדויקת_ (ווקטור עצמי) היא:
כלומר, מצב היסוד של המטריצה נפרש על ידי שני מצבי בסיס חישוביים (וקטורים) ו-.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"numpy": "numpy", "scipy": "scipy"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
import numpy as np
from scipy.linalg import eigh

np.set_printoptions(precision=4, sign="-", suppress=True, linewidth=100)

H = np.array(
    [
        [0.2235, -0.039, -0.1035, -0.0818, 0.1746, 0.1091, 0.1165, -0.0104],
        [-0.0390, 0.6621, 0.0706, -0.1964, -0.0782, 0.2619, 0.1095, 0.0029],
        [-0.1035, 0.0706, 0.9961, 0.1724, 0.1067, -0.2299, -0.1817, 0.1571],
        [-0.0818, -0.1964, 0.1724, -0.1773, 0.1019, -0.4778, -0.1272, -0.0414],
        [0.1746, -0.0782, 0.1067, 0.1019, 0.1418, -0.1359, -0.1793, -0.0766],
        [0.1091, 0.2619, -0.2299, -0.4778, -0.1359, 0.1014, 0.1696, 0.0552],
        [0.1165, 0.1095, -0.1817, -0.1272, -0.1793, 0.1696, 0.4227, 0.2702],
        [-0.0104, 0.0029, 0.1571, -0.0414, -0.0766, 0.0552, 0.2702, 0.4456],
    ]
)
eigvals, eigvecs = eigh(H)

print("Eigenvalues:")
print(eigvals)
print(f"Minimum eigenvalue: {eigvals.min()}")

print("\nEigenvectors (columns represent vectors):")
print(eigvecs)
print("\nEigenvector for the minimum eigenvalue (ground state)")
print(eigvecs[:, np.argmin(eigvals)])
Eigenvalues:
[-0.5357 -0.1321  0.1049  0.1258  0.3616  0.6405  0.947   1.3039]
Minimum eigenvalue: -0.5356560029438817

Eigenvectors (columns represent vectors):
[[-0.     -0.5612  0.098  -0.0024  0.8051 -0.0806  0.0643  0.1288]
 [-0.     -0.1403 -0.1985 -0.4249 -0.0092  0.585  -0.5952  0.2526]
 [ 0.      0.0416  0.3041  0.2122  0.1509 -0.0139 -0.5794 -0.7086]
 [ 0.8    -0.1936 -0.0127 -0.4376 -0.1081 -0.0838  0.1557 -0.2966]
 [ 0.      0.6716 -0.3535 -0.2552  0.5395  0.0954  0.1449 -0.1941]
 [ 0.6     0.258   0.017   0.5834  0.1441  0.1118 -0.2076  0.3954]
 [ 0.      0.3088  0.5504 -0.4197  0.0626 -0.468  -0.2625  0.3657]
 [-0.     -0.1146 -0.6559  0.0356 -0.0394 -0.6352 -0.3856  0.0418]]

Eigenvector for the minimum eigenvalue (ground state)
[-0.  -0.   0.   0.8  0.   0.6  0.  -0. ]
לאחר מכן, נטיל את המטריצה על תת-מרחבים שונים ונבדוק אם נוכל לקבל את מצב היסוד המדויק. בפרט, נטיל את המטריצה על תת-מרחב הנפרש על ידי:
-
ווקטורי מצב היסוד המדויקים ( ו-).
-
ווקטורים שאינם כוללים חלק מווקטורי מצב היסוד המדויקים או את כולם (לדוגמה, , , ו-).
-
ווקטורים הכוללים גם ווקטורי מצב יסוד מדויקים וגם ווקטורים שאינם שייכים למצב היסוד (אך לא את כל הווקטורים האפשריים במרחב הילברט).
2.1 מקרה 1: תת-המרחב כולל את מצב היסוד
נניח שאנו רוצים להטיל את על תת-מרחב () הנפרש על ידי שני ווקטורים ו-. ההמילטוניאן המוטל מוגדר על ידי:
x1 = np.zeros(8)
x1[3] = 1  # binary 011 is 3 in decimal. |011> = |3> = [0,0,0,1,0,0,0,0]

x2 = np.zeros(8)
x2[5] = 1  # binary 101 is 5 in decimal

Hs = np.array([[x1.T @ H @ x1, x1.T @ H @ x2], [x2.T @ H @ x1, x2.T @ H @ x2]])
print(Hs)
[[-0.1773 -0.4778]
 [-0.4778  0.1014]]
שימו לב שבכתיבת איברי ההמילטוניאן המוטל כ-x1.T @ H @ x2, אנחנו מאמצים באופן מרומז את המוסכמה הנפוצה לפיה וקטורי המצב x1 ו-x2 מתאימים לקטים (וקטורי עמודה), בהתאם לביטויים כמו . עם זאת, מערכים חד-ממדיים של NumPy אינם מבחינים באופן מהותי בין וקטורי שורה לווקטורי עמודה, ועבור הווקטורים המשמשים כאן לפעולת השחלוף אין השפעה מספרית. כתוצאה מכך, כתיבת x1 @ H @ x2.T תניב את אותה תוצאה מספרית, אם כי x1.T @ H @ x2 תואמת בצורה קרובה יותר להתאמה הרגילה בסימון דיראק .
eigvals, eigvecs = eigh(Hs)
print(f"Minimum eigenvalue: {eigvals.min()}")
print(f"Eigenvector for minimum eigenvalue: {eigvecs[:,np.argmin(eigvals)]}")
Minimum eigenvalue: -0.535656000064295
Eigenvector for minimum eigenvalue: [-0.8 -0.6]
ניתן להסיק מכאן מספר תצפיות מפתח.
- מאחר שפרסנו את תת-המרחב בשני ווקטורים, הממד של המטריצה המוטלת () הוא , שהוא קטן מהמטריצה המלאה ().
- הערך העצמי המינימלי של המטריצה המוטלת תואם את ערך האנרגיה המדויק של מצב היסוד.
- הערכים במשתנה
eigvecsמציינים את האמפליטודה של ווקטורי הפרישה של תת-המרחב, ובעזרתם נוכל לשחזר את המצב העצמי (מצב היסוד). במקרה זה נגיע למצב היסוד המדויק (עד פאזה גלובלית):
2.2 מקרה 2: תת-המרחב לא כולל חלק מווקטורי מצב היסוד או את כולם
לאחר מכן, נטיל את על תת-מרחב הנפרש על ידי שלושה ווקטורים , , ו-. אנחנו בוחרים בכוונה ווקטורים שאינם כוללים ווקטור מצב יסוד (). ההמילטוניאן המוטל מוגדר על ידי:
x1 = np.zeros(8)
x1[0] = 1

x2 = np.zeros(8)
x2[3] = 1

x3 = np.zeros(8)
x3[6] = 1

Hs = np.array(
    [
        [x1.T @ H @ x1, x1.T @ H @ x2, x1.T @ H @ x3],
        [x2.T @ H @ x1, x2.T @ H @ x2, x2.T @ H @ x3],
        [x3.T @ H @ x1, x3.T @ H @ x2, x3.T @ H @ x3],
    ]
)
print(Hs)
[[ 0.2235 -0.0818  0.1165]
 [-0.0818 -0.1773 -0.1272]
 [ 0.1165 -0.1272  0.4227]]
eigvals, eigvecs = eigh(Hs)
print(f"Minimum eigenvalue: {eigvals.min()}")
Minimum eigenvalue: -0.21108858736702252
הערך העצמי במקרה זה אינו תואם את הערך העצמי המינימלי של ההמילטוניאן המלא. התצפית המרכזית כאן היא: אם נטיל על תת-מרחב שאינו כולל מצבי בסיס של המצב המטרה (היסוד) שלנו — בין אם חלקית ובין אם לחלוטין — מצב היסוד המשוער יהיה שונה מהמדויק.
2.3 מקרה 3: תת-המרחב כולל גם ווקטורי מצב יסוד וגם ווקטורים שאינם שייכים למצב היסוד
לאחר מכן, נציג מקרה שבו תת-המרחב נפרש על ידי ווקטורים הכוללים ווקטורי מצב יסוד מדויקים לצד ווקטורים בלתי רצויים. נניח שתת-המרחב שלנו נפרש על ידי , (קיימים במצב היסוד המדויק), ו- (נעדר ממצב היסוד המדויק).
x1 = np.zeros(8)
x1[3] = 1

x2 = np.zeros(8)
x2[5] = 1

x3 = np.zeros(8)
x3[7] = 1

Hs = np.array(
    [
        [x1.T @ H @ x1, x1.T @ H @ x2, x1.T @ H @ x3],
        [x2.T @ H @ x1, x2.T @ H @ x2, x2.T @ H @ x3],
        [x3.T @ H @ x1, x3.T @ H @ x2, x3.T @ H @ x3],
    ]
)
print(Hs)
[[-0.1773 -0.4778 -0.0414]
 [-0.4778  0.1014  0.0552]
 [-0.0414  0.0552  0.4456]]
eigvals, eigvecs = eigh(Hs)
print(f"Minimum eigenvalue: {eigvals.min()}")
print(f"Eigenvector for minimum eigenvalue: {eigvecs[:,np.argmin(eigvals)]}")
Minimum eigenvalue: -0.53565600006461
Eigenvector for minimum eigenvalue: [ 0.8  0.6 -0. ]
במקרה זה, אנחנו מקבלים שוב כערך עצמי מינימלי, התואם את המטריצה המלאה (כלומר, מצב היסוד המדויק). תוצאה מעניינת נוספת היא האמפליטודה של שמחזיר תהליך ההיטל והאלכסון. האמפליטודה היא , וכשאנו משחזרים את פונקציית הגל (המצב העצמי) עם האמפליטודות והווקטורים המחושבים, אנחנו מקבלים:
כך, גם אם תת-המרחב שלנו כולל ווקטורים שאינם ממטרה (לצד הקבוצה המלאה של ווקטורי המטרה), נוכל לחשב את הערך העצמי והמצב העצמי הנכונים, שכן תהליך ההיטל והאלכסון מסנן ווקטורים שאינם ממטרה על ידי הגדרת אמפליטודותיהם ל-. תכונה זו של SQD מספקת סבילות רעש טבועה.
3. תפקיד המחשוב הקוונטי ב-SQD
הניתוחים שלעיל מבססים את החשיבות של וקטורי פריסת תת-המרחב, אשר חייבים להיות בתמיכה של המצב המטרה. זה מעלה שאלה חשובה: כיצד בוחרים וקטורים עם תמיכת מצב המטרה לבניית תת-המרחב?
כאן מחשבים קוונטיים נכנסים לתמונה. הסינרגיה הקוונטית-קלאסית פועלת כך בפרדיגמת SQD:
-
באמצעות Circuit קוונטי מתאים, אנחנו מנסים להכין מצב במחשב קוונטי שייצר מצבי בסיס שבהם לפונקציית הגל המטרה (למשל, מצב היסוד) יש תמיכה משמעותית. מצבי הבסיס הנדגמים (ביטסטרינגים) יפרסו את תת-המרחב לטובת הטלת ה-Hamiltonian.
-
מחשב קלאסי מטיל את ה-Hamiltonian על תת-המרחב (הנפרס על ידי דגימות/וקטורים מהמחשב הקוונטי) ומלכסן אותו כדי לחשב ערכים עצמיים ווקטורים עצמיים באמצעות שיטות נומריות מתאימות.
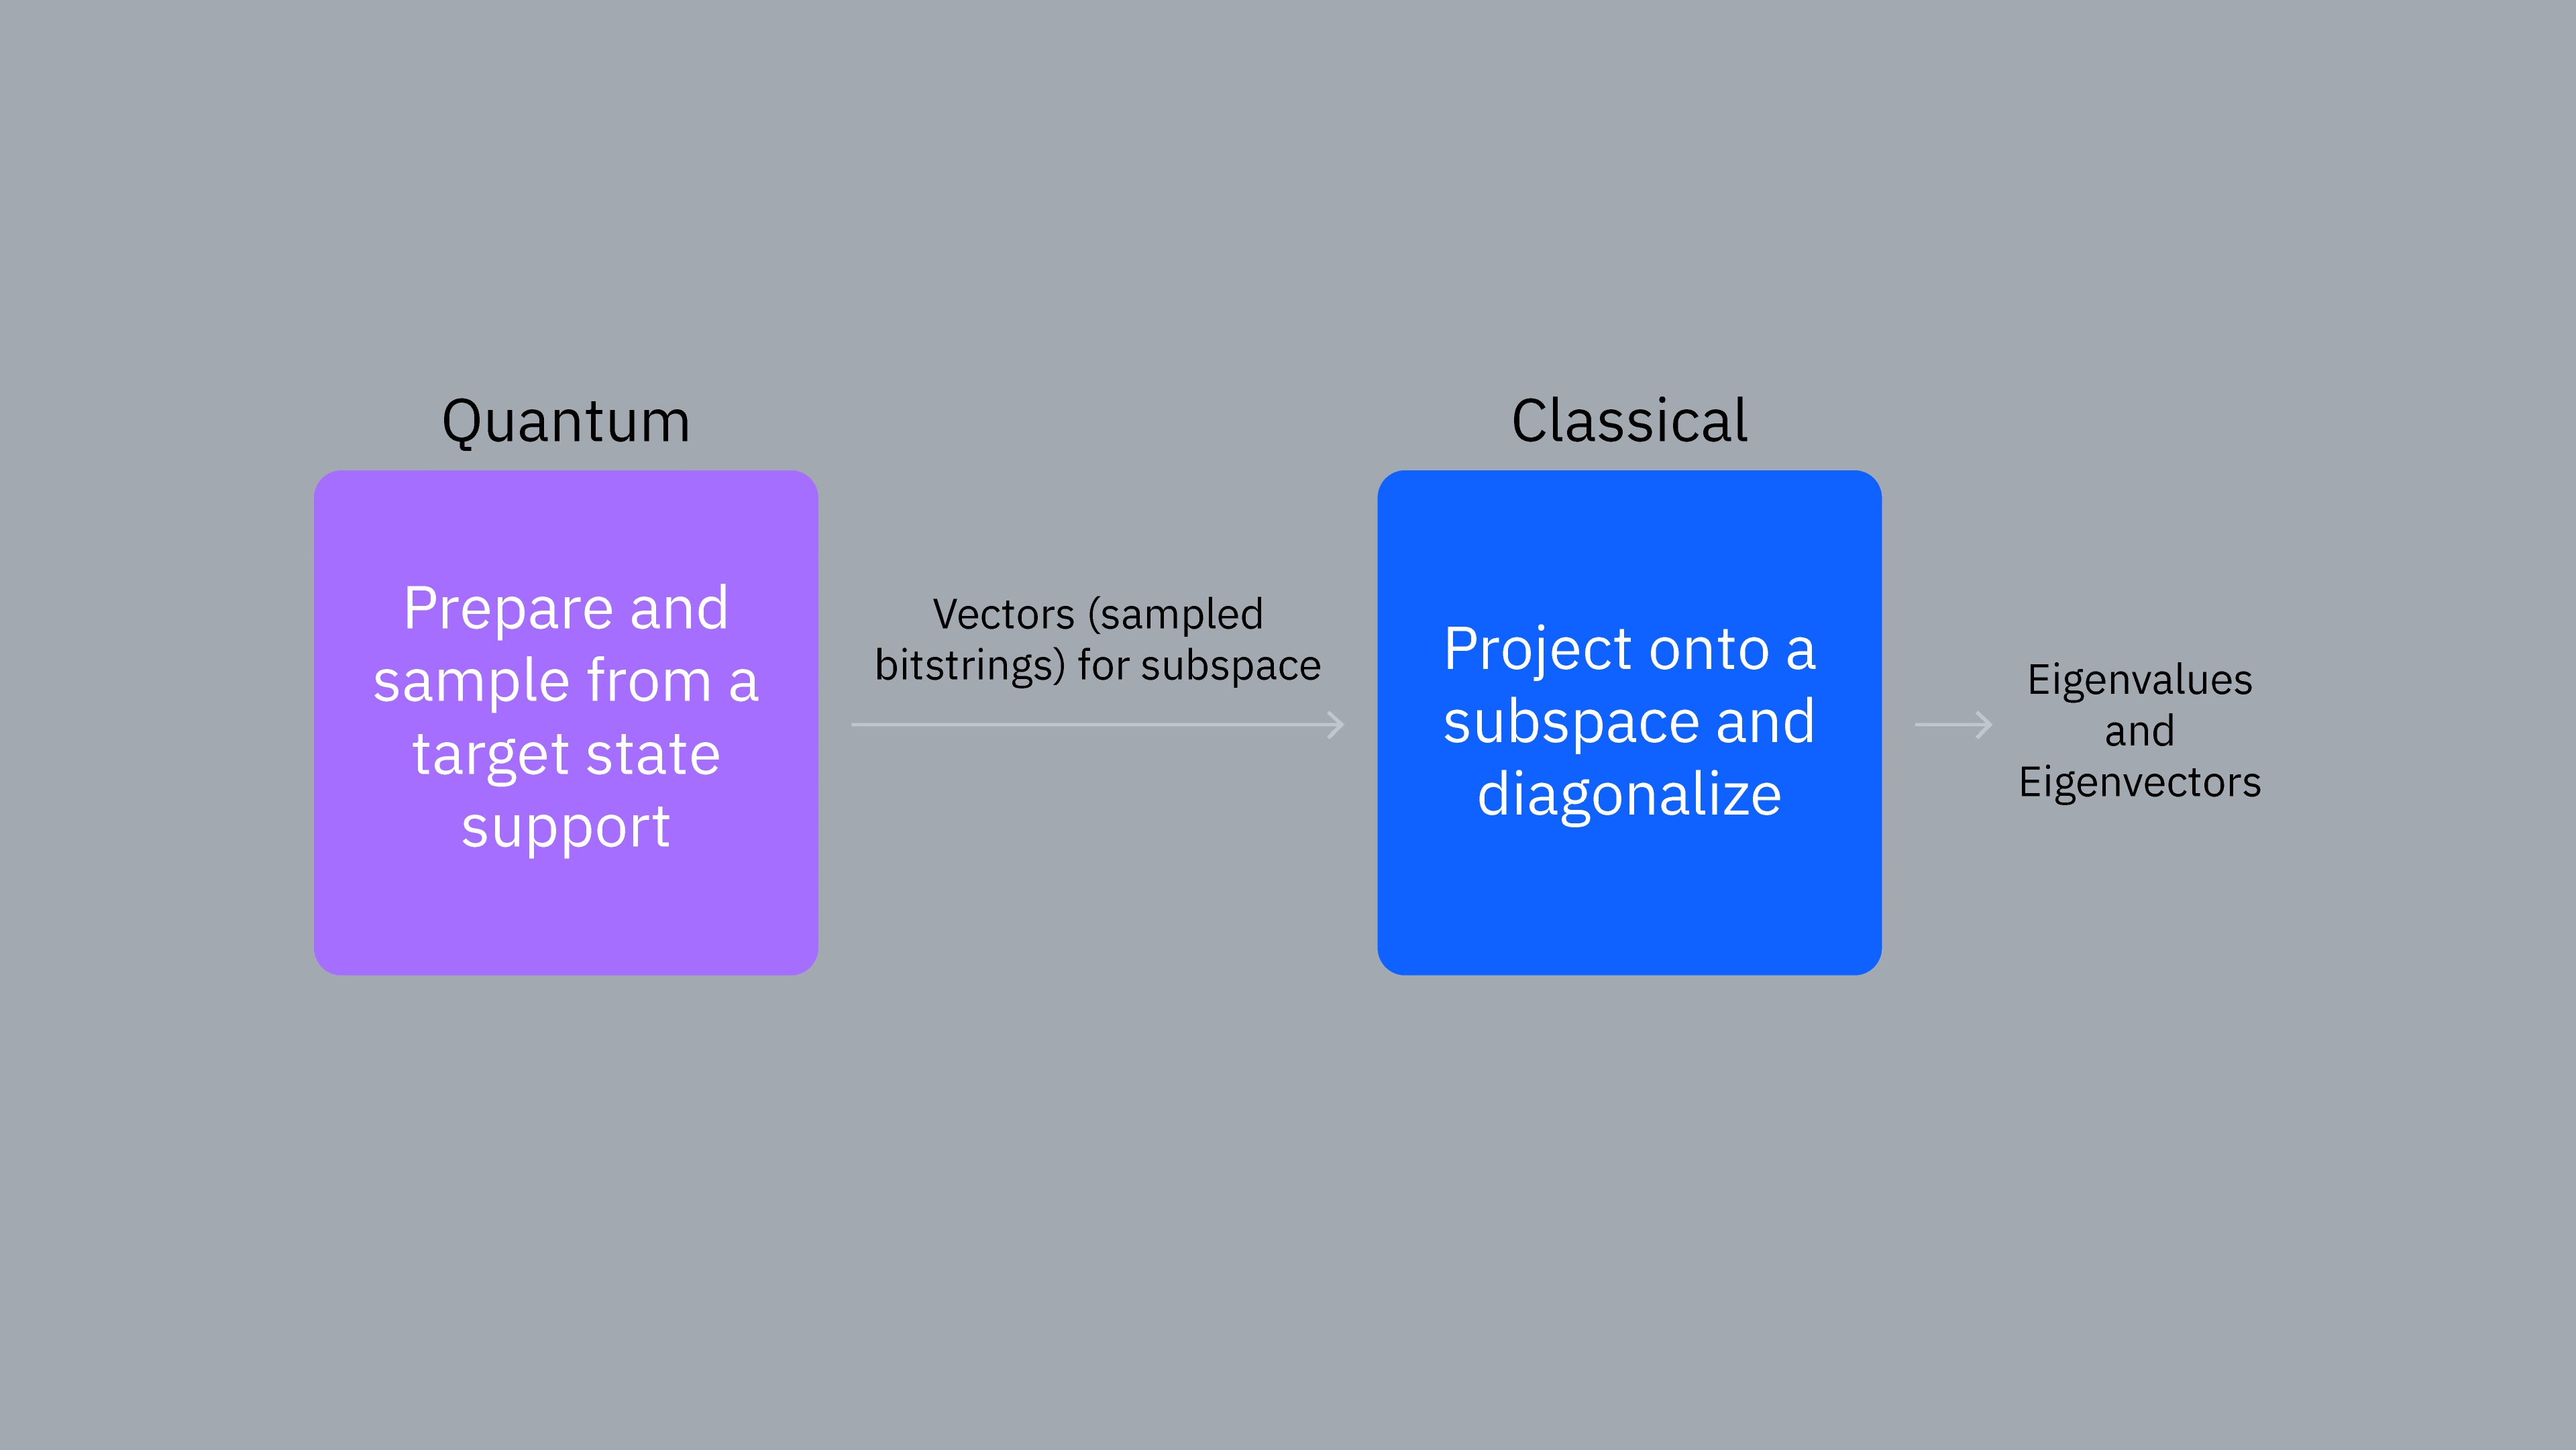 יש כמה דרכים להכין מצב קוונטי כזה, והן יכולות להיות וריאציוניות או לא-וריאציוניות בהתאם לבעיה.
בשני השיעורים הבאים נציג שני דוגמאות ספציפיות להכנת מצבים ודגימה מהם.
- בשיעור 4, נשתמש ב-ansatz לוקאלי אוניטרי קשור ג'סטרו (LUCJ) עם פרמטרים כדי לייצר דגימות לבעיית כימיה (אומדן אנרגיית מצב יסוד של מולקולת ). נאתחל את ה-LUCJ ansatz עם פרמטרים מחישוב קלאסי של coupled cluster singles and doubles (CCSD).
- בשיעור 5, נדגום ממצבי בסיס של Krylov כדי לפרוס את תת-המרחב לבעיית פיזיקה של חומר מעובה. גישה זו אינה וריאציונית באופייה.
מעבר לגישות הספציפיות לבעיה לעיל, גישה גנרית להכנת מצב כוללת ansatz וריאציוני, שבו נעדכן פרמטרי ansatz בצורה איטרטיבית באמצעות מייעל קלאסי.
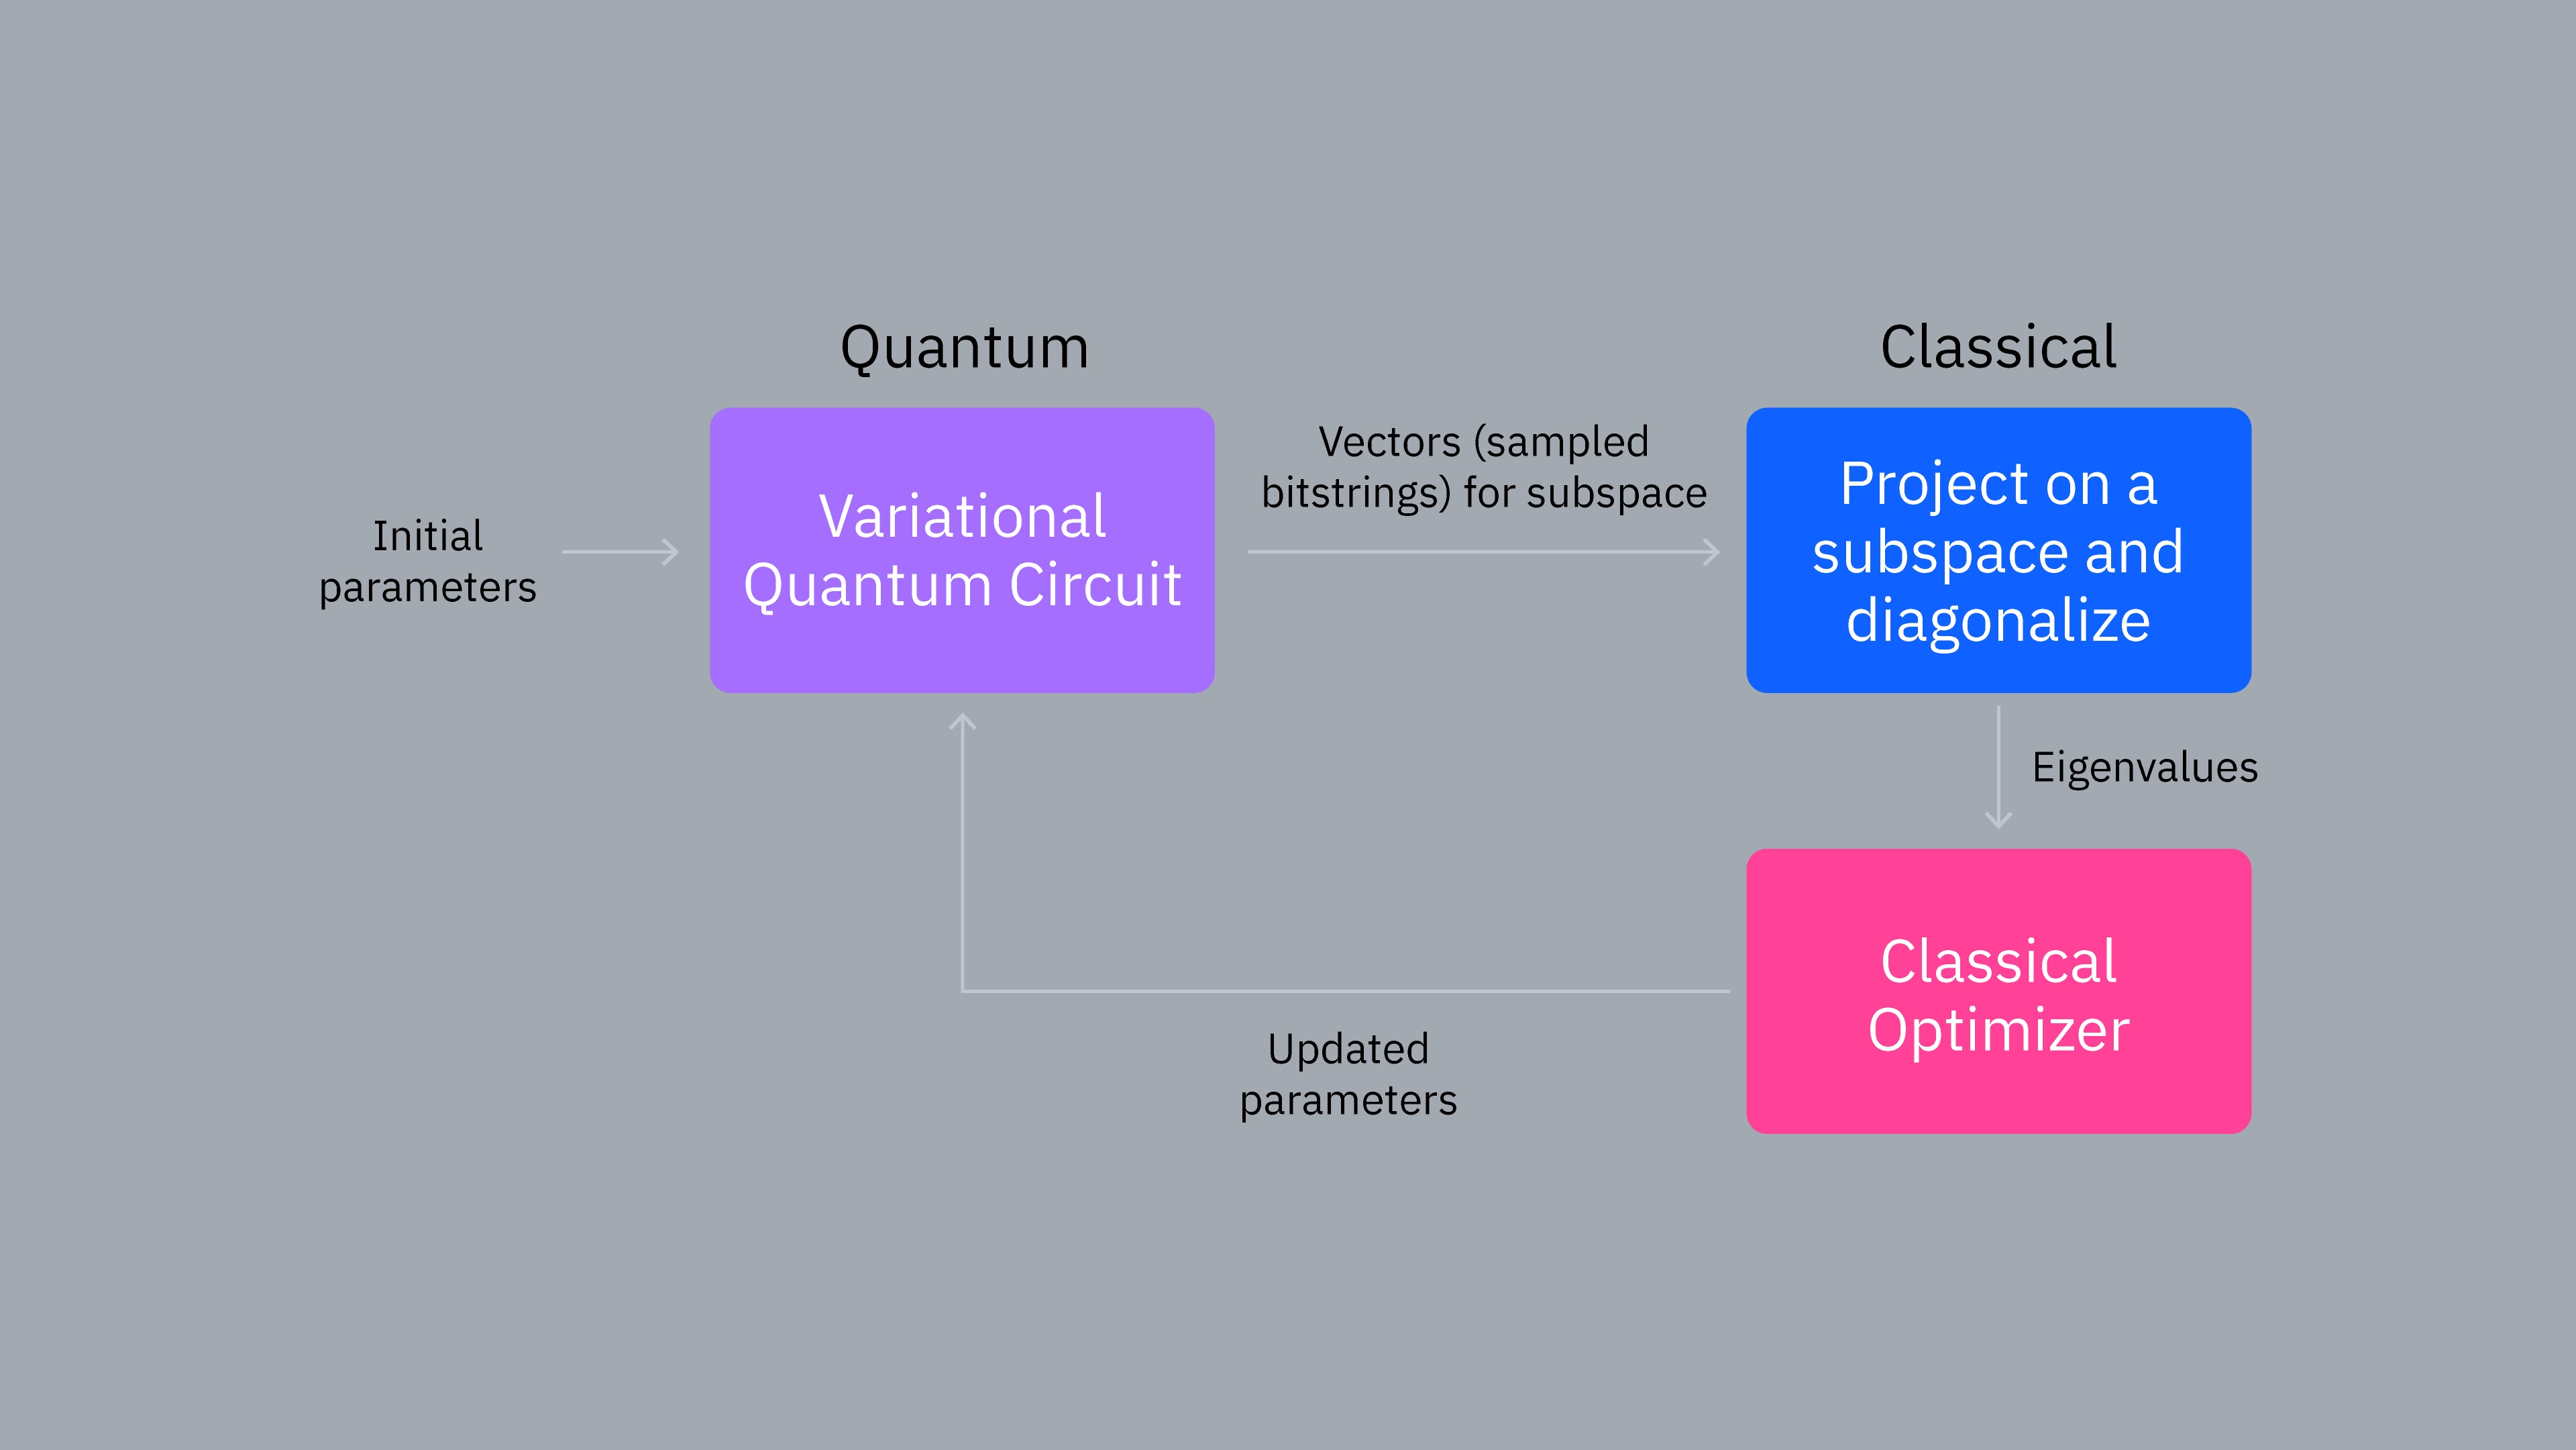 דגימות ממחשבים קוונטיים לפני סבילות לתקלות עלולות להיות רועשות. SQD משתמש בתהליך שחזור תצורה עצמי-עקבי לתיקון דגימות רועשות [1]. נדון בתהליך שחזור התצורה בפירוט רב יותר ונישם אותו לתיקון דגימות רועשות בצורה איטרטיבית כדי לחדד את אומדן אנרגיית מצב היסוד לבעיית כימיה בשיעור 4.
3.1 הערות על תמיכת מצב היסוד
בואו נסביר את המושג תמיכת מצב היסוד ביתר פירוט. ניתן להגדיר תמיכת מצב יסוד כקבוצת מצבי הבסיס שבהם למצב היסוד יש משרעת שאינה אפס (עד לסף גזירה).
נניח שמצב היסוד המדויק של בעיית -Qubit הוא
אם נדגום את המצב לעיל, אנחנו אמורים לקבל קבוצה של מצבי בסיס חישובי , (למצבי בסיס חישובי אחרים יש משרעת אפס במצב היסוד, ולכן, באופן אידיאלי, לא יופיעו בדגימה).
באופן אידיאלי, קבוצת וקטורי הבסיס למצב זה מורכבת מ- (במילים אחרות, תת-המרחב של מצב זה נפרס על ידי שני וקטורי בסיס אלה).
בפועל, אין צורך להכין את מצב היסוד המדויק, שכן דגימה ממצבים רבים אחרים יכולה לתת לנו את אותה קבוצת וקטורים. לדוגמה:
הכנה ודגימה מכל אחד מהמצבים לעיל תייצר וקטורים בעלי משרעת שאינה אפס במצב היסוד, וכולם כשירים לכך שיש להם תמיכת מצב יסוד. שימו לב שדגימה מ- כוללת וקטור נוסף אחד שיש לו משרעת במצב היסוד המדויק. אולם, כפי שהראינו קודם, הכללת וקטורים כאלה בתת-המרחב אינה בעייתית שכן פעולת ההטלה והלכסון מציבה את המשרעת של הוקטורים הבלתי רצויים ל-, וניתן לקבל את ערך העצמי הצפוי ולשחזר את מצב העצמי הנכון.
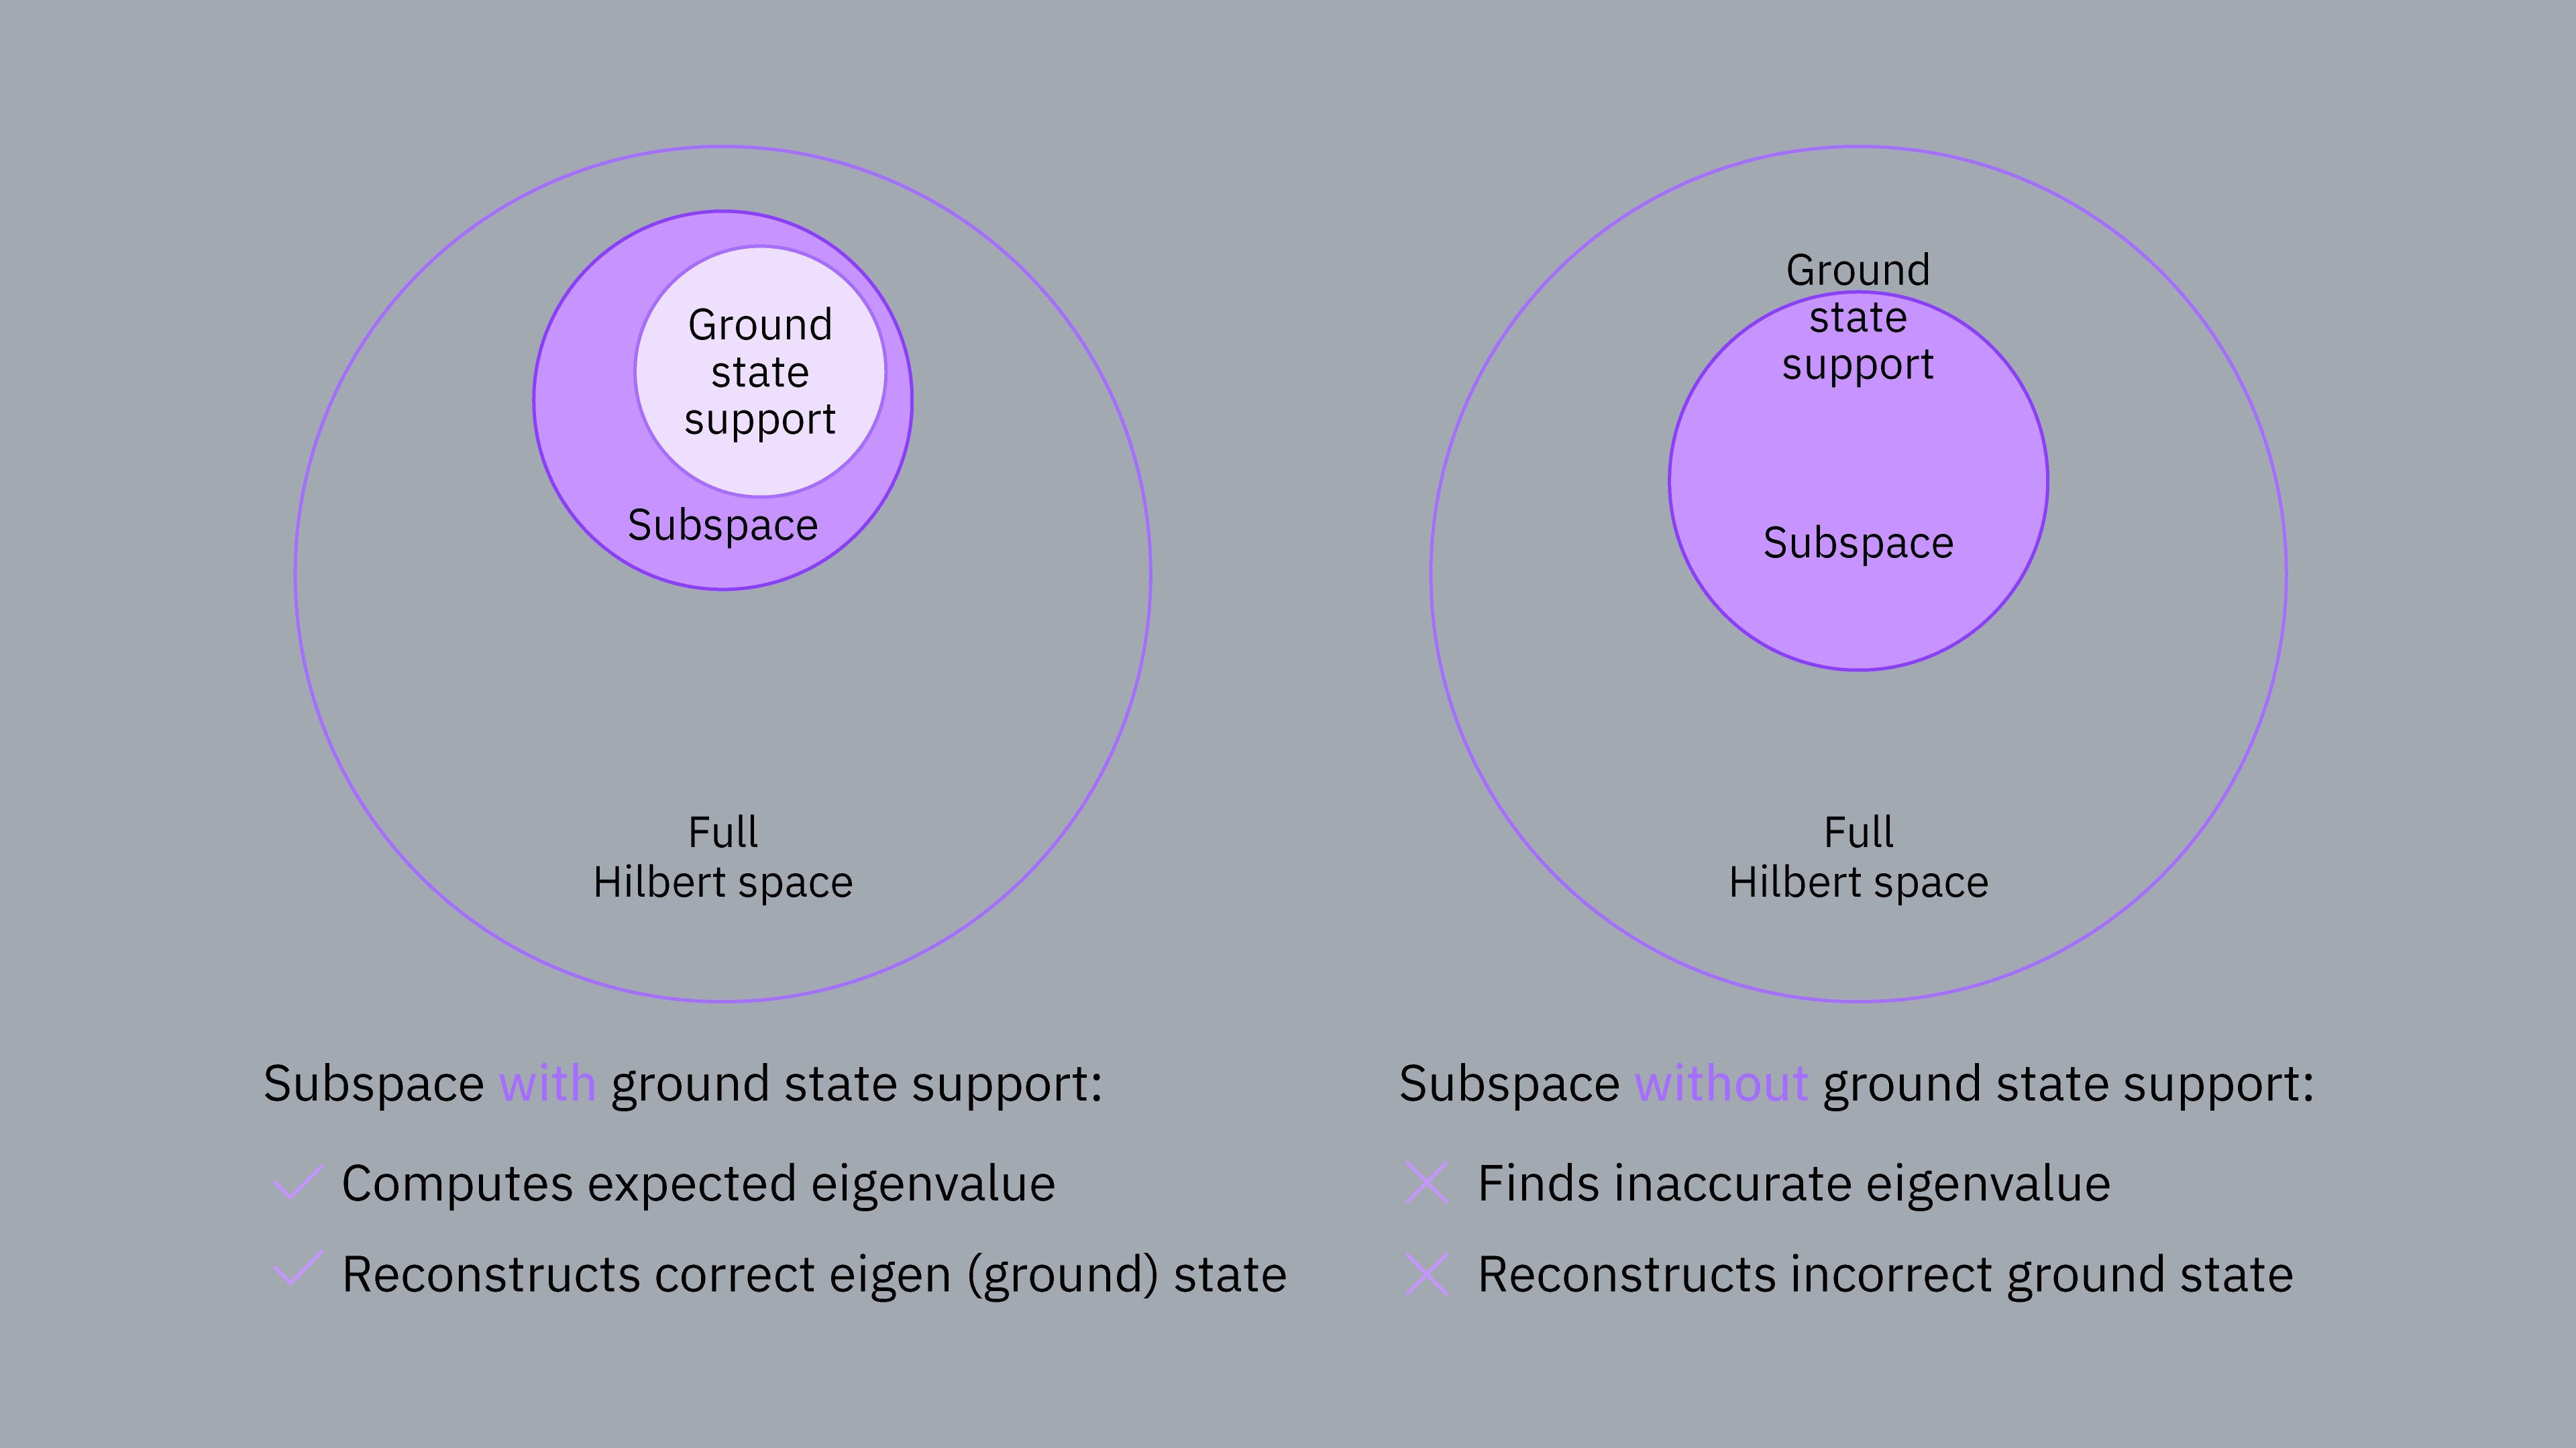
לפיכך, הכנה ודגימה ממצב היסוד המדויק אינן הכרחיות. למעשה, לעשות זאת עלול להיות קשה, שכן מצב היסוד המדויק אינו ידוע מראש, ולעיתים קרובות מועיל לא להכין ולדגום ממצב היסוד המדויק, במיוחד אם פונקציית הגל (המצב) מוטה כאשר לחלק ממצבי הבסיס יש הסתברויות גבוהות מאוד. שקלו את פונקציית הגל הבאה:
זוהי פונקציית גל מוטה שבה למצבי הבסיס ו- יש משרעות גדולות בהרבה בהשוואה ל- ו-. כאשר דוגמים, נקבל את ו- לעיתים קרובות יותר ( עבור ו- כל אחד, עבור , ו- עבור ). עם תקציב דגימה מוגבל (shots), סביר מאוד שהקבוצה הנדגמת שלנו תכיל רק את ו-. כפי שהראינו קודם, אם נפרוס את תת-המרחב עם קבוצה כזו שחסרים בה וקטורים, לא נוכל למצוא את ערך העצמי המינימלי האמיתי. לכן, יהיה מועיל (ונחוץ) לדגום ממצב בעל תמיכת מצב יסוד.
3.2 טיעון נגד דגימה אחידה
עלול להיות מפתה לשאוב דגימות מהתפלגות אחידה כדי לפרוס את תת-המרחב. בעוד שזה עשוי לעבוד עבור בעיות קטנות, זה יתחיל להיכשל עבור בעיות גדולות ומעשיות יותר. לבעיות גדולות עם qubits רבים, מרחב הילברט יכול להיות גדול בצורה שאינה ניתנת לטיפול. לדוגמה, מרחב הילברט של 32-Qubit מכיל יותר מ- מיליארד וקטורי בסיס אפשריים (). אם נדגום באופן אחיד מאותו מרחב עם תקציב דגימה מוגבל (נניח וקטורים כדי לשמור על ישימות תהליך הלכסון), תת-המרחב עלול לא לכלול וקטורים עם תמיכת מצב יסוד לעיתים קרובות יותר שכן התהליך יהיה אקראי. לכן, אנחנו צריכים דרך שיטתית לדגום מתמיכת מצב היסוד תוך ניצול Circuit-ים קוונטיים.
4. SQD ודלילות פונקציית הגל
הפער בין מרחב הילברט המלא לממדי תת-המרחב הישימים מביא היבט חשוב נוסף של SQD, והוא דלילות פונקציית הגל. גישת SQD עובדת היטב עבור פונקציות גל דלילות או מרוכזות שבהן חלק קטן ממצבי הבסיס בעל משרעות שאינן זניחות. ישנן שתי סיבות לכך:
-
אם פונקציית הגל רחבה (כלומר, למצבי בסיס רבים יש משרעות שאינן זניחות), ואנחנו מחמיצים וקטורים עם תמיכת מצב המטרה בתת-המרחב, אנחנו עלולים לקבל ערכים עצמיים ווקטורים עצמיים שגויים.
-
כדי להימנע מהבעיה לעיל, צריך לכלול וקטורים רבים בתת-המרחב. אולם, הממד של ה-Hamiltonian המוטל קשור ישירות לממד תת-המרחב. תת-מרחב גדול יותר יאמר Hamiltonian גדול יותר, שעלול להפוך ללא ישים ללכסון.
אנחנו מדגימים את הבעיה עם המטריצה הבאה (). ערך העצמי הנמוך ביותר של הוא , ופונקציית הגל המתאימה (מצב עצמי) היא רחבה:
H_new = np.array(
    [
        [-0.958, 0.1853, -0.2663, -0.3875, -0.0524, -0.3779, -0.0145, -0.3369],
        [0.1853, -0.4081, -0.8549, -0.2312, 0.0615, -0.2493, -0.3804, -0.3312],
        [-0.2663, -0.8549, -0.6929, -0.0063, -0.0478, -0.0236, -0.2494, -0.0669],
        [-0.3875, -0.2312, -0.0063, -0.4468, -0.6301, -0.4627, -0.1188, 0.0753],
        [-0.0524, 0.0615, -0.0478, -0.6301, -0.6664, -0.1514, -0.3571, -0.3644],
        [-0.3779, -0.2493, -0.0236, -0.4627, -0.1514, -0.9605, 0.0137, 0.0035],
        [-0.0145, -0.3804, -0.2494, -0.1188, -0.3571, 0.0137, -1.1449, 0.0433],
        [-0.3369, -0.3312, -0.0669, 0.0753, -0.3644, 0.0035, 0.0433, -1.2307],
    ]
)
eigvals, eigvecs = eigh(H_new)
print(f"Minimum eigenvalue: {eigvals.min()}")
print(f"Eigenvector for minimum eigenvalue: {eigvecs[:,np.argmin(eigvals)]}")
Minimum eigenvalue: -2.208137504726661
Eigenvector for minimum eigenvalue: [0.3536 0.3536 0.3536 0.3536 0.3535 0.3536 0.3535 0.3535]
נניח שאנחנו מטילים את על תת-מרחב הנפרס על ידי ארבעה וקטורים: , , , ו- ומחשבים את ערך העצמי.
x1 = np.zeros(8)
x1[0] = 1

x2 = np.zeros(8)
x2[2] = 1

x3 = np.zeros(8)
x3[5] = 1

x4 = np.zeros(8)
x4[6] = 1

H_new_s = np.array(
    [
        [x1.T @ H_new @ x1, x1.T @ H_new @ x2, x1.T @ H_new @ x3, x1.T @ H_new @ x4],
        [x2.T @ H_new @ x1, x2.T @ H_new @ x2, x2.T @ H_new @ x3, x2.T @ H_new @ x4],
        [x3.T @ H_new @ x1, x3.T @ H_new @ x2, x3.T @ H_new @ x3, x3.T @ H_new @ x4],
        [x4.T @ H_new @ x1, x4.T @ H_new @ x2, x4.T @ H_new @ x3, x4.T @ H_new @ x4],
    ]
)
print(H_new_s)
[[-0.958  -0.2663 -0.3779 -0.0145]
 [-0.2663 -0.6929 -0.0236 -0.2494]
 [-0.3779 -0.0236 -0.9605  0.0137]
 [-0.0145 -0.2494  0.0137 -1.1449]]
eigvals, eigvecs = eigh(H_new_s)
print(f"Minimum eigenvalue: {eigvals.min()}")
Minimum eigenvalue: -1.4266552340586673
הדוגמה לעיל מראה שכאשר פונקציית הגל רחבה ואנחנו לא כוללים מצבי בסיס בתת-המרחב, חישוב ערך העצמי הופך לשגוי.
5. SQD לעומת VQE
כפי שצוין קודם, SQD עשוי להזדקק ל-Circuit קוונטי וריאציוני ועדכוני פרמטרים איטרטיביים כדי להכין ולדגום מתמיכת מצב היסוד. מכיוון שנוהל עדכון הפרמטרים האיטרטיבי הזה דומה ל-VQE, אפשר לשאול כיצד שיטות אלה שונות, ומה היתרונות של SQD על VQE? בסעיף זה, אנחנו משווים את השיטות ודנים ביתרונות של SQD עם מולקולת המתוארת עם קבוצת בסיס מינימלית (sto-3g) כדוגמה.
| VQE | SQD | |
|---|---|---|
| עלות מדידה | מונחי Pauli רבים, Circuit-ים מדידה רבים: ל-Hamiltonian של המולקולה יש מונחי Pauli ייחודיים. מאחר שמונחי Pauli יכולים להכיל מונחי ו-, ומדידות קוונטיות טיפוסיות נעשות בבסיס , אנחנו צריכים שינוי בסיס מדידה כדי להעריך מונחים אלה. כשמאופטם למדידות, ניתן לקבץ את המונחים ל- קבוצות, כשכל קבוצה יכולה להיות מוערכת באמצעות Circuit בודד. כך, אנחנו צריכים לפחות Circuit-ים ייחודיים להערכת כל מונחי Pauli. shots רבים לכל Circuit לשונות קטנה יותר. שוב, לערך הציפייה המוערך של כל מונח Pauli יש שונות הצמודה לו שתלויה ביחס הפוך ב-. לכן, כדי לאמוד בדיוק כל מונח, אנחנו צריכים להקצות shots רבים לכל Circuit. לדוגמה, כדי להשיג דיוק כימי ( kcal/mol), בדרך כלל אנחנו צריכים shots בסדר גודל של - לכל Circuit. לפיכך, VQE צריך Circuit-ים מדידה רבים וכל Circuit עם מספר מסוים של shots. במקרים מעשיים, עלות מדידה זו יכולה להיות מגבילה. | ב-SQD, איננו צריכים Circuit-ים מדידה שונים לכל מונחי Pauli המקובצים. בדרך כלל, אנחנו מודדים Circuit בודד עבור מספר קבוע של shots. בעוד שאנחנו עשויים להגדיר את מספר ה-shots לערך גדול בהתאם לבעיה, העלות נשארת קטנה בהרבה מ-VQE. כמו כן, אומדני האנרגיה באמצעות תהליך הלכסון הם מדויקים, כלומר הערכים העצמיים המחושבים מדויקים בתת-המרחב הזה ואין להם שונות כמו ב-VQE. (במקרה של דגימת מצבי בסיס של Krylov (שיעור 5), אנחנו צריכים למדוד Circuit-ים מרובים, אך מספר ה-Circuit-ים נשאר קטן בהרבה מ-VQE). |
| חסם אנרגיה מוערכת | ב-VQE, אומדני אנרגיה אינם חסומים ועלולים להיות נמוכים מהערכים המינימליים האמיתיים עקב רעש. | תהליך אומדן האנרגיה ב-SQD תמיד מייצר חסם עליון לאנרגיית מצב היסוד, והאנרגיה המוערכת לעולם לא תהיה נמוכה מאנרגיית מצב היסוד האמיתית. |
| סבילות לרעש | אומדן אנרגיית VQE רגיש לרעש ממחשבים קוונטיים לפני סבילות לתקלות. | ל-SQD יש סבילות מובנית לרעש. מחשבים קוונטיים לפני סבילות לתקלות יכולים לייצר דגימות רועשות. גם אם נכלול את הדגימות האלה בתת-המרחב, הלכסון הבא יכול לדכא דגימות אלה על ידי הצבת המשרעות שלהן לאפס. כמו כן, נדון בשיטה הנקראת שחזור תצורה בהקשר ל-SQD שמשפרת את סבילות SQD לרעש עוד יותר. |
6. סיכום
-
ב-SQD, מחשב קוונטי מייצר דגימות ומחשב קלאסי מטיל Hamiltonian על תת-מרחב הנפרס על ידי הדגימות ומלכסן אותו לחישוב ערכים עצמיים ווקטורים עצמיים.
-
הדגימות שנוצרו צריכות להיות מתמיכת מצב המטרה (היסוד).
-
בהתאם לבעיה, זרימת הכנת המצב הקוונטי וייצור הדגימות יכולה להיות איטרטיבית או לא-איטרטיבית.
-
SQD עובד בצורה הטובה ביותר עבור פונקציות גל דלילות. פונקציית גל רחבה תדרוש תת-מרחב גדול לפתרונות מדויקים, מה שהופך את פעולת ההטלה והלכסון הקלאסית ליקרה.
-
ל-SQD יש מספר יתרונות על VQE כגון עלות מדידה נמוכה יותר וחסם עליון לאנרגיית מצב היסוד המוערכת, מה שהופך אותו לניתן יותר לסקלאביליות.
מקורות
[1] J. Robledo-Moreno et al., "Chemistry Beyond Exact Solutions on a Quantum-Centric Supercomputer" (2024). arXiv:quant-ph/2405.05068.