לימוד מצבים קוונטיים רועשים באמצעות צללים קלאסיים
הערכת שימוש: 34 דקות על מעבד Heron r2 (הערה: זו הערכה בלבד. זמן הריצה שלך עשוי להשתנות.)
מטרות הלמידה
-
איסוף מדידות אקראיות במעבד קוונטי של IBM® מתוך Julia ושמירתן לניתוח מאוחר יותר
-
בדיקת נתוני המדידה לאיתור qubits ושערים פגומים לפני הלמידה
-
התאמת מודל matrix product operator (MPO) של מצב רועש לצללים קלאסיים
-
אימות המודל על מדידות שהוחזקו בצד והשוואתו למעגל האידיאלי
דרישות קדם
-
צללים קלאסיים, כפי שהוצגו במדריך Shadow tomography of the Greenberger-Horne-Zeilinger (GHZ) state
-
מטריצות צפיפות ומצבים מעורבים, שנכללים ב-Basics of quantum information
-
הרצת מעגלים מתוך Julia באמצעות
Qiskit.jlו-QiskitIBMRuntime.jl, כפי שהוצג במדריך Simulate time evolution of the transverse-field Ising model
רקע
במעבד קוונטי אמיתי, רעש הופך את המצב הטהור שהמעגל נועד להכין למצב מעורב . טומוגרפיה קוונטית מלאה של המצב יכולה לשחזר את , אבל מספר המדידות שהיא דורשת גדל אקספוננציאלית עם מספר ה-qubits. Votto ושות' [1] למדו במקום זאת מודל קומפקטי של עבור עד 96 qubits מתוך מדידות אקראיות. המדריך הזה עוקב אחר תהליך העבודה שלהם.
במדידה אקראית [2], כל qubit מסובב על ידי אונitary אקראי בלתי תלוי ואז נמדד בבסיס החישובי. הגרלה אחת של הסיבובים נקראת הגדרת מדידה, וכל הגדרה חוזרת על עצמה במשך shots. shot עם ביטי תוצאה נותן את הצל הקלאסי [3]
שהממוצע שלו על פני הגדרות ו-shots הוא . מדריך הדרישות המוקדמות מגריל כל משלושת בסיסי פאולי; המדריך הזה, כמו המאמר, מגריל אותם באופן אחיד מכל האונitaries החד-qubitיים (אקראי לפי Haar), ואותה נוסחה חלה.
צללים מעריכים תכונות של כמה qubits בכל פעם. המאמר משלב אותם ל-matrix product operator (MPO), שכותב את מטריצת הצפיפות כשרשרת של טנזורים קטנים, אחד לכל qubit; מצבים רועשים עם מתאמים קצרי טווח זקוקים רק לקשרים קטנים בין טנזורים שכנים. בדומה לאלגוריתם חבורת הנרמול של מטריצת הצפיפות (DMRG), הלומד סורק לאורך השרשרת ומעדכן טנזור אחד בכל פעם, כך שהמודל מתאים לצללים בחלון של qubits שמרכזו בטנזור הזה (משוואה 4 במאמר). ממד הקשר נשאר קבוע במהלך העדכונים האלה, ולכן הלומד אף פעם לא קוטם את המודל. מכיוון שהנתונים נכנסים רק דרך החלונות האלה, מספר ההגדרות הנדרש לא גדל עם אורך השרשרת.
ההגדרות מחולקות לקבוצת אימון ולקבוצת בדיקה. על קבוצת הבדיקה, המאמר מעריך את נאמנות המקסימום בין למודל ,
מדידה ישירה של תדרוש מספר מדידות אקספוננציאלי. במקום זאת, המאמר מניח את תנאי הפירוק המקורב (AFC): מתאמים ב- דועכים בתוך כמה qubits, ולכן חפיפות טוהר גלובליות מתפרקות לגורמים על בלוקים של qubits שכנים. הטוהר נותן גם את אנטרופיית Rényi-2 , שמודדת עד כמה המצב מעורב.
המאמר מכין את מצב kicked-Ising בעומק
על 96 qubits של ibm_brisbane, מעבד Eagle, עם 2,048 הגדרות של 1,024 shots עבור . איור 1(c,d) במאמר מדווח על שתי תוצאות עבור :
-
המודל הנלמד מגיע ל- עם המצב הניסויי ב-, הרבה מעל החפיפה של המצב האידיאלי עם הניסוי.
-
האנטרופיה גדלה באופן לינארי, , והאנטרופיה של המודל מתאימה לאומדן בלתי תלוי מתוך קבוצת הבדיקה.
המדריך הזה בודק את שתי התוצאות, תחילה בסימולציה של שמונה qubits שבה התשובות המדויקות ידועות, ואז בהרצה חדשה של 96 qubits על ibm_fez, מעבד Heron r2. הלומד הוא מימוש עצמאי ב-Julia של המשוואות במאמר ובנספח שלו.
דרישות
המדריך הזה דורש macOS או Linux, כי Qiskit.jl עדיין לא תומך ב-Windows (Qiskit.jl issue #15). תצטרך גם את הדברים הבאים:
-
Julia 1.11, מתוך דף ההורדות של Julia או באמצעות
juliaup add 1.11, וחבילתIJulia:julia -e 'using Pkg; Pkg.add("IJulia")' -
עבור דוגמת החומרה, חשבון IBM Quantum® Platform עם גישה ל-QPU שיש לו לפחות 96 qubits, ו-אישורים שמורים. בלי חשבון, אפשר להריץ את דוגמת החומרה מתוך המדידות השמורות של ההרצה על
ibm_fezשהפיקה את התוצאות במדריך הזה. שאר הקטעים רצים בלי חשבון.
המחברת משתמשת ב-Qiskit.jl וב-QiskitIBMRuntime.jl כדי לבנות ולהריץ מעגלים, ב-RandomMeas.jl [4] למדידות אקראיות (הוא מספק גם את ITensors.jl ו-ITensorMPS.jl), וב-NPZ.jl, JSON.jl ו-Plots.jl. המדריך הזה נבדק עם Qiskit.jl 0.6.1, QiskitIBMRuntime.jl 0.3.2 ו-RandomMeas.jl 0.3.1.
יש שתי דרכים להגדיר את הסביבה:
-
אפשרות 1: התקנת הגרסאות התואמות העדכניות ביותר של החבילות לסביבה זמנית. הרץ את התא הבא בלי שינויים.
-
אפשרות 2: שחזור מדויק של הסביבה שנבדקה. הגדר
download_toml_files = trueבתא הבא. התא מוריד אתProject.tomlו-Manifest.tomlמתוך מאגר התיעוד לתיקייהenv_tutorial/classical-shadows/לצד המחברת הזו, ואז מתקין את הגרסה המדויקת של כל חבילה שה-manifest מתעד, כולל תלויות עקיפות. לפרטים, ראה את התיעוד של Julia על הקבצים האלה.
using Pkg
using Downloads

download_toml_files = false

if !download_toml_files
    # Option 1: Install the latest compatible versions into a temporary environment
    Pkg.activate(mktempdir(); io=devnull)
    Pkg.add([
        PackageSpec(name="Qiskit", version="0.6"),
        PackageSpec(name="QiskitIBMRuntime", version="0.3"),
        PackageSpec(name="RandomMeas", version="0.3"),
        PackageSpec(name="NPZ"),
        PackageSpec(name="JSON"),
        PackageSpec(name="Plots"),
    ]; io=devnull)
else
    # Option 2: Install the exact tested versions recorded in Project.toml and Manifest.toml
    base_url = "https://raw.githubusercontent.com/Qiskit/documentation/main/docs/tutorials/assets/classical-shadows/julia"
    env_dir = joinpath(@__DIR__, "env_tutorial", "classical-shadows")
    mkpath(env_dir)
    for file in ("Project.toml", "Manifest.toml")
        Downloads.download("$base_url/$file", joinpath(env_dir, file))
    end
    Pkg.activate(env_dir; io=devnull)
    Pkg.instantiate(; io=devnull)
end
הגדרה
using RandomMeas  # also loads ITensors and ITensorMPS
using Qiskit, QiskitIBMRuntime
using Random, LinearAlgebra, Statistics
using Downloads, SHA, NPZ, JSON, Plots

# Download the helper module that implements the learner, unless a copy exists
docs_url = "https://raw.githubusercontent.com/Qiskit/documentation/main"
helper_file = joinpath(@__DIR__, "env_tutorial", "classical-shadows", "mpo_learning.jl")
if !isfile(helper_file)
    mkpath(dirname(helper_file))
    helper_url = "$docs_url/docs/tutorials/assets/classical-shadows/julia/mpo_learning.jl"
    Downloads.download(helper_url, helper_file)
end
include(helper_file)
using .ShadowMPOLearning
BLAS.set_num_threads(1)  # the learner multiplies many small matrices
מודול העזר mpo_learning.jl, שתא ההגדרה מוריד, מממש את הלומד. המדריך קורא ממנו לפונקציות הבאות:
| פונקציה | מטרה |
|---|---|
kicked_ising_reference(N, D; depolarization) | MPO מדויק של מצב kicked-Ising האידיאלי, או של המצב אחרי רעש דה-פולריזציה מקומי |
split_settings(group; seed, train_fraction) | הקצאה אקראית של הגדרות מדידה לקבוצות אימון ובדיקה (חצי כל אחת כברירת מחדל) |
training_marginals(train; ell, prior) | אומדני צללים של כל חלון למידה, מתוך הגדרות האימון בלבד |
fitted_prior(ideal, train) | prior למדידות אקראיות משותפות (CRM), מותאם לטוהר שנמדד של כל חלון, כמו במאמר |
learn_mpo(marginals, N; ell, maxbond, sweeps) | סריקה של עדכון האתר היחיד מהמאמר לאורך השרשרת, החל מהמצב המעורב המקסימלי |
max_fidelity(a, b), mpo_overlap(a, b) | מדויק ו- בין שני MPOs |
afc_estimate, afc_statistics, afc_prefix_curve | אומדני AFC של ושל מתוך הגדרות הבדיקה, עם פסי שגיאה של jackknife |
הלומד שומר את ה-MPO בבסיס פאולי. זה שומר על המודל הרמיטי עם עקבה אחת, אבל לא מכריח אותו להיות חיובי למחצה, ולכן המחברת מדווחת עד כמה הערכים העצמיים שלו נעשים שליליים.
דוגמת סימולטור בקנה מידה קטן
התחל במערכת קטנה מספיק כדי לחשב הכול במדויק: מצב kicked-Ising בעומק אחד על שמונה qubits, עם רעש דה-פולריזציה מקומי של 12% כדי לדמות את החומרה. מכיוון שהמצב הרועש ידוע, אפשר להשוות אליו ישירות את המודל הנלמד.
שלב 1: מיפוי קלטים קלאסיים לבעיה קוונטית
הפונקציה kicked_ising_reference מחזירה את המצב המדויק כ-MPO. עם depolarization=0.12, וקטור בלוך של כל qubit מתכווץ ב-12% אחרי המעגל.
N = 8
ideal = kicked_ising_reference(N, 1)
rho = kicked_ising_reference(N, 1; depolarization=0.12)
println("Purity of the noisy state: ", round(mpo_overlap(rho, rho), digits=3))
println("F_max between the noisy and ideal states: ", round(max_fidelity(rho, ideal), digits=3))
Purity of the noisy state: 0.327
F_max between the noisy and ideal states: 0.56
שלב 2: אופטימיזציה של הבעיה להרצה על חומרה קוונטית
הדוגמה הזו דוגמת תוצאות מדידה באופן קלאסי, ולכן אין מעגל לבצע לו transpile. דוגמת החומרה מכסה את השלב הזה.
שלב 3: הרצה באמצעות פרימיטיבים של Qiskit
השתמש ב-RandomMeas.jl כדי להגריל 2,048 הגדרות מדידה אקראיות לפי Haar ולדגום 256 shots מכל אחת, ואז חלק את ההגדרות באופן שווה לקבוצות אימון ובדיקה. חלק לפי הגדרה ולא לפי shot: shots מאותה הגדרה חולקים את הסיבובים שלה, ולכן הם אינם בלתי תלויים.
Random.seed!(20260921)
sites = siteinds("Qubit", N)
settings = [LocalUnitaryMeasurementSetting(N; site_indices=sites, ensemble=Haar) for _ in 1:2048]
measurements = MeasurementGroup(to_itensor_mpo(rho, sites), settings, 256)
split = split_settings(measurements; seed=20260921)
println(length(split.train_ids), " training settings, ", length(split.test_ids), " testing settings")
1024 training settings,
1024 testing settings
שלב 4: עיבוד סופי והחזרת התוצאה בפורמט הקלאסי הרצוי
למד את המודל עם הפרמטרים של המאמר לעומק אחד: חלונות שמתרחבים qubits מכל צד של הטנזור המעודכן, ממד קשר של 4, ו-20 סריקות החל מהמצב המעורב המקסימלי. הסריקה הראשונה מעדכנת זוגות שכנים של טנזורים, מה שמאפשר לממד הקשר לגדול מ-1 ל-4; כל סריקה מאוחרת יותר מעדכנת טנזור אחד בכל פעם בממד הקשר הקבוע הזה.
כדי להפחית את הרעש הסטטיסטי של הצללים, המאמר משתמש ב-מדידות אקראיות משותפות (CRM) [5]. לכל הגדרה, הוא מחסיר את הצל הממוצע שהיה מפיק ניחוש מקדים של המצב באותה הגדרה, ואז מוסיף בחזרה את הערך המדויק של ה-prior. התיקון מתמצע לאפס, ולכן ה-prior משנה את גודל השגיאה הסטטיסטית אבל לא את מה שמוערך. כאן ה-prior הוא המצב האידיאלי עם דה-פולריזציה מקומית של 10%, קרוב ל-12% האמיתי. בחומרה, רמת הרעש אינה ידועה, ולכן דוגמת החומרה מתאימה את ה-prior לטוהר שנמדד במקום זאת, כמו במאמר.
prior = kicked_ising_reference(N, 1; depolarization=0.10)
marginals = training_marginals(split.train; ell=2, prior)
fit = learn_mpo(marginals, N; ell=2, maxbond=4, sweeps=20)
sigma = fit.model
plot([h.sweep for h in fit.history], [h.local_loss for h in fit.history];
    xlabel="sweep", ylabel="mean squared residual", label="training windows",
    size=(680, 320), left_margin=5Plots.mm, bottom_margin=5Plots.mm)
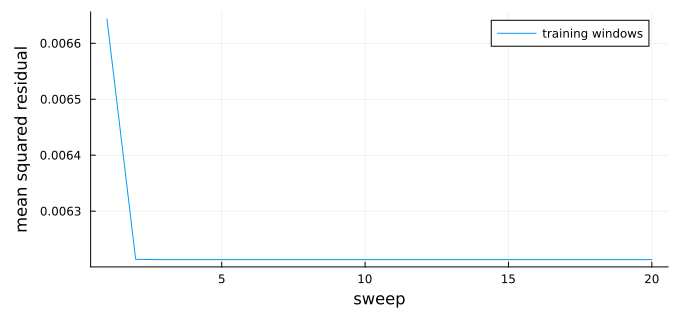
השארית מודדת עד כמה החלונות של המודל רחוקים מצללי האימון. היא יורדת כשעדכוני האתר היחיד מתחילים, בסריקה השנייה, ואז נשארת בערך קבועה במקום להגיע לאפס, כי הצללים מכילים רעש סטטיסטי שמודל עם ממד קשר קטן אינו יכול לשחזר.
מכיוון שהמצב הזה ידוע, אפשר להשוות אליו במדויק את המודל הנלמד, וגם להשוות אליו את שני הניחושים הפשוטים ביותר: ה-prior של CRM והמצב האידיאלי.
eigenvalues = eigvals(Hermitian(dense_operator(sigma)))
println("F_max with the noisy state")
println("  learned model: ", round(max_fidelity(rho, sigma), digits=3))
println("  CRM prior:     ", round(max_fidelity(rho, prior), digits=3))
println("  ideal state:   ", round(max_fidelity(rho, ideal), digits=3))
println("Most negative eigenvalue of the model: ", round(minimum(eigenvalues), digits=4))
println("Total negative eigenvalue weight:      ", round(-sum(min.(eigenvalues, 0)), digits=4))
F_max with the noisy state
learned model: 0.993
  CRM prior:     0.911
  ideal state:   0.56
Most negative eigenvalue of the model: -0.0076
Total negative eigenvalue weight:      0.0348
המודל הנלמד קרוב יותר למצב הרועש מאשר ה-prior או המצב האידיאלי, כך שהוא למד את הרעש מתוך הנתונים. הערכים העצמיים השליליים הקטנים שלו נובעים ממספר המדידות הסופי.
בחומרה, המצב אינו ידוע, ולכן אתה מעריך את מתוך הגדרות הבדיקה במקום זאת. AFC מפצל את השרשרת לבלוקים של qubits ומקרב את הטוהר באמצעות
ואת באותו יחס של חפיפות מקומיות. עם , שני הבלוקים מכסים את כל שמונת ה-qubits והנוסחה מדויקת; עם , היא נשענת על הנחת הפירוק לגורמים. פסי השגיאה של ה-jackknife, שמשמיטים הגדרת בדיקה אחת בכל פעם, מכסים רק את השגיאה הסטטיסטית של נתוני הבדיקה, ולא את אקראיות האימון או את קירוב ה-AFC.
for k in (2, 4)
    estimate = afc_estimate(sigma, split.test; k, statistics=afc_statistics(split.test, k; prior))
    println("k = $k: held-out F_max = ", round(estimate.fidelity, digits=3), " ± ",
        round(estimate.fidelity_sem, digits=3))
end
println("Exact F_max:              ", round(max_fidelity(rho, sigma), digits=3))
k = 2: held-out F_max = 0.966
± 0.036
k = 4: held-out F_max =
0.958 ± 0.049
Exact F_max:              0.993
שתי האמידות על נתונים שלא היו באימון מסכימות עם הערך המדויק בתוך פסי השגיאה שלהן.
דוגמה בקנה מידה גדול על חומרה
עכשיו מריצים את הניסוי על שרשרת של 96 qubits ב-ibm_fez, מעבד Heron r2. כמו ibm_brisbane, יש לו מפת צימוד heavy-hex ורמת רעש דומה.
איסוף הנתונים דורש 1,024 משימות Sampler וכ-34 דקות של זמן QPU. אם אין לכם גישה ל-QPU עם 96 qubits לפחות, או שהתור ארוך, הריצו את דוגמת החומרה מתוך המדידות שנרשמו ב-ibm_fez ב-27 בספטמבר 2026, שהפיקו את התוצאות המוצגות במדריך הזה. עם use_saved_data = true, המחברת מורידה את המדידות האלה (15 MB) מ-Zenodo [6] בשלב 1 ומדלגת על שליחת המשימות בשלב 3. כדי לאסוף נתונים משלכם, הגדירו אותו ל-false.
use_saved_data = true; # set to false to collect new measurements on hardware
שלב 1: מיפוי קלטים קלאסיים לבעיה קוונטית
כל הגדרה דורשת מעגל אחד: מעגל ה-kicked-Ising, שער על כל qubit עבור , ומדידה של כל qubit. דגימה של , כאשר , ו- אחידים ב-, הופכת את לאקראי לפי Haar. הפונקציה u3_matrix מחזירה את המטריצה של , שבה משתמש שלב 4.
התקציב הוא 1,024 הגדרות של 1,024 shots, חצי ממספר ההגדרות במאמר, מחולקות שווה בשווה בין אימון לבדיקה. עם נתונים שמורים, התא טוען את הזוויות שנרשמו. אחרת, הוא מגריל זוויות חדשות ושומר אותן לפני שאתם שולחים משהו, כי אי אפשר לנתח את התוצאות בלעדיהן. אם הקובץ כבר קיים, התא טוען אותו, כך שהזוויות עדיין תואמות את התוצאות השמורות אחרי שמפעילים מחדש את ה-session.
"Matrix of the U(θ, ϕ, λ) gate, as used by `qc.u` in Qiskit."
u3_matrix(θ, ϕ, λ) = [cos(θ/2)              -exp(im*λ)*sin(θ/2);
                      exp(im*ϕ)*sin(θ/2)    exp(im*(ϕ + λ))*cos(θ/2)]

"Angles (θ, ϕ, λ) for which `u3_matrix(θ, ϕ, λ)` is a Haar-random unitary."
random_u3_angles() = (2asin(sqrt(rand())), 2π*rand(), 2π*rand())

N_hw, NU_hw, NM_hw = 96, 1024, 1024
data_directory = joinpath(@__DIR__, "classical-shadows-data")
saved_file = joinpath(data_directory, "ibm-fez-run.npz")
run_directory = joinpath(data_directory, "new-run")
settings_file = joinpath(run_directory, "settings.npz")
if use_saved_data
    saved_url = "https://zenodo.org/records/24116174/files/ibm-fez-run.npz?download=1"
    saved_sha256 = "c42f4d8d42e5083e9e152b4fec0846884ebe3be003e5ab528deebf4f00c9fe50"
    if !isfile(saved_file)
        mkpath(data_directory)
        println("Downloading the saved ibm_fez run (15 MB)...")
        Downloads.download(saved_url, saved_file * ".part")
        mv(saved_file * ".part", saved_file)
    end
    bytes2hex(open(sha256, saved_file)) == saved_sha256 ||
        error("$saved_file is incomplete or corrupted; delete it and run this cell again")
    saved_run = npzread(saved_file)
    angles = saved_run["angles"]
elseif isfile(settings_file)
    angles = npzread(settings_file)["angles"]
else
    mkpath(joinpath(run_directory, "outcomes"))
    Random.seed!(20260927)
    angles = Array{Float64}(undef, NU_hw, N_hw, 3)
    for r in 1:NU_hw, i in 1:N_hw
        angles[r, i, :] .= random_u3_angles()
    end
    npzwrite(settings_file, Dict("angles" => angles))
end
println("Measurement settings: ", size(angles, 1), " × ", size(angles, 2), " qubits")
Measurement settings: 1024
× 96 qubits
שלב 2: אופטימיזציה של הבעיה להרצה על חומרה קוונטית
שרשרת טובה רק כמו ה-qubit הגרוע ביותר שלה, לכן בחרו בעצמכם את 96 ה-qubits הפיזיים. הפונקציה transpile של Qiskit.jl עדיין לא מקבלת layout התחלתי קבוע, ובבדיקה על ibm_phoenix, ה-layout שהיא בחרה כלל qubit עם שגיאת קריאה של 51%. השרשרת הבאה היא המסלול של 96 qubits במפת הצימוד של ibm_fez שה-layout המודע לשגיאות של הפונקציה transpile של Qiskit בפייתון (עם optimization_level=3) בחר מתוך נתוני הכיול של 27 בספטמבר 2026. שגיאת הקריאה הממוצעת שלה היא 1.6%, אבל ללטיס heavy-hex יש מעט מסלולים של 96 qubits, ובמסלול הזה יש את qubit 35, עם שגיאת קריאה של 15%. הכיולים משתנים, לכן בחרו שרשרת חדשה מתוך נתוני הכיול הנוכחיים לפני שאתם מריצים ביום אחר או על QPU אחר.
כדי לשמור על השרשרת הזו, כתבו את המעגלים ישירות בשערים native במקום לבצע להם transpile. שער שווה ל- עד כדי פאזה גלובלית. הפירוק הזה מכסה גם את הסיבובים האקראיים וגם את ה-kick . השער שווה לשער CZ ואחריו על שני ה-qubits, עד כדי פאזה גלובלית. מכיוון ששערי האלה אלכסוניים, הם מתחלפים עם שערי ה-CZ, ולכן כל qubit צובר אחד לכל קשר לפני סיבוב המדידה שלו.
num_device_qubits = 156
# Physical qubits of ibm_fez, in IBM numbering, forming the chain
chain_physical = [
    2, 3, 4, 5, 6, 7, 8, 9, 10, 11, 12, 13, 14, 15, 19, 35, 34, 33, 39, 53, 54, 55, 59, 75, 74,
    73, 79, 93, 94, 95, 99, 115, 114, 113, 119, 133, 132, 131, 130, 129, 128, 127, 137, 147, 146,
    145, 144, 143, 136, 123, 124, 125, 117, 105, 106, 107, 108, 109, 110, 111, 98, 91, 90, 89,
    88, 87, 86, 85, 77, 65, 66, 67, 68, 69, 70, 71, 58, 51, 50, 49, 48, 47, 46, 45, 37, 25, 24,
    23, 22, 21, 36, 41, 42, 43, 56, 63]
chain = chain_physical .+ 1  # Qiskit.jl numbers qubits from 1

"Apply U(θ, ϕ, λ) to qubit q with native gates: rz(λ), sx, rz(θ + π), sx, rz(ϕ + π)."
function native_u!(qc, q, θ, ϕ, λ)
    qc.rz(λ, q)
    qc.sx(q)
    qc.rz(θ + π, q)
    qc.sx(q)
    qc.rz(ϕ + π, q)
end

"Kicked-Ising circuit on `chain`, then the rotations of one setting and a measurement."
function native_setting_circuit(chain, angles, num_device_qubits)
    n = length(chain)
    qc = QuantumCircuit(num_device_qubits, n)
    for q in chain
        native_u!(qc, q, π/4, -π/2, π/2)       # e^{-iπ/8 X}
    end
    for i in 1:n-1
        qc.cz(chain[i], chain[i + 1])          # e^{iπ/4 ZZ}, up to the S† gates below
    end
    for (i, q) in enumerate(chain)
        bonds = (i > 1) + (i < n)
        qc.rz(-π/2 * bonds, q)                 # one S† per bond
        native_u!(qc, q, angles[i, 1], angles[i, 2], angles[i, 3])
        qc.measure(q, i)                       # outcome of chain qubit i goes to bit i
    end
    qc
end

circuits = [native_setting_circuit(chain, angles[r, :, :], num_device_qubits) for r in 1:NU_hw]
println(length(circuits), " circuits, each with ", count(inst -> inst.name == "cz", circuits[1].data), " CZ gates")
1024 circuits, each with
95 CZ gates
שלב 3: הרצה באמצעות פרימיטיבים של Qiskit
QiskitIBMRuntime.jl מריץ מעגל אחד לכל משימת Sampler, ולכן איסוף הנתונים דורש 1,024 משימות. התא הבא שומר עד 32 משימות בתור ושומר את התוצאות של כל הגדרה ברגע שהמשימה שלה מסתיימת. כל shot מוחזר כווקטור של ביטים, שבו איבר הוא התוצאה של qubit בשרשרת.
חובה לאחזר את התוצאות באותו session ששלח את המשימות, כי QiskitIBMRuntime.jl עדיין לא יכול לחפש משימה לפי המזהה שלה (qiskit-ibm-runtime-c issue #28). אם משימה נכשלת, התא מוציא אזהרה וממשיך. אם ה-session נעצר, הריצו שוב את שלבים 1 עד 3. הרצה חוזרת של התא שולחת רק את ההגדרות שהתוצאות שלהן חסרות. עם use_saved_data = true, התא לא שולח כלום.
outcome_file(r) = joinpath(run_directory, "outcomes", "setting_$(lpad(r, 4, '0')).npz")

"Save the outcomes of setting `r` as a (shots × N) matrix of 0/1 values."
function save_outcomes(r, job)
    try
        samples = get_sampler_job_results(job, service)
        bits = UInt8.(permutedims(reduce(hcat, samples)))
        npzwrite(outcome_file(r), Dict("bits" => bits))
    catch err
        @warn "Setting $r failed and was not saved; run this cell again to resubmit it" err
    end
end

if use_saved_data
    println("Using the saved ibm_fez measurements; no jobs submitted")
else
    backend_name = "ibm_fez"
    service = Service()  # uses the credentials saved on this computer
    backend = only(b for b in backend_search(service) if b.name == backend_name)
    open(joinpath(run_directory, "metadata.json"), "w") do io
        JSON.print(io, Dict("backend" => backend_name, "N" => N_hw, "depth" => 1, "settings" => NU_hw,
                            "shots" => NM_hw, "chain" => chain_physical), 2)
    end
    in_flight = []
    for r in 1:NU_hw
        isfile(outcome_file(r)) && continue
        push!(in_flight, (r, run_sampler_job(service, backend, circuits[r], NM_hw)))
        length(in_flight) >= 32 && save_outcomes(popfirst!(in_flight)...)
    end
    foreach(job -> save_outcomes(job...), in_flight)
    println("Saved outcomes: ", count(r -> isfile(outcome_file(r)), 1:NU_hw), " of ", NU_hw, " settings")
end
Using the saved ibm_fez measurements; no jobs submitted
שלב 4: עיבוד לאחר והחזרת התוצאה בפורמט הקלאסי הרצוי
השלב הזה קורא רק נתונים שמורים: את ההרצה שהורדתם של ibm_fez אם use_saved_data הוא true, או אחרת את הקבצים ששלב 3 כתב. לכן אפשר להריץ אותו ב-session חדש בלי לשלוח משימות (הריצו קודם את תא ה-Setup, את תא use_saved_data ואת שלב 1). הקובץ שהורד שומר את 96 התוצאות של כל shot ארוזות ב-12 בייטים, הביט המשמעותי ביותר קודם, ולכן הטוען פורס אותן. RandomMeas.jl מסמן תוצאות ב-1 ו-2, ולכן הטוען גם מוסיף 1 לכל ביט.
"Build a `MeasurementGroup` from the angles and a function `outcomes(r)` that returns
the (shots × N) 0/1 outcomes of setting `r`."
function measurement_group(angles, outcomes)
    settings_count, n = size(angles, 1), size(angles, 2)
    sites = siteinds("Qubit", n)
    data = map(1:settings_count) do r
        rotations = Array{ComplexF64}(undef, n, 2, 2)
        for i in 1:n
            rotations[i, :, :] = u3_matrix(angles[r, i, :]...)
        end
        MeasurementData(Int.(outcomes(r)) .+ 1;
            measurement_setting=LocalUnitaryMeasurementSetting(rotations; site_indices=sites))
    end
    MeasurementGroup(data)
end

if use_saved_data
    packed = saved_run["outcomes"]  # settings × shots × 12 bytes
    # Bit i of a shot is in byte (i - 1) ÷ 8 + 1, most significant bit first
    unpack(r) = [(packed[r, s, (i - 1) ÷ 8 + 1] >> (7 - (i - 1) % 8)) & 0x01
                 for s in 1:size(packed, 2), i in 1:N_hw]
    group_hw = measurement_group(angles, unpack)
else
    group_hw = measurement_group(angles, r -> npzread(outcome_file(r))["bits"])
end
println(group_hw.NU, " settings × ", group_hw.NM, " shots on ", group_hw.N, " qubits")
1024 settings ×
1024 shots on 96 qubits
לפני הלמידה, בדקו את הנתונים. qubit שבור או שער מכויל גרוע הופכים את המצב הנמדד למעורב הרבה יותר סביבם, ויכולים לגרום ללומד להתבדר. הטוהר של כמה qubits שכנים הוא מדד השוואה ללא מודל לרעש הזה: הפונקציה get_purity מ-RandomMeas.jl מעריכה את עבור תת-מערכת על ידי השוואת זוגות של shots מאותה הגדרה. חשבו את אנטרופיית Rényi-2, , של כל חלון של שישה qubits שכנים, והשוו אותה לאותו חלון במצב האידיאלי. הערך האידיאלי אינו אפס, כי כל חלון שזור עם שאר השרשרת; רעש מגדיל אותו, ו-qubit שבור דוחף כל חלון שמכיל אותו לעבר המקסימום של שש.
ideal_hw = kicked_ising_reference(N_hw, 1)
width = 6
starts = 1:N_hw - width + 1
window_entropy(rho, w) = -log2(mpo_overlap(segment_mpo(rho, w), segment_mpo(rho, w)))
measured_entropy = [-log2(get_purity(group_hw, collect(j:j + width - 1))) for j in starts]
ideal_entropy = [window_entropy(ideal_hw, j:j + width - 1) for j in starts]
worst = argmax(measured_entropy)
println("S₂ of six-qubit windows: median ", round(median(measured_entropy), digits=2), "; highest ",
    round(measured_entropy[worst], digits=2), " (chain positions ", worst, " to ", worst + width - 1, ")")
println("Ideal state: ", round(minimum(ideal_entropy), digits=2), " to ", round(maximum(ideal_entropy), digits=2))
plot(starts, measured_entropy; marker=:circle, markersize=2, label="measured",
    xlabel="first chain position of the window", ylabel="S₂ of six qubits", ylims=(0, width),
    legend=:topright, size=(800, 280), left_margin=5Plots.mm, bottom_margin=5Plots.mm)
plot!(starts, ideal_entropy; linestyle=:dash, label="ideal state")
S₂ of six-qubit windows: median 0.9
; highest 1.43 (chain positions 30 to 35)
Ideal state: 0.19 to 0.39
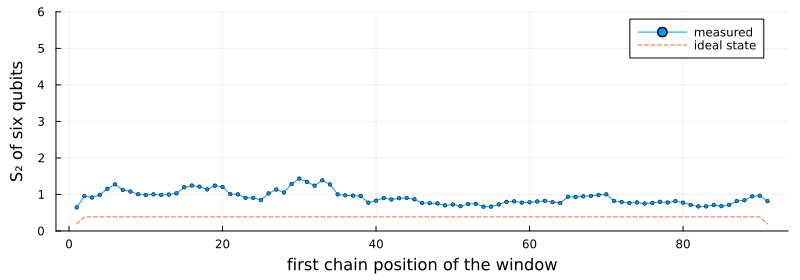
כל חלון מעורב יותר מהמצב האידיאלי, בכחצי ביט עד ביט אחד, והקטע הרועש ביותר נמצא סביב מיקומים 30 עד 35 בשרשרת. אף חלון לא מתקרב למקסימום של שש, ולכן אף qubit לא שבור, והניתוח משתמש בכל שרשרת 96 ה-qubits. אילו לחלונות מסוימים הייתה אנטרופיה קרובה לשש, הייתם מסירים את ה-qubit המשותף לחלונות האלה ולומדים את החלק הארוך ביותר של השרשרת בלעדיו.
אותם טוהרים קובעים את ה-prior של CRM. לכל חלון, fitted_prior לוקח את המצב האידיאלי ומתאים עוצמת depolarizing מקומית כך שהטוהר שלו יתאים לטוהר שנמדד בהגדרות האימון, כמו במאמר.
הפונקציה learn_and_validate בתא הבא מבצעת את שאר הניתוח. היא לומדת את המודל מהגדרות האימון, ואז מעריכה את ואת על הגדרות הבדיקה עבור ה-qubits הראשונים בשרשרת, בצעדים של 12. אלה הגדלים באיור 1(c,d) במאמר. המצב האידיאלי מוערך על אותם נתוני בדיקה כקו בסיס.
התא מריץ את הפונקציה עם ואז חוזר עליה עם ו- כדי לראות כמה משנה גודל חלונות הלמידה. ממד הקשר (bond dimension) יכול להיות לכל היותר , ולכן לומד מצב מכפלה: כל qubit בנפרד, בלי מתאמים בין qubits.
function learn_and_validate(group; ideal, ell=2, k=3, sizes=12:12:group.N, seed=20260921, train_fraction=0.5)
    split = split_settings(group; seed, train_fraction)
    prior = fitted_prior(ideal, split.train)
    marginals = training_marginals(split.train; ell, prior)
    fit = learn_mpo(marginals, group.N; ell, maxbond=min(4, 4^ell), sweeps=20)
    last(fit.history).purity <= 1 ||
        @warn "The model has purity above one, so the fit diverged. Collect more settings or shots."
    statistics = afc_statistics(split.test, k; prior)
    learned = afc_prefix_curve(fit.model, statistics, split.test.NU; k, sizes)
    baseline = afc_prefix_curve(ideal, statistics, split.test.NU; k, sizes)
    model_entropy = [-log2(mpo_overlap(prefix_mpo(fit.model, n), prefix_mpo(fit.model, n))) for n in sizes]
    (; ell, fit, split, learned, baseline, model_entropy)
end

function plot_validation(results, title)
    n = [r.n for r in first(results).learned]
    # Marker, size, and line style per ℓ. The ℓ = 1 squares are small enough to sit inside the
    # ℓ = 2 circles, so both stay visible where the two curves overlap.
    style = Dict(2 => (:circle, 7, :solid), 1 => (:rect, 3.5, :dash), 0 => (:utriangle, 5, :dot))
    fidelity = plot(yscale=:log10, ylims=(1e-6, 1.5), legend=:bottomleft, xlabel="number of qubits N",
        ylabel="held-out F_max", title=title)
    entropy = plot(xlabel="number of qubits N", ylabel="Rényi-2 entropy S₂", legend=:topleft)
    held_out = first(results).learned
    # Draw every error bar before any marker, so the bars stay behind the symbols
    for (color, result) in enumerate(results)
        scatter!(fidelity, n, [r.fidelity for r in result.learned]; yerror=[r.fidelity_sem for r in result.learned],
            markersize=0, markerstrokecolor=color, label="")
    end
    scatter!(entropy, n, [r.entropy for r in held_out]; yerror=[r.entropy_sem for r in held_out],
        markersize=0, markerstrokecolor=:black, label="")
    for (color, result) in enumerate(results)
        marker, markersize, linestyle = style[result.ell]
        label = "learned model, ℓ = $(result.ell)"
        plot!(fidelity, n, [r.fidelity for r in result.learned]; color, marker, markersize, linestyle,
            markerstrokewidth=0, label)
        plot!(entropy, n, result.model_entropy; color, linestyle, linewidth=2, label)
    end
    plot!(fidelity, n, [r.fidelity for r in first(results).baseline]; marker=:diamond, markersize=5,
        linestyle=:dashdot, color=:black, label="ideal state")
    scatter!(entropy, n, [r.entropy for r in held_out]; marker=:circle, markersize=4, color=:black,
        label="held-out AFC estimate")
    plot(fidelity, entropy; layout=(1, 2), size=(1000, 400), left_margin=7Plots.mm, bottom_margin=7Plots.mm)
end

function summarize(result)
    final = last(result.learned)
    println("ℓ = ", result.ell, ", N = ", final.n, ": held-out F_max = ", round(final.fidelity, sigdigits=3), " ± ",
        round(final.fidelity_sem, sigdigits=2), " (ideal state: ", round(last(result.baseline).fidelity, sigdigits=2), ")")
    println("  S₂ = ", round(final.entropy, digits=2), " ± ", round(final.entropy_sem, digits=2),
        " held out; ", round(last(result.model_entropy), digits=2), " from the model")
    lowest = minimum(minimum(eigvals(Hermitian(operator_from_coefficients(local_coefficients(result.fit.model, w)))))
                     for w in unique(learning_windows(final.n, max(result.ell, 1))))
    println("  Most negative eigenvalue in any learning window: ", round(lowest, digits=4))
end

results_hw = [learn_and_validate(group_hw; ideal=ideal_hw, ell) for ell in (2, 1, 0)]
foreach(summarize, results_hw)
plot_validation(results_hw, "ibm_fez, 96-qubit chain")
ℓ = 2
, N = 96: held-out F_max = 0.591 ± 0.1 (ideal state: 0.0035)
  S₂ = 10.04 ± 0.28 held out; 10.21 from the model
  Most negative eigenvalue in any learning window: -0.0523
ℓ = 1, N = 96: held-out F_max = 0.554 ± 0.094 (ideal state: 0.0035)
  S₂ = 10.04 ± 0.28 held out; 10.26 from the model
  Most negative eigenvalue in any learning window: -0.0215
ℓ = 0, N = 96: held-out F_max = 6.18e-6 ± 1.1e-6 (ideal state: 0.0035)
  S₂ = 10.04 ± 0.28 held out; 32.01 from the model
  Most negative eigenvalue in any learning window: 0.0012
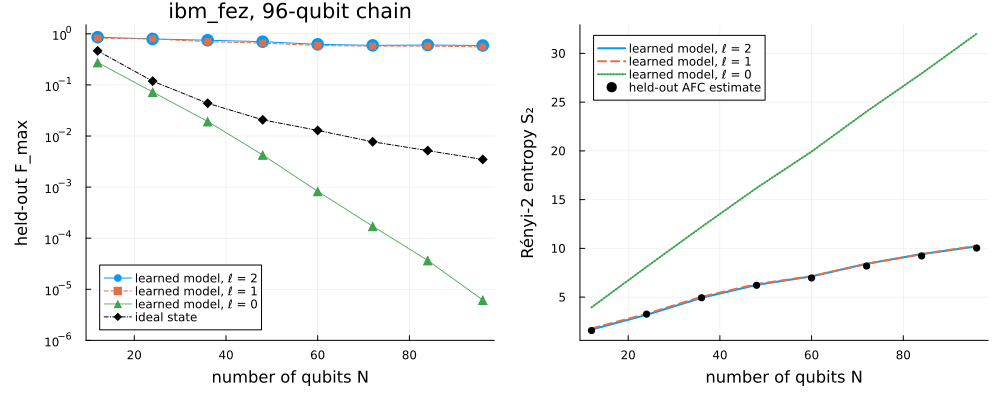
התוצאות משחזרות את שתי הטענות של המאמר על מעבד אחר:
-
המודל מתאר את הנתונים הרבה יותר טוב מהמצב האידיאלי. ב-, ה- של מודל על נתונים שלא היו באימון הוא 0.59 ± 0.10, לעומת 0.0035 למצב האידיאלי. המאמר מדווח על כ-0.75 ב-
ibm_brisbane. -
האנטרופיה של המודל מסכימה עם נתוני הבדיקה בכל . ב- היא 10.2 מהמודל ו-10.0 ± 0.3 מנתוני הבדיקה, כלומר , לעומת 0.14 עד 0.15 ב-
ibm_brisbaneהישן יותר.
ההשוואה בין גדלי החלונות מראה איפה המידע נמצא. עם , המודל כמעט טוב באותה מידה (), ולכן בנתונים האלה מתאמים מעבר לכמה qubits מוסיפים מעט. עם , מצב המכפלה מחמיץ את השזירות בין qubits שכנים: האנטרופיה שלו גדלה ל-32 במקום 10, וה- שלו יורד מהר אפילו יותר מזה של המצב האידיאלי, ל- ב-.
שימו לב למגבלות הבאות כשאתם קוראים את המספרים האלה:
-
חלוקת האימון. פסי השגיאה מכסים רק את השגיאה הסטטיסטית של נתוני הבדיקה. חלוקות אקראיות אחרות של אותן הגדרות נותנות בין 0.49 ל-0.59 ב- עבור .
-
המעבר האחרון. הלומד תמיד מחזיר את המודל מהמעבר (sweep) האחרון, ולכן נתוני הבדיקה אף פעם לא משפיעים על המודל.
-
חיוביות. המודל אינו מוגבל להיות חיובי למחצה; הערך העצמי השלילי ביותר שלו בחלון למידה הוא כ-. לכן ה- וה- שלו מתארים אופרטור, ולא תכונות מאושרות של מצב פיזי.
-
פירוק לגורמים. כל אמידה על נתונים שלא היו באימון נשענת על הנחת ה-AFC, שאותה המדידות עצמן אינן יכולות לאשר.
הצעדים הבאים
-
חזרו על הניסוי בעומק שניים עם הפרמטרים של המאמר לעומק הזה ( וממד קשר מרבי של 8), וקבעו כמה הגדרות מדידה הלומד צריך.
-
למדו עם עדכון שני האתרים במקום (
update=:two_siteב-training_marginalsוב-learn_mpo), שחותך את ממד הקשר אחרי כל צעד, וראו איך הוא מתנהג עם פחות הגדרות אימון. -
למדו בלי ה-prior של CRM (
prior=nothing) והשוו את הנאמנות על נתונים שלא היו באימון. -
החילו את אותו ניתוח על מדידות
ibm_brisbaneשפרסמו המחברים. -
קראו את הנספח של המאמר לגזירה של העדכון ושל אומדני ה-AFC.
-
חקרו פרוטוקולי מדידה אקראית נוספים ב-דוגמאות של
RandomMeas.jl.
מקורות
-
M. Votto, M. Ljubotina, C. Lancien, J. I. Cirac, P. Zoller, M. Serbyn, L. Piroli, and B. Vermersch, "Learning mixed quantum states in large-scale experiments", Phys. Rev. Lett. 136, 090801 (2026). arXiv:2507.12550
-
A. Elben, S. T. Flammia, H.-Y. Huang, R. Kueng, J. Preskill, B. Vermersch, and P. Zoller, "The randomized measurement toolbox", Nat. Rev. Phys. 5, 9 (2023). arXiv:2203.11374
-
H.-Y. Huang, R. Kueng, and J. Preskill, "Predicting many properties of a quantum system from very few measurements", Nat. Phys. 16, 1050 (2020). arXiv:2002.08953
-
A. Elben and B. Vermersch, "RandomMeas.jl: A Julia package for randomized measurements in quantum devices", Quantum 10, 2086 (2026). arXiv:2509.12749
-
B. Vermersch, A. Rath, B. Sundar, C. Branciard, J. Preskill, and A. Elben, "Enhanced estimation of quantum properties with common randomized measurements", PRX Quantum 5, 010352 (2024). arXiv:2304.12292
-
H. Zou, "Randomized measurements of a 96-qubit kicked-Ising state on ibm_fez", Zenodo (2026). doi:10.5281/zenodo.24116174